先定义数据单元 再讨论采购数量
一份体检报告既可能是一个完整年度的综合报告,也可能只是某次检查形成的单张报告单。两者表面上都是PDF或图片,训练任务却完全不同:前者可用于报告理解、风险归纳和跨年度变化分析;后者通常服务于OCR、字段抽取、异常识别或影像报告理解。如果在询价前没有确定样本单元、最小交付内容和预期任务,供应商就可能按“页”“张”“份”各自理解,最终数量看似够了,模型却缺少完整上下文。
因此,采购需求应从“模型要学会什么”反推数据定义。若目标是解析检验指标,最小单元可以是“一个指标及其所在报告上下文”;若目标是理解一份体检结论,样本单元应包括报告正文、结论建议和对应检查材料;若目标是学习纵向健康变化,则同一匿名个体的多次报告必须能够稳定关联。数量口径需要同时说明患者数、就诊或体检事件数、文件数、页数和影像序列数,不能把这些单位混成一个总量。
附件中的需求类型覆盖了综合体检报告、报告单、报告单加病例上下文、复杂表格OCR、文本语料、医学书籍与知识材料等不同加工对象。它们不能共用一张验收表。一个合理的采购包应先按用途拆分,再为每类定义数据单元、必需字段、原始文件、关联键、质量阈值和抽检方式。这样做能降低后期返工,也便于模型团队判断哪些样本适合训练、哪些适合验证、哪些只适合作为检索知识。
把“有报告”细化为可执行的验收字段
医疗报告的可用性不是简单的“能打开”。需要检查报告类型、来源机构类型、检查日期、样本匿名ID、报告正文、检查项目、结果、单位、参考区间、异常标记、结论建议,以及文件和结构化记录之间的映射。对图像类检查,还要记录模态、检查部位、序列或图像标识、检查日期、影像报告和相应原始图像之间的关系。字段清单应区分必填、条件必填和可选项,并说明空值、未知、未检查、无法辨认各自如何编码。若数据包还包含医疗机构或医生信息目录,应记录信息来源、机构与科室归属、字段更新时间和适用范围;排班、出诊或号源等动态字段要明确刷新周期,不能仅凭静态字段齐全率判断当前可用性。
建议保留三个层次的内容。第一层是原始文件,保证后续可追溯;第二层是忠实转录或OCR文本,标出无法确认的字符和不确定区域;第三层是规范化字段,保存标准单位、术语或编码的映射结果。三层之间必须有样本ID和位置映射,不能只保留经过模型或人工整理后的“干净结果”。原始值与标准化值分列保存,规范化转换保留规则和版本,才能区分医学原始信息与工程加工结果。
特别要避免把OCR置信度当成医学正确率。版面识别可能把表格列错位,数值识别可能遗漏小数点,参考区间可能与相邻指标互换,异常箭头也可能漏读。质量控制需按错误类型设计检查:字符识别、单元格定位、字段归属、数值与单位、参考范围、异常标识和报告级结论分别核验。对于低清晰度样本,正确行为应是标记“不可可靠读取”并保留原因,而不是自动补全看似合理的值。附件中的低质量报告图像需求也体现了这点:系统需要学会识别信息不足,而不是在模糊处猜测。
医学质量要检查语义链 而不是只看字段齐全率
结构化字段完整,不代表样本临床语义正确。一个报告的医学链条至少包括原始检查结果、单位和参考范围、异常判断、医生描述、总检结论与建议。质量审核要问:异常标识是否与数值和参考范围相符?结论是否有报告正文支撑?影像所见与结论是否对应?脱敏是否覆盖了重要医学内容?报告内不同页面的患者年龄、日期或检查项目是否相互矛盾?这些问题通常不能由单纯的非空检查发现。
对综合体检报告,建议采用“准入红线+分项评分”的双层口径。红线用于判断授权、隐私泄露、严重缺页、影像缺失、错配和医学逻辑错误等不可接受问题;通过红线后,再对报告完整度、图像质量、字段准确性、项目丰富度、异常解释和纵向比较等维度评分。基础字段的缺失率应单独计算,医学逻辑错误应单独统计,不应被一组平均分稀释。所有指标都要写出分母、抽样单位、缺失值处理和重复样本去重规则。
采购标准本身也要经过一致性审查。例如,一份验收文档如果在不同章节对“有效医学页数”采用不同阈值,供应商和验收方就可能各自按不同门槛执行。类似地,“体检报告”“报告单”“病例资料”的适用范围、影像附件要求和评分等级也必须明确版本。建议把每条要求落实到唯一的字段或验收项,给出定义、检测方式、通过条件、责任方和争议处理流程。POC阶段用一批代表性样本验证规则,发现门槛冲突先修订标准,再进入批量交付。
影像配对和隐私处理需要成为交付链的一部分
报告提到超声、CT、MRI、内镜或其他影像检查时,影像文件应能够对应到同一匿名样本、同一次检查和相应文字描述。验收不只看“文件夹里有图片”,还要确认检查时间、模态、部位和报告结论能相互匹配;重复图像、错误病灶图、无关序列都可能造成模型学习偏差。若交付包含DICOM,应检查图像序列完整性、关键元数据和标识信息处理;若交付为截图或报告图片,应确保分辨率、方向、文字可读性和图文对应关系。
去标识化同样不能只做PDF正文的姓名遮挡。个人信息可能出现在页眉页脚、二维码、条形码、影像烧录字符、DICOM头字段、扫描文件名、文书自由文本或导出目录中。另一方面,日期、年龄、检查参数和纵向关联可能是研究任务需要的变量,处理方式应以风险评估和授权范围为前提。交付双方应记录处理范围、处理工具或规则、复核方式、异常处理结果和责任归属;对影像与文书进行抽样复核,并保留可审计的处理日志。DICOM标准提供了影像去标识化配置的参考框架,但实际实施仍需结合图像内嵌文本、文件外信息和具体使用场景审核。[1]
数据来源与授权材料应与训练数据分开管理,但在治理层面能够关联。采购验收不应仅依赖供应商的一句“已脱敏”,而应确认来源说明、授权范围、用途限制和转交条件符合项目要求;对于来源、授权或用途不清楚的数据,应先冻结使用并澄清。样本进入数据池前还应生成来源记录、处理版本和内容摘要,避免无法回答“这条数据从哪里来、经历了哪些加工、可以用于什么任务”。
用POC和分层抽检降低批量风险
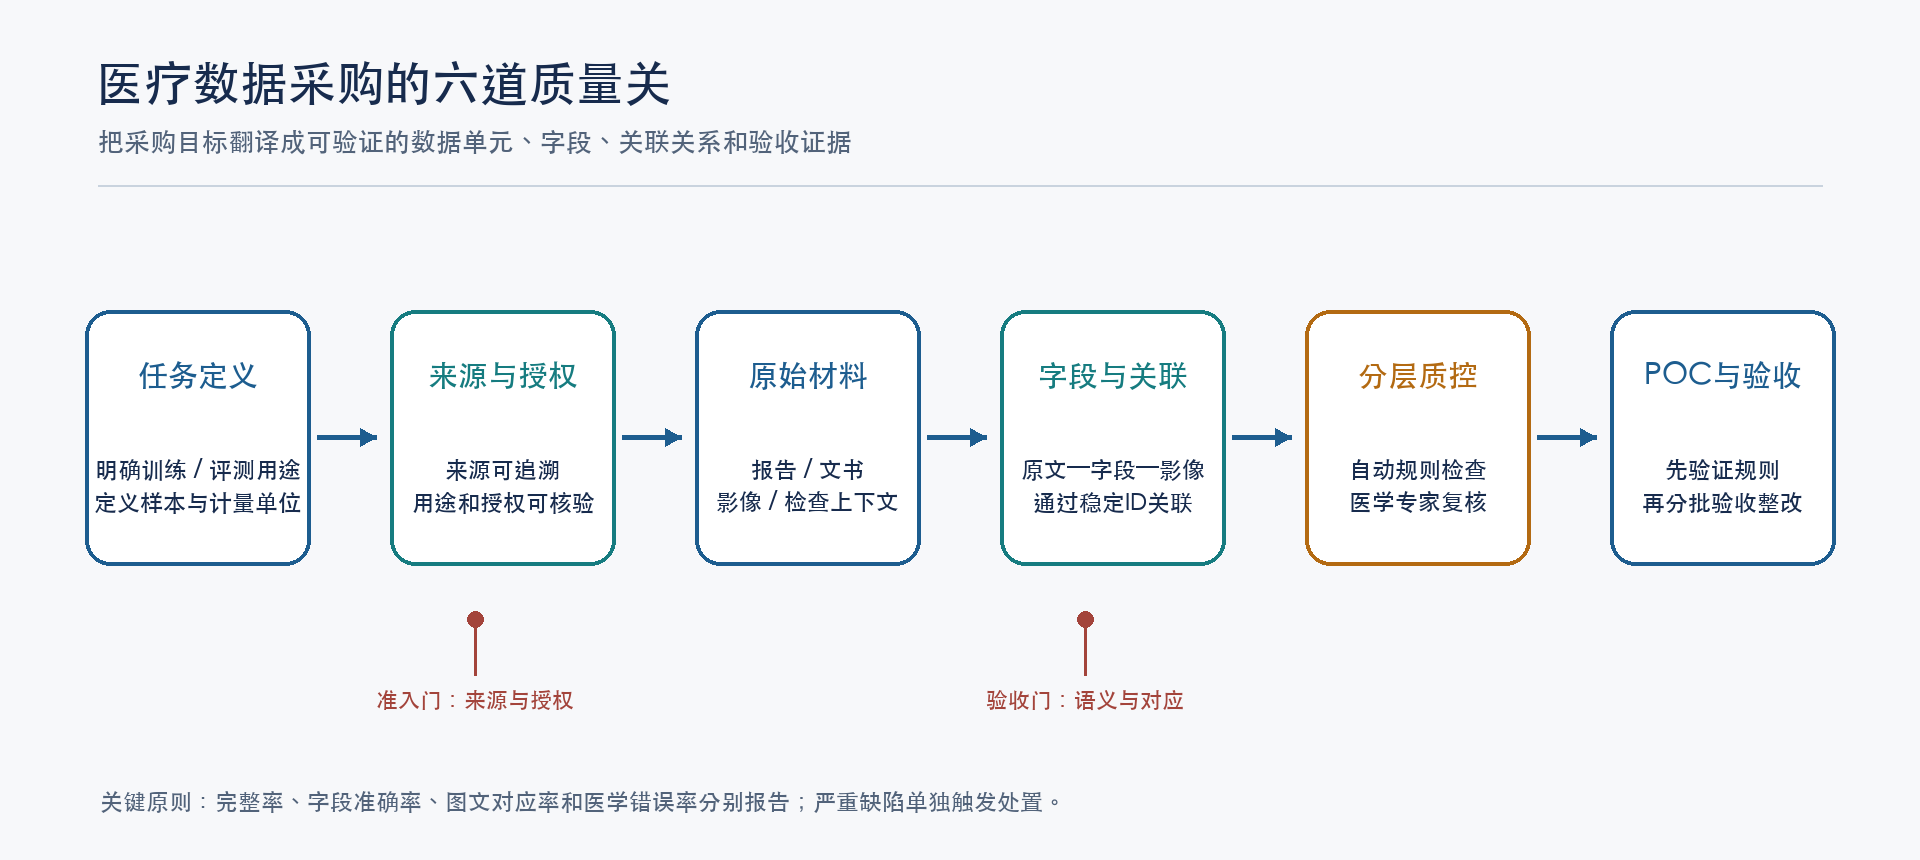
批量采购前,POC的目的不是展示供应商挑出的最好样本,而是验证整个交付流程是否可重复。抽样应覆盖报告类型、不同版式、图像质量、正常与异常结果、复杂表格、跨年度记录和不同设备来源。样本清单应由需求方参与确定,避免只看到供应商预先筛选的易处理数据。POC阶段分别检查格式、字段、图文对应、医学语义、脱敏和文件映射,输出逐项缺陷及修复闭环,然后再决定是否放大规模。
进入批次验收后,除总体合格率外,还应关注关键子群体表现。整体准确率可能掩盖某一类报告、某一设备、某种版式或低清晰度样本的明显缺陷。可按报告类别、图像质量、字段复杂度和来源类别分层抽样,报告各层的错误率和置信区间。对一票否决问题采用整例退回或批次暂停规则;对可修复问题设定复核比例、返工时限和复验标准。每次修订要保留原始版本、修改版本和复验结果,防止问题在不同批次重复出现。
从算法角度看,样本切分也属于采购验收设计。若同一人的多份报告被分散到训练集与测试集,模型可能通过重复内容或个人特征“记住答案”,导致验证结果偏高。对于纵向任务,数据集应以患者为单位切分,并明确时间切分;对版式识别,还要考虑同模板跨集合造成的分布偏差。测试集最好保留难例、低质量样本和真实缺失情况,且测试标签由独立流程管理。通过采购、治理和模型评测的联动,才能判断模型提升来自真实泛化,而不是数据重复或测试泄漏。
质量指标要能映射到模型风险
不同错误对模型的影响并不相同。把小标题识别错位、把异常检验值读反、把不同患者的报告合并,不能都记作一次普通字段错误。建议把缺陷按严重度分级:会改变临床含义或患者归属的错误设为关键缺陷;影响模型判断但尚可在人工流程中发现的设为重大缺陷;不改变核心语义的格式问题作为一般缺陷。每一级都要说明如何计数、怎样复核、触发什么整改或拒收动作。验收报告应呈现缺陷分布,而不只是一个总通过率。
还要区分“字段层准确率”和“样本层合格率”。一个字段抽取任务可报告精确率、召回率、F1、数值差异容忍范围和字段定位准确率;一份报告的合格则还要看必需字段、完整性、关联文件和医学一致性。若把数百万字段简单平均,少数严重错误可能被大量容易字段稀释。较好的做法是同时报告微平均、宏平均、关键字段指标和样本级通过比例,并按报告类别与难度分层。对抽检结果还应给出抽样方法和估计不确定性,避免把小样本的偶然高分宣传为全量质量保证。
数据分布本身也需要质控。性别、年龄段、科室、检查类型、异常状态、机构和报告版式的比例可能与模型目标相关。数据采集时为了突出难例而进行富集,能提高训练效率,却改变了总体样本结构;如果评测集也采用相同富集方式,结果不能代表一般使用场景。建议同时维护“用于能力测试的挑战集”和“接近目标使用场景的代表性评测集”,明确两者的选择方式。对于稀有类别,应报告真实样本量和置信区间,避免以少量样本做确定性结论。
将数据缺陷闭环到供应和标注过程
验收结果不能只停留在采购人员的扣款或退回记录。每种缺陷都应回溯到形成环节:来源筛选是否不符合定义,扫描采集是否造成图像失真,OCR是否把列关系弄错,去标识化规则是否遮挡医学值,人工复核是否遗漏,交付转换是否破坏了字段或路径。把缺陷原因关联到批次、处理版本和责任环节后,项目方才能判断要改采集规范、加工规则、标注培训还是文件打包流程。
建议每批交付都有机器可读的清单,记录文件哈希或校验值、匿名样本键、文件类型、生成时间、处理版本、关联检查事件和复核状态。对于修订,不应直接覆盖原文件,而应记录新旧版本之间的关系及修改原因。需求变更时保留标准版本号、生效日期和受影响批次,避免同一项目不同批次各自使用一套隐含规则。对于长期合作,复购不意味着简单复制上一批的格式,而是以问题清单为输入持续更新字段定义和难例覆盖。
朗慧的交付思路 应从规则可核查开始
医疗数据采购的专业度,不取决于把需求文档写得多长,而取决于能否把目标转成可执行的样本定义、字段规范、质量指标、POC流程和批次验收证据。朗慧面向医疗数据项目的对外表达,可以具体落在需求拆解、数据结构设计、医学质控、去标识化复核和验收闭环这些环节;每个项目再依据其授权、样例、任务和验收规则确定实际交付范围。这样的表述既能体现工程能力,也不会把某一个采购项目的门槛误写成所有客户通用的承诺。
一套成熟的采购方案,最终要让算法工程师拿到可直接读取的文件和字段,让医学专家能复核上下文与临床逻辑,让采购和合规人员能追溯来源、授权和验收结论。报告数量只是入口;报告之间、报告与影像之间、字段与原文之间的关系,才决定它是不是可靠的数据资产。
常见问题
医疗AI训练数据的验收只看字段准确率够吗? 不够。还应检查样本定义、来源授权、文档完整性、图像质量、图文对应、医学语义、去标识化、重复率以及患者级切分等事项,并为高风险缺陷设立单独规则。
医疗报告OCR应该怎样处理模糊区域? 将无法可靠识别的内容标记为不确定,保留原图位置和置信度,进入人工复核或排除流程。不要仅凭上下文猜补检查数值、异常标记和诊断结论。
POC样本怎样选才有代表性? 按预期任务覆盖常见和少见版式、不同报告类型、异常与正常、清晰和低清晰度、复杂表格及图像关联等情况,并保留随机样本,避免只用容易通过的精选样本。
参考资料
[1] DICOM PS3.15 2025e,Security and System Management Profiles,附录E:Attribute Confidentiality Profiles。https://dicom.nema.org/medical/dicom/2025e/output/html/part15.html
[2] Mongan J, et al. Checklist for Artificial Intelligence in Medical Imaging (CLAIM): 2024 Update. Radiology: Artificial Intelligence. https://pmc.ncbi.nlm.nih.gov/articles/PMC11304031/
[3] STARD-AI Steering Group. The STARD-AI reporting guideline for diagnostic accuracy studies using artificial intelligence. Nature Medicine, 2025. https://doi.org/10.1038/s41591-025-03953-8