Defina primeiro a unidade de dados e depois discuta a quantidade de compra
Um relatório de exame físico pode ser um relatório abrangente de um ano completo ou pode ser apenas um único formulário de relatório para um determinado exame. Ambos são PDFs ou imagens na superfície, mas as tarefas de treinamento são completamente diferentes: as primeiras podem ser usadas para compreensão de relatórios, indução de riscos e análise de mudanças ao longo do ano; este último geralmente serve para OCR, extração de campo, identificação de anomalias ou compreensão de relatórios de imagens. Se a unidade da amostra, o conteúdo mínimo a ser entregue e as tarefas esperadas não forem determinados antes da consulta, os fornecedores poderão interpretá-los individualmente em termos de “páginas”, “folhas” e “partes”. A quantidade final pode parecer suficiente, mas falta ao modelo um contexto completo.
Portanto, os requisitos de aquisição devem ser deduzidos da definição de dados de “o que o modelo deseja aprender”. Se o objetivo é analisar indicadores de inspeção, a menor unidade pode ser “um indicador e seu contexto de relatório”; se o objetivo for compreender a conclusão de um exame físico, a unidade amostral deverá incluir o texto do relatório, sugestões de conclusão e materiais de exame correspondentes; se o objetivo é conhecer as mudanças longitudinais na saúde, vários relatos do mesmo indivíduo anônimo devem estar relacionados de forma estável. O calibre quantitativo precisa descrever simultaneamente o número de pacientes, número de consultas médicas ou eventos de exame físico, número de arquivos, número de páginas e número de sequências de imagens. Essas unidades não podem ser misturadas em um valor total. Os tipos de demanda no anexo
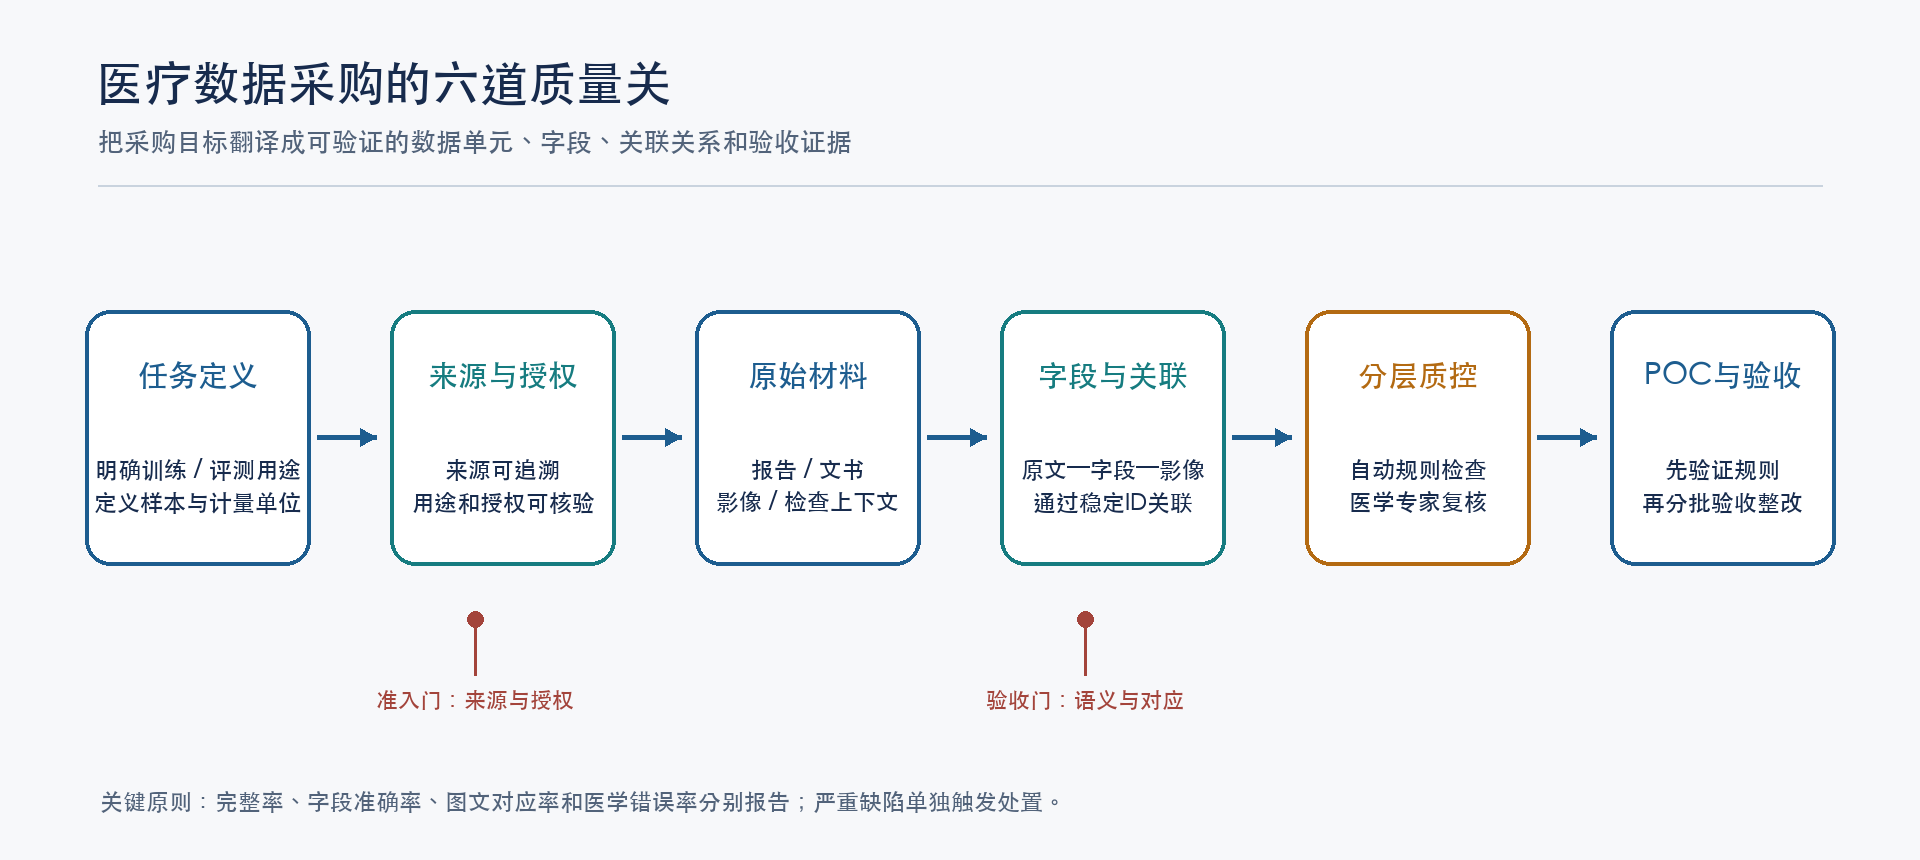
cobrem diferentes objetos de processamento, como relatórios de exames físicos abrangentes, planilhas de relatórios, planilhas de relatórios mais contexto de caso, OCR de formulário complexo, corpus de texto, livros médicos e materiais de conhecimento. Eles não podem compartilhar um formulário de aceitação. Um pacote de compras razoável deve primeiro ser dividido de acordo com a finalidade e depois definir unidades de dados, campos obrigatórios, arquivos originais, chaves associadas, limites de qualidade e métodos de amostragem para cada categoria. Isso pode reduzir o retrabalho posterior e tornar mais fácil para a equipe do modelo determinar quais amostras são adequadas para treinamento, quais são adequadas para verificação e quais são adequadas apenas para recuperação de conhecimento.
Refinar “relatado” em campos de aceitação executáveis
A disponibilidade de laudos médicos não é simplesmente “podem ser abertos”. É necessário verificar o tipo de relatório, tipo de instituição de origem, data de inspeção, ID anônimo da amostra, texto do relatório, itens de inspeção, resultados, unidades, intervalos de referência, sinalizadores de anormalidades, recomendações de conclusão e o mapeamento entre arquivos e registros estruturados. Para inspeções por imagem, também deverá ser registrada a relação entre modalidade, local de inspeção, identificação da sequência ou imagem, data da inspeção, relatório de imagem e imagem original correspondente. A lista de campos deve distinguir entre obrigatório, condicionalmente obrigatório e opcional e explicar como codificar valores nulos, desconhecidos, não verificados e não identificados, respectivamente. Se o pacote de dados também contiver uma instituição médica ou diretório de informações médicas, deverão ser registrados a fonte da informação, a afiliação da instituição e do departamento, o tempo de atualização do campo e o escopo de aplicação; campos dinâmicos, como agendamento de turnos, chamadas domiciliares ou fontes de números, devem ter um ciclo de atualização claro, e a disponibilidade atual não pode ser avaliada apenas pela taxa de conclusão de campos estáticos.
Recomenda-se reter três níveis de conteúdo. A primeira camada é o documento original para garantir a rastreabilidade posterior; a segunda camada é a transcrição fiel ou texto OCR, marcando caracteres não confirmados e áreas incertas; a terceira camada são os campos padronizados, que salvam os resultados do mapeamento de unidades, termos ou codificações padrão. Deve haver identificação de amostra e mapeamento de localização entre as três camadas, e você não pode reter apenas os "resultados limpos" que foram processados pelo modelo ou manualmente. Os valores originais e os valores padronizados são salvos em colunas separadas, e a conversão padronizada retém regras e versões para que as informações médicas originais e os resultados do processamento de engenharia possam ser distinguidos.
Em particular, evite considerar a confiança do OCR como precisão médica. O reconhecimento de layout pode desalinhar as colunas da tabela, o reconhecimento numérico pode perder pontos decimais, os intervalos de referência podem ser trocados por indicadores adjacentes e setas anormais também podem ser perdidas. O controle de qualidade precisa projetar verificações com base nos tipos de erros: reconhecimento de caracteres, posicionamento de células, atribuição de campo, valores numéricos e unidades, intervalos de referência, identificação de exceções e conclusões em nível de relatório são verificados separadamente. Para amostras de baixa resolução, o comportamento correto deve ser marcar "leitura não confiável" e reter o motivo, em vez de preencher automaticamente valores aparentemente razoáveis. A exigência de imagens de relatório de baixa qualidade no anexo também ilustra este ponto: os sistemas precisam aprender a reconhecer lacunas nas informações em vez de adivinhar ambiguidades.
A qualidade médica deve verificar a cadeia semântica em vez de apenas observar a taxa de preenchimento do campo
Os campos estruturados estão preenchidos, o que não significa que a semântica clínica da amostra esteja correta. A cadeia médica de um relatório inclui pelo menos resultados de exames originais, unidades e intervalos de referência, julgamentos de anormalidades, descrições médicas e conclusões e recomendações gerais de exames. As auditorias de qualidade devem perguntar: A identificação da anormalidade corresponde ao valor numérico e ao intervalo de referência? As conclusões são apoiadas pelo texto do relatório? As descobertas nas imagens correspondem às conclusões? A dessensibilização cobre conteúdos médicos importantes? As idades, datas ou itens dos testes dos pacientes estão em conflito nas diferentes páginas do relatório? Esses problemas geralmente não podem ser detectados por uma simples verificação não nula.
Para o relatório de exame físico abrangente, recomenda-se adotar uma abordagem de dois níveis de “linha vermelha de admissão + subpontuação”. A linha vermelha é usada para determinar problemas inaceitáveis, como autorização, vazamentos de privacidade, falta grave de páginas, imagens faltantes, incompatibilidades e erros de lógica médica; depois de passar a linha vermelha, o relatório é pontuado em dimensões como integridade do relatório, qualidade da imagem, precisão do campo, riqueza de itens, explicação de anomalias e comparação longitudinal. A taxa de falta de campos básicos deve ser calculada separadamente, e os erros de lógica médica devem ser contados separadamente e não devem ser diluídos por um conjunto de pontuações médias. Todos os indicadores devem anotar o denominador, a unidade amostral, o processamento de valores faltantes e as regras de desduplicação de amostras duplicadas. O próprio padrão de aquisição
também está sujeito a revisão de consistência. Por exemplo, se um documento de aceitação adotar limites diferentes para o "número de páginas médicas válidas" em capítulos diferentes, o fornecedor e a parte aceitante poderão implementar limites diferentes, cada um. Da mesma forma, o escopo aplicável, os requisitos de anexação de imagens e os níveis de pontuação de “relatório de exame físico”, “folha de relatório” e “informações do caso” também devem ser claramente definidos. Recomenda-se implementar cada requisito em um campo exclusivo ou item de aceitação e fornecer a definição, método de detecção, condições de aprovação, parte responsável e processo de tratamento de disputas. Na etapa POC, um lote de amostras representativas é utilizado para verificar as regras. Se forem encontrados conflitos de limites, os padrões serão revisados primeiro, antes de entrar na entrega em lote.
O emparelhamento de imagens e o processamento de privacidade precisam fazer parte da cadeia de entrega
Quando o laudo mencionar ultrassonografia, tomografia computadorizada, ressonância magnética, endoscopia ou outros exames de imagem, os arquivos de imagem deverão poder corresponder à mesma amostra anônima, ao mesmo exame e à correspondente descrição textual. A aceitação não se baseia apenas em “há fotos na pasta”, mas também na confirmação de que o horário da inspeção, modalidade, local e conclusões do relatório coincidem; imagens duplicadas, mapas de lesões errados e sequências irrelevantes podem causar viés de aprendizagem do modelo. Se a entrega contiver DICOM, a integridade da sequência de imagens, os metadados principais e o processamento das informações de identificação deverão ser verificados; se a entrega for uma captura de tela ou imagem de relatório, a resolução, direção, legibilidade do texto e correspondência imagem-texto devem ser garantidas.
A desidentificação não pode abranger apenas nomes no corpo do PDF. As informações pessoais podem aparecer em cabeçalhos e rodapés, códigos QR, códigos de barras, caracteres de gravação de imagens, campos de cabeçalho DICOM, nomes de arquivos digitalizados, texto livre de documentos ou diretórios de exportação. Por outro lado, data, idade, parâmetros de exame e associações longitudinais podem ser variáveis necessárias para a tarefa de pesquisa e devem ser tratadas de maneira baseada na avaliação de risco e no escopo da autorização. Ambas as partes envolvidas na entrega devem registrar o escopo do processamento, as ferramentas ou regras de processamento, os métodos de revisão, os resultados do tratamento de exceções e a atribuição de responsabilidades; realizar análises de amostragem de imagens e documentos e manter registros de processamento auditáveis. O padrão DICOM fornece uma estrutura de referência para configuração de desidentificação de imagens, mas a implementação real ainda precisa ser revisada com base no texto incorporado na imagem, informações fora do arquivo e cenários de uso específicos.[1]
As fontes de dados e os materiais autorizados devem ser gerenciados separadamente dos dados de treinamento, mas podem ser vinculados no nível de governança. A aceitação da aquisição não deve basear-se apenas na declaração "dessensibilizada" do fornecedor, mas deve confirmar que a descrição da fonte, o âmbito da autorização, as restrições de utilização e as condições de transferência cumprem os requisitos do projecto; para dados cuja fonte, autorização ou finalidade não são claras, a utilização deve ser congelada e esclarecida primeiro. Antes da amostra entrar no conjunto de dados, registros de origem, versões de processamento e resumos de conteúdo também devem ser gerados para evitar a impossibilidade de responder "de onde vêm esses dados, a que processamento foram submetidos e para quais tarefas podem ser usados".
Use POC e amostragem estratificada para reduzir riscos de lote
Antes da compra a granel, o objetivo do POC não é mostrar a melhor amostra selecionada pelo fornecedor, mas verificar se todo o processo de entrega é repetível. A amostragem deve abranger tipos de relatórios, diferentes formatos, qualidade de imagem, resultados normais versus anormais, formulários complexos, registros abrangendo vários anos e diferentes fontes de equipamentos. A lista de amostras deve ser determinada com a participação do lado da demanda para evitar ver apenas dados facilmente processados e pré-selecionados pelo fornecedor. O estágio POC verifica separadamente o formato, os campos, a correspondência imagem-texto, a semântica médica, a dessensibilização e o mapeamento de arquivos, gera defeitos item por item e corrige o ciclo fechado, e então decide se deve aumentar a escala. Depois que
entra na aceitação do lote, além da taxa geral de aprovação, atenção também deve ser dada ao desempenho dos principais subgrupos. A precisão global pode mascarar falhas óbvias num determinado tipo de relatório, num determinado dispositivo, num determinado formato ou numa amostra de baixa definição. A amostragem estratificada pode ser realizada relatando categoria, qualidade de imagem, complexidade de campo e categoria de fonte, relatando taxas de erro e intervalos de confiança para cada estrato. Adotar regras de devolução de todo o caso ou suspensão de lote para questões de veto de um voto; definir taxas de revisão, limites de tempo de retrabalho e padrões de reinspeção para problemas solucionáveis. A versão original, a versão modificada e os resultados do reteste devem ser retidos para cada revisão para evitar que problemas se repitam em lotes diferentes.
Do ponto de vista algorítmico, a segmentação da amostra também pertence ao design de aceitação de compras. Se vários relatórios da mesma pessoa estiverem espalhados no conjunto de treinamento e no conjunto de teste, o modelo pode "lembrar a resposta" por meio de conteúdo repetido ou características pessoais, resultando em resultados de validação mais elevados. Para tarefas longitudinais, o conjunto de dados deve ser segmentado por paciente e a segmentação temporal deve ser clara; para reconhecimento de layout, o desvio de distribuição causado pelo mesmo modelo entre coleções também deve ser considerado. Idealmente, o conjunto de testes deve reter exemplos difíceis, amostras de baixa qualidade e casos verdadeiros ausentes, e os rótulos de teste devem ser gerenciados por um processo independente. Através da ligação entre aquisição, governação e avaliação de modelos, pode-se determinar que a melhoria do modelo resulta de uma verdadeira generalização e não da duplicação de dados ou da fuga de testes.
Indicadores de qualidade devem ser mapeados para modelar riscos
Erros diferentes têm efeitos diferentes no modelo. A identificação de legendas mal posicionadas, a leitura incorreta de valores de testes anormais e a fusão de relatórios de diferentes pacientes não podem ser registrados como erros de campo comuns. Recomenda-se que os defeitos sejam classificados de acordo com a gravidade: erros que irão alterar o significado clínico ou a atribuição do paciente são definidos como defeitos críticos; erros que afetam o julgamento do modelo, mas que ainda podem ser encontrados no processo manual, são definidos como defeitos graves; problemas de formato que não alteram a semântica central são considerados defeitos gerais. Cada nível deve explicar como contar, como revisar e quais ações corretivas ou de rejeição são acionadas. O relatório de aceitação deve apresentar uma distribuição de defeitos, e não apenas uma taxa geral de aprovação.
Também é necessário distinguir entre "taxa de precisão no nível de campo" e "taxa de aprovação no nível de amostra". Uma tarefa de extração de campo pode relatar precisão, recall, F1, faixa de tolerância de diferença numérica e precisão de posicionamento de campo; a qualificação de um laudo depende também dos campos obrigatórios, da completude, dos arquivos associados e da consistência médica. Se for simplesmente calculada a média de milhões de campos, alguns erros graves podem ser diluídos por um grande número de campos fáceis. Uma prática melhor é relatar micromédias, macromédias, métricas de campo chave e proporções de aprovação no nível da amostra simultaneamente, estratificadas por categoria de relatório e dificuldade. O método de amostragem e a incerteza estimada também devem ser fornecidos para os resultados da amostragem, para evitar a promoção de pontuações altas acidentais de uma amostra pequena como garantia de qualidade total.
A própria distribuição de dados também requer controle de qualidade. As proporções de sexo, faixa etária, departamento, tipo de exame, situação anormal, instituição e formato do relatório podem ser relevantes para os objetivos do modelo. O enriquecimento para destacar exemplos difíceis durante a recolha de dados pode melhorar a eficiência da formação, mas altera a estrutura geral da amostra; se o mesmo método de enriquecimento for usado para o conjunto de avaliação, os resultados não poderão representar cenários de uso geral. Recomenda-se manter um "conjunto de desafios para testes de proficiência" e um "conjunto de avaliação representativo próximo ao cenário de uso alvo" e esclarecer o método de seleção dos dois. Para categorias raras, o verdadeiro tamanho da amostra e o intervalo de confiança devem ser relatados para evitar conclusões determinísticas com base em um pequeno número de amostras.
Fechar o ciclo de defeitos de dados no processo de fornecimento e anotação
O resultado da aceitação não pode parar apenas na dedução do comprador ou no registro de devolução. Cada falha deve ser rastreada até sua origem: se a triagem da fonte não atende à definição, se a aquisição de digitalização causa distorção de imagem, se o OCR erra nas relações das colunas, se as regras de desidentificação obscurecem os valores médicos, se a revisão manual é perdida, se a transformação da entrega destrói campos ou caminhos. Depois de associar a causa do defeito ao lote, versão de processamento e link responsável, a equipe do projeto pode determinar se deseja alterar as especificações de coleta, regras de processamento, treinamento de rotulagem ou processo de empacotamento de arquivos.
Recomenda-se que cada lote de entrega tenha um manifesto legível por máquina registrando o valor de hash ou soma de verificação do arquivo, chave de amostra anônima, tipo de arquivo, tempo de geração, versão de processamento, evento de verificação de correlação e status de revisão. Para revisões, o arquivo original não deve ser sobrescrito diretamente, mas a relação entre a versão antiga e a nova e os motivos da modificação devem ser registrados. Quando os requisitos mudam, o número da versão padrão, a data de vigência e os lotes afetados são mantidos para evitar o uso de um conjunto de regras implícitas para diferentes lotes do mesmo projeto. Para uma cooperação de longo prazo, a recompra não significa simplesmente copiar o formato do lote anterior, mas atualizar continuamente as definições de campo e a cobertura de casos difíceis usando a lista de problemas como entrada. A ideia de entrega de
Langhui deve começar com regras verificáveis
O profissionalismo da aquisição de dados médicos não depende de quanto tempo o documento de requisitos é escrito, mas de se as metas podem ser convertidas em definições de amostra executáveis, especificações de campo, indicadores de qualidade, processos POC e evidências de aceitação de lote. A expressão externa de projetos de dados médicos de Langhui pode cair especificamente nas etapas de desmontagem de requisitos, design de estrutura de dados, controle de qualidade médica, revisão de desidentificação e ciclo fechado de aceitação; cada projeto determina então o escopo real de entrega com base em sua autorização, amostras, tarefas e regras de aceitação. Tal declaração pode não apenas refletir as capacidades de engenharia, mas também evitar que o limite de um determinado projeto de aquisição seja erroneamente escrito como um compromisso universal para todos os clientes.
Uma solução de aquisição madura permitirá que os engenheiros de algoritmos obtenham arquivos e campos diretamente legíveis, permitirá que especialistas médicos revisem o contexto e a lógica clínica e permitirá que o pessoal de aquisição e conformidade rastreie fontes, autorizações e conclusões de aceitação. A quantidade de relatórios é apenas a entrada; a relação entre relatórios, entre relatórios e imagens e entre campos e texto original determina se é um ativo de dados confiável. Perguntas frequentes sobre
Perguntas frequentes
É suficiente observar apenas a precisão de campo para aceitação dos dados de treinamento de IA médica? Não é suficiente. Coisas como definição da amostra, autorização da fonte, integridade da documentação, qualidade da imagem, correspondência entre imagem e texto, semântica médica, desidentificação, taxa de duplicação e segmentação em nível de paciente também devem ser verificadas, e regras separadas devem ser estabelecidas para defeitos de alto risco.
Como o OCR de relatórios médicos deve lidar com áreas confusas? Marque o conteúdo que não pode ser identificado de forma confiável como incerto, mantenha a localização e a confiança da imagem original e entre no processo manual de revisão ou eliminação. Não adivinhe valores de verificação, sinalizadores de exceção e conclusões de diagnóstico com base apenas no contexto. Como selecionar amostras POC
Como selecionar amostras de POC representativas? Cubra layouts comuns e raros, diferentes tipos de relatórios, anormais e normais, claros e de baixa definição, tabelas complexas e correlações de imagens de acordo com as tarefas esperadas, e retenha amostras aleatórias para evitar usar apenas amostras selecionadas que sejam fáceis de passar.
Referências
[1] DICOM PS3.15 2025e, Perfis de segurança e gerenciamento de sistema, Apêndice E: Perfis de confidencialidade de atributos.https://dicom.nema.org/medical/dicom/2025e/output/html/part15.html
[2] Mongan J, et al. Lista de verificação para inteligência artificial em imagens médicas (CLAIM): atualização de 2024. Radiologia Inteligência Artificial. https://pmc.ncbi.nlm.nih.gov/articles/PMC11304031/
[3] Grupo de direção STARD-AI. A diretriz de relatórios STARD-AI para estudos de precisão de diagnóstico usando inteligência artificial. Medicina Natural, 2025. https://doi.org/10.1038/s41591-025-03953-8