पहले डेटा इकाई को परिभाषित करें और फिर खरीद मात्रा पर चर्चा करें
एक शारीरिक जांच रिपोर्ट पूरे वर्ष के लिए एक व्यापक रिपोर्ट हो सकती है, या यह एक निश्चित परीक्षा के लिए सिर्फ एक रिपोर्ट फॉर्म हो सकती है। दोनों सतह पर पीडीएफ या चित्र हैं, लेकिन प्रशिक्षण कार्य पूरी तरह से अलग हैं: पूर्व का उपयोग रिपोर्ट को समझने, जोखिम प्रेरण और क्रॉस-ईयर परिवर्तन विश्लेषण के लिए किया जा सकता है; उत्तरार्द्ध आमतौर पर ओसीआर, फ़ील्ड निष्कर्षण, विसंगति पहचान या छवि रिपोर्ट समझ का कार्य करता है। यदि नमूना इकाई, न्यूनतम वितरण योग्य सामग्री और अपेक्षित कार्य पूछताछ से पहले निर्धारित नहीं किए जाते हैं, तो आपूर्तिकर्ता उन्हें "पेज," "शीट्स," और "भागों" के संदर्भ में व्यक्तिगत रूप से व्याख्या कर सकते हैं। अंतिम मात्रा पर्याप्त लग सकती है, लेकिन मॉडल में पूर्ण संदर्भ का अभाव है।
इसलिए, खरीद आवश्यकताओं को "मॉडल क्या सीखना चाहता है" से डेटा परिभाषा से निकाला जाना चाहिए। यदि लक्ष्य निरीक्षण संकेतकों को पार्स करना है, तो सबसे छोटी इकाई "एक संकेतक और उसकी रिपोर्ट संदर्भ" हो सकती है; यदि लक्ष्य शारीरिक परीक्षा के निष्कर्ष को समझना है, तो नमूना इकाई में रिपोर्ट पाठ, निष्कर्ष सुझाव और संबंधित परीक्षा सामग्री शामिल होनी चाहिए; यदि लक्ष्य अनुदैर्ध्य स्वास्थ्य परिवर्तनों को सीखना है, तो एक ही अज्ञात व्यक्ति की कई रिपोर्टें स्थिर रूप से संबंधित होनी चाहिए। मात्रात्मक क्षमता को एक साथ रोगियों की संख्या, चिकित्सा यात्राओं या शारीरिक परीक्षण घटनाओं की संख्या, फाइलों की संख्या, पृष्ठों की संख्या और छवि अनुक्रमों की संख्या का वर्णन करने की आवश्यकता है। इन इकाइयों को कुल राशि में नहीं मिलाया जा सकता.
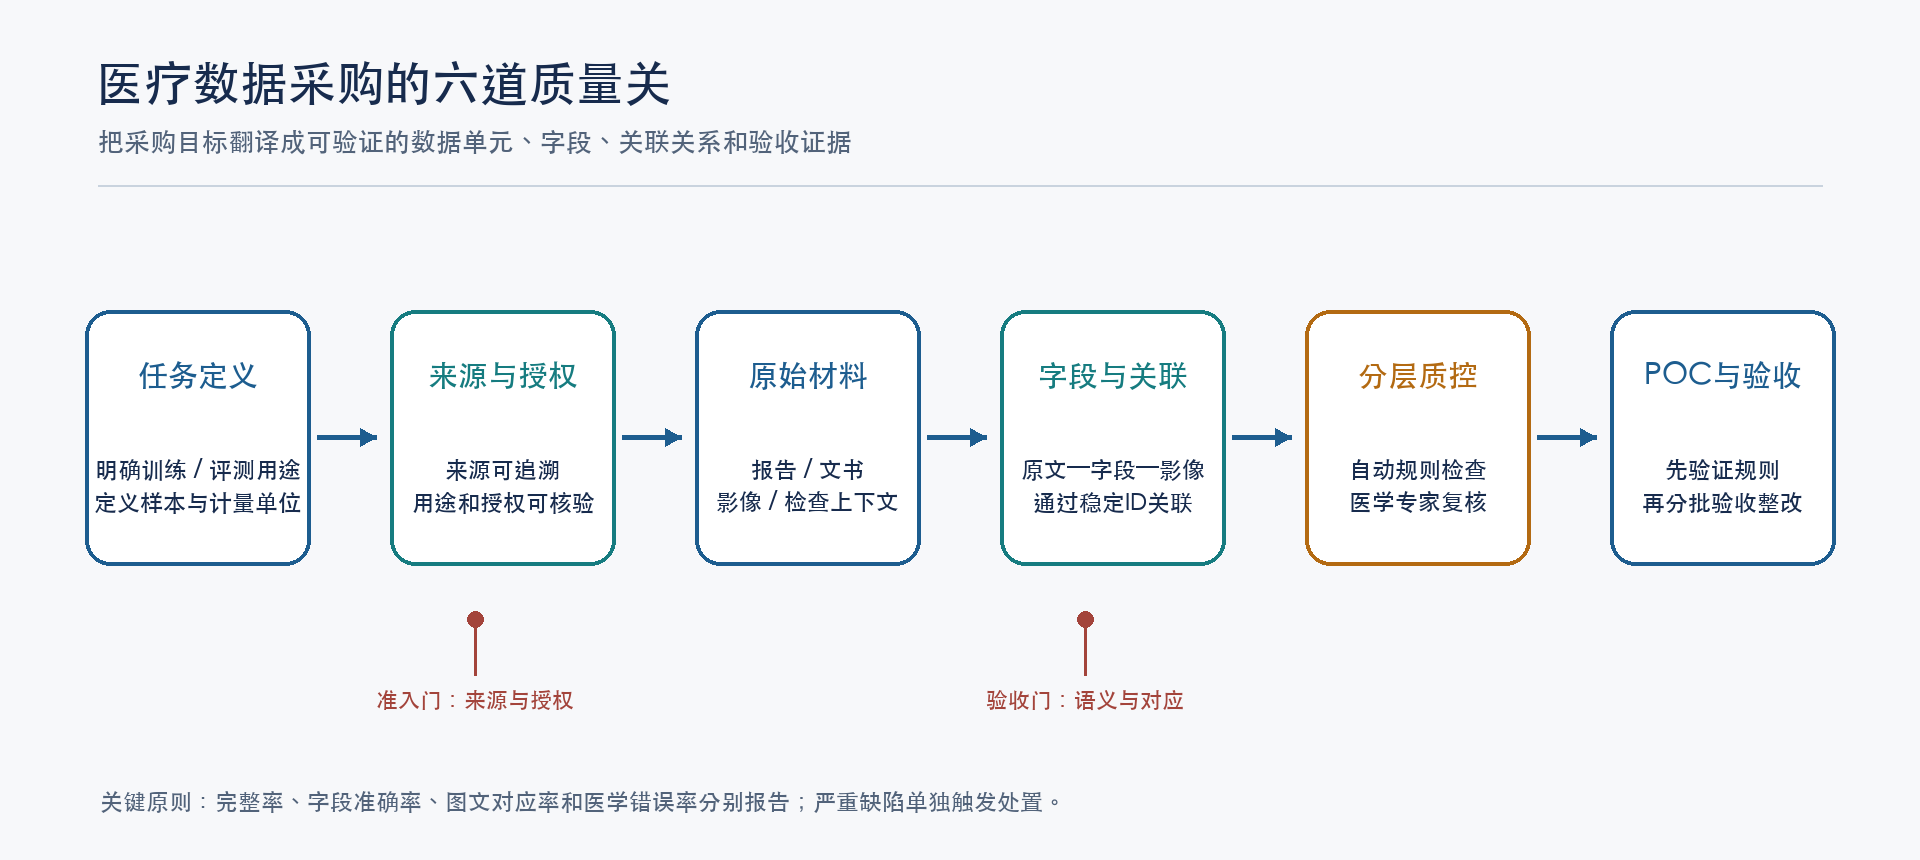
अटैचमेंट में मांग प्रकार विभिन्न प्रसंस्करण वस्तुओं को कवर करते हैं जैसे व्यापक शारीरिक परीक्षा रिपोर्ट, रिपोर्ट शीट, रिपोर्ट शीट प्लस केस संदर्भ, जटिल फॉर्म ओसीआर, टेक्स्ट कॉर्पस, मेडिकल किताबें और ज्ञान सामग्री। वे स्वीकृति प्रपत्र साझा नहीं कर सकते. एक उचित खरीद पैकेज को पहले उद्देश्य के अनुसार विभाजित किया जाना चाहिए, और फिर प्रत्येक श्रेणी के लिए डेटा इकाइयों, आवश्यक फ़ील्ड, मूल फ़ाइलें, संबंधित कुंजी, गुणवत्ता सीमा और नमूनाकरण विधियों को परिभाषित करना चाहिए। इससे बाद में दोबारा काम करना कम हो सकता है और मॉडल टीम के लिए यह निर्धारित करना आसान हो जाएगा कि कौन से नमूने प्रशिक्षण के लिए उपयुक्त हैं, कौन से सत्यापन के लिए उपयुक्त हैं, और कौन से केवल ज्ञान पुनर्प्राप्ति के लिए उपयुक्त हैं।
"रिपोर्ट" को निष्पादन योग्य स्वीकृति फ़ील्ड में परिष्कृत करें
मेडिकल रिपोर्ट की उपलब्धता केवल "खोली नहीं जा सकती" है। रिपोर्ट प्रकार, स्रोत संस्थान प्रकार, निरीक्षण तिथि, नमूना अज्ञात आईडी, रिपोर्ट पाठ, निरीक्षण आइटम, परिणाम, इकाइयां, संदर्भ अंतराल, असामान्य झंडे, निष्कर्ष सिफारिशें, और फाइलों और संरचित रिकॉर्ड के बीच मैपिंग की जांच करना आवश्यक है। छवि निरीक्षण के लिए, तौर-तरीके, निरीक्षण स्थल, अनुक्रम या छवि पहचान, निरीक्षण तिथि, छवि रिपोर्ट और संबंधित मूल छवि के बीच संबंध भी दर्ज किया जाना चाहिए। फ़ील्ड सूची को आवश्यक, सशर्त रूप से आवश्यक और वैकल्पिक के बीच अंतर करना चाहिए, और यह बताना चाहिए कि क्रमशः शून्य, अज्ञात, अनियंत्रित और अज्ञात मानों को कैसे कोड किया जाए। यदि डेटा पैकेज में एक चिकित्सा संस्थान या डॉक्टर सूचना निर्देशिका भी शामिल है, तो सूचना का स्रोत, संस्थान और विभाग की संबद्धता, फ़ील्ड अद्यतन समय और आवेदन का दायरा दर्ज किया जाना चाहिए; शिफ्ट शेड्यूलिंग, हाउस कॉल या नंबर स्रोतों जैसे गतिशील फ़ील्ड में एक स्पष्ट ताज़ा चक्र होना चाहिए, और वर्तमान उपलब्धता का आकलन केवल स्थिर फ़ील्ड की पूर्णता दर पर नहीं किया जा सकता है।
सामग्री के तीन स्तरों को बनाए रखने की अनुशंसा की जाती है। पहली परत बाद में पता लगाने की क्षमता सुनिश्चित करने के लिए मूल दस्तावेज़ है; दूसरी परत विश्वसनीय प्रतिलेखन या ओसीआर पाठ है, जो अपुष्ट वर्णों और अनिश्चित क्षेत्रों को चिह्नित करती है; तीसरी परत मानकीकृत फ़ील्ड है, जो मानक इकाइयों, शब्दों या एन्कोडिंग के मैपिंग परिणामों को सहेजती है। तीन परतों के बीच नमूना आईडी और स्थान मानचित्रण होना चाहिए, और आप केवल "स्वच्छ परिणाम" को बरकरार नहीं रख सकते हैं जिन्हें मॉडल द्वारा या मैन्युअल रूप से संसाधित किया गया है। मूल मान और मानकीकृत मान अलग-अलग कॉलम में सहेजे जाते हैं, और मानकीकृत रूपांतरण नियमों और संस्करणों को बरकरार रखता है ताकि मूल चिकित्सा जानकारी और इंजीनियरिंग प्रसंस्करण परिणामों को अलग किया जा सके।
विशेष रूप से, OCR विश्वास को चिकित्सा सटीकता के रूप में लेने से बचें। लेआउट पहचान से टेबल कॉलम गलत संरेखित हो सकते हैं, संख्यात्मक पहचान से दशमलव बिंदु छूट सकते हैं, संदर्भ अंतराल को आसन्न संकेतकों के साथ बदला जा सकता है, और असामान्य तीर भी छूट सकते हैं। गुणवत्ता नियंत्रण को त्रुटि प्रकारों के आधार पर जांच डिजाइन करने की आवश्यकता है: चरित्र पहचान, सेल स्थिति, फ़ील्ड एट्रिब्यूशन, संख्यात्मक मान और इकाइयां, संदर्भ श्रेणियां, अपवाद पहचान और रिपोर्ट-स्तरीय निष्कर्ष अलग से सत्यापित किए जाते हैं। कम-रिज़ॉल्यूशन वाले नमूनों के लिए, सही व्यवहार "अविश्वसनीय रीडिंग" को चिह्नित करना और उचित मानों को स्वत: पूर्ण करने के बजाय कारण को बनाए रखना होना चाहिए। अनुलग्नक में निम्न-गुणवत्ता वाली रिपोर्ट छवियों की आवश्यकता भी इस बिंदु को दर्शाती है: सिस्टम को अस्पष्टताओं पर अनुमान लगाने के बजाय जानकारी में अंतराल को पहचानना सीखना होगा।
चिकित्सा गुणवत्ता को केवल फ़ील्ड पूर्णता दर को देखने के बजाय सिमेंटिक श्रृंखला की जांच करनी चाहिए
संरचित फ़ील्ड पूर्ण हैं, जिसका अर्थ यह नहीं है कि नमूने के नैदानिक शब्दार्थ सही हैं। रिपोर्ट की चिकित्सा श्रृंखला में कम से कम मूल परीक्षा परिणाम, इकाइयां और संदर्भ श्रेणियां, असामान्यता निर्णय, डॉक्टर के विवरण और सामान्य परीक्षा निष्कर्ष और सिफारिशें शामिल होती हैं। गुणवत्ता ऑडिट में पूछा जाना चाहिए: क्या असामान्यता की पहचान संख्यात्मक मूल्य और संदर्भ सीमा से मेल खाती है? क्या निष्कर्ष रिपोर्ट के पाठ द्वारा समर्थित हैं? क्या छवियों में दिए गए निष्कर्ष निष्कर्षों से मेल खाते हैं? क्या डिसेन्सिटाइजेशन महत्वपूर्ण चिकित्सा सामग्री को कवर करता है? क्या रिपोर्ट के विभिन्न पृष्ठों पर मरीज की उम्र, तारीखें या परीक्षण आइटम परस्पर विरोधी हैं? इन समस्याओं को आम तौर पर एक साधारण गैर-शून्य जांच द्वारा नहीं पकड़ा जा सकता है।
व्यापक शारीरिक परीक्षा रिपोर्ट के लिए, "प्रवेश लाल रेखा + उप-स्कोर" के दो-स्तरीय दृष्टिकोण को अपनाने की सिफारिश की गई है। लाल रेखा का उपयोग प्राधिकरण, गोपनीयता लीक, गंभीर पेज गायब, गायब छवियां, बेमेल और चिकित्सा तर्क त्रुटियों जैसे अस्वीकार्य मुद्दों को निर्धारित करने के लिए किया जाता है; लाल रेखा पार करने के बाद, रिपोर्ट को रिपोर्ट की पूर्णता, छवि गुणवत्ता, फ़ील्ड सटीकता, आइटम समृद्धि, विसंगति स्पष्टीकरण और अनुदैर्ध्य तुलना जैसे आयामों पर स्कोर किया जाता है। बुनियादी क्षेत्रों की लुप्त दर की गणना अलग से की जानी चाहिए, और चिकित्सा तर्क त्रुटियों की अलग से गणना की जानी चाहिए और औसत स्कोर के एक सेट द्वारा इसे कम नहीं किया जाना चाहिए। सभी संकेतकों को हर, नमूना इकाई, लापता मूल्य प्रसंस्करण और डुप्लिकेट नमूना कटौती नियमों को लिखना होगा।
खरीद मानक भी स्थिरता समीक्षा के अधीन है। उदाहरण के लिए, यदि कोई स्वीकृति दस्तावेज़ विभिन्न अध्यायों में "वैध चिकित्सा पृष्ठों की संख्या" के लिए अलग-अलग सीमाएँ अपनाता है, तो आपूर्तिकर्ता और स्वीकार करने वाली पार्टी प्रत्येक अलग-अलग सीमाएँ लागू कर सकती है। इसी प्रकार, "शारीरिक परीक्षा रिपोर्ट", "रिपोर्ट शीट" और "मामले की जानकारी" के लागू दायरे, छवि संलग्नक आवश्यकताओं और स्कोरिंग स्तरों को भी स्पष्ट रूप से परिभाषित किया जाना चाहिए। प्रत्येक आवश्यकता को एक अद्वितीय क्षेत्र या स्वीकृति आइटम में लागू करने और परिभाषा, पता लगाने की विधि, पारित करने की स्थिति, जिम्मेदार पक्ष और विवाद प्रबंधन प्रक्रिया प्रदान करने की अनुशंसा की जाती है। पीओसी चरण में, नियमों को सत्यापित करने के लिए प्रतिनिधि नमूनों के एक बैच का उपयोग किया जाता है। यदि सीमा विवाद पाए जाते हैं, तो बैच डिलीवरी में प्रवेश करने से पहले मानकों को संशोधित किया जाएगा।
छवि युग्मन और गोपनीयता प्रसंस्करण को डिलीवरी श्रृंखला का हिस्सा बनने की आवश्यकता है
जब रिपोर्ट में अल्ट्रासाउंड, सीटी, एमआरआई, एंडोस्कोपी या अन्य इमेजिंग परीक्षाओं का उल्लेख होता है, तो छवि फ़ाइलें उसी अनाम नमूने, समान परीक्षा और संबंधित पाठ विवरण के अनुरूप होने में सक्षम होनी चाहिए। स्वीकृति न केवल "फ़ोल्डर में चित्र हैं" पर आधारित है, बल्कि यह भी पुष्टि करती है कि निरीक्षण का समय, तौर-तरीके, स्थान और रिपोर्ट के निष्कर्ष एक दूसरे से मेल खाते हैं; डुप्लिकेट छवियां, गलत घाव मानचित्र और अप्रासंगिक अनुक्रम मॉडल सीखने में पूर्वाग्रह का कारण बन सकते हैं। यदि डिलीवरी में DICOM शामिल है, तो छवि अनुक्रम अखंडता, मुख्य मेटाडेटा और पहचान सूचना प्रसंस्करण की जाँच की जानी चाहिए; यदि डिलीवरी एक स्क्रीनशॉट या रिपोर्ट छवि है, तो रिज़ॉल्यूशन, दिशा, पाठ पठनीयता और छवि-पाठ पत्राचार सुनिश्चित किया जाना चाहिए।
डी-आइडेंटिफिकेशन केवल पीडीएफ बॉडी में नामों को कवर नहीं कर सकता है। व्यक्तिगत जानकारी हेडर और फ़ूटर, क्यूआर कोड, बारकोड, इमेज बर्निंग कैरेक्टर, डीआईसीओएम हेडर फ़ील्ड, स्कैन किए गए फ़ाइल नाम, दस्तावेज़ मुक्त टेक्स्ट या निर्यात निर्देशिकाओं में दिखाई दे सकती है। दूसरी ओर, तिथि, आयु, परीक्षा पैरामीटर और अनुदैर्ध्य संबंध अनुसंधान कार्य के लिए आवश्यक चर हो सकते हैं और जोखिम मूल्यांकन और प्राधिकरण के दायरे के आधार पर इसे संभाला जाना चाहिए। डिलीवरी के दोनों पक्षों को प्रसंस्करण के दायरे, प्रसंस्करण उपकरण या नियम, समीक्षा के तरीके, अपवाद प्रबंधन परिणाम और जिम्मेदारी आरोपण को रिकॉर्ड करना चाहिए; छवियों और दस्तावेज़ों की नमूना समीक्षाएँ आयोजित करें, और ऑडिट योग्य प्रसंस्करण लॉग रखें। DICOM मानक छवि डी-पहचान कॉन्फ़िगरेशन के लिए एक संदर्भ ढांचा प्रदान करता है, लेकिन छवि में एम्बेडेड पाठ, फ़ाइल के बाहर की जानकारी और विशिष्ट उपयोग परिदृश्यों के आधार पर वास्तविक कार्यान्वयन की अभी भी समीक्षा करने की आवश्यकता है।[1]
डेटा स्रोतों और अधिकृत सामग्रियों को प्रशिक्षण डेटा से अलग से प्रबंधित किया जाना चाहिए, लेकिन शासन स्तर पर जोड़ा जा सकता है। खरीद स्वीकृति न केवल आपूर्तिकर्ता के "असंवेदनशील" बयान पर निर्भर होनी चाहिए, बल्कि यह पुष्टि करनी चाहिए कि स्रोत विवरण, प्राधिकरण का दायरा, उपयोग प्रतिबंध और हस्तांतरण की शर्तें परियोजना की आवश्यकताओं को पूरा करती हैं; ऐसे डेटा के लिए जिसका स्रोत, प्राधिकरण या उद्देश्य अस्पष्ट है, पहले उपयोग को रोक दिया जाना चाहिए और स्पष्ट किया जाना चाहिए। नमूना डेटा पूल में प्रवेश करने से पहले, स्रोत रिकॉर्ड, प्रसंस्करण संस्करण और सामग्री सारांश भी तैयार किया जाना चाहिए ताकि उत्तर देने में असमर्थ होने से बचा जा सके "यह डेटा कहां से आता है, यह किस प्रसंस्करण से गुजरा है, और इसका उपयोग किन कार्यों के लिए किया जा सकता है।"
बैच जोखिमों को कम करने के लिए POC और स्तरीकृत नमूने का उपयोग करें
थोक खरीदारी से पहले, POC का उद्देश्य आपूर्तिकर्ता द्वारा चयनित सर्वोत्तम नमूना दिखाना नहीं है, बल्कि यह सत्यापित करना है कि संपूर्ण डिलीवरी प्रक्रिया दोहराई जा सकती है या नहीं। नमूने में रिपोर्ट प्रकार, विभिन्न प्रारूप, छवि गुणवत्ता, सामान्य बनाम असामान्य परिणाम, जटिल रूप, कई वर्षों के रिकॉर्ड और विभिन्न उपकरण स्रोत शामिल होने चाहिए। आपूर्तिकर्ता द्वारा पूर्व-स्क्रीन किए गए केवल आसानी से संसाधित डेटा को देखने से बचने के लिए नमूना सूची को मांग पक्ष की भागीदारी के साथ निर्धारित किया जाना चाहिए। पीओसी चरण अलग से प्रारूप, फ़ील्ड, छवि-पाठ पत्राचार, चिकित्सा शब्दार्थ, डिसेन्सिटाइजेशन और फ़ाइल मैपिंग की जांच करता है, आइटम-दर-आइटम दोषों को आउटपुट करता है और बंद लूप को ठीक करता है, और फिर निर्णय लेता है कि स्केल करना है या नहीं।
के बैच स्वीकृति में प्रवेश करने के बाद, समग्र पास दर के अलावा, प्रमुख उपसमूहों के प्रदर्शन पर भी ध्यान दिया जाना चाहिए। समग्र सटीकता एक निश्चित प्रकार की रिपोर्ट, एक निश्चित उपकरण, एक निश्चित प्रारूप या कम-परिभाषा नमूने में स्पष्ट खामियों को छिपा सकती है। स्तरीकृत नमूनाकरण रिपोर्टिंग श्रेणी, छवि गुणवत्ता, क्षेत्र जटिलता और स्रोत श्रेणी, प्रत्येक स्तर के लिए त्रुटि दर और आत्मविश्वास अंतराल की रिपोर्टिंग के आधार पर किया जा सकता है। एक-वोट वीटो मुद्दों के लिए पूरे मामले में वापसी या बैच निलंबन नियमों को अपनाना; सुधार योग्य मुद्दों के लिए समीक्षा अनुपात, पुन: कार्य समय सीमा और पुन: निरीक्षण मानक निर्धारित करें। विभिन्न बैचों में समस्याओं की पुनरावृत्ति को रोकने के लिए प्रत्येक संशोधन के लिए मूल संस्करण, संशोधित संस्करण और पुन: परीक्षण परिणाम को बरकरार रखा जाना चाहिए।
एल्गोरिथम परिप्रेक्ष्य से, नमूना विभाजन भी खरीद स्वीकृति डिजाइन से संबंधित है। यदि एक ही व्यक्ति की कई रिपोर्टें प्रशिक्षण सेट और परीक्षण सेट में बिखरी हुई हैं, तो मॉडल बार-बार सामग्री या व्यक्तिगत विशेषताओं के माध्यम से "उत्तर याद रख सकता है", जिसके परिणामस्वरूप उच्च सत्यापन परिणाम प्राप्त होते हैं। अनुदैर्ध्य कार्यों के लिए, डेटा सेट को रोगी द्वारा खंडित किया जाना चाहिए, और समय विभाजन स्पष्ट होना चाहिए; लेआउट पहचान के लिए, संग्रहों में समान टेम्पलेट के कारण होने वाले वितरण विचलन पर भी विचार किया जाना चाहिए। परीक्षण सेट को आदर्श रूप से कठिन उदाहरणों, निम्न-गुणवत्ता वाले नमूनों और वास्तविक लापता मामलों को बनाए रखना चाहिए, और परीक्षण लेबल को एक स्वतंत्र प्रक्रिया द्वारा प्रबंधित किया जाना चाहिए। खरीद, शासन और मॉडल मूल्यांकन के लिंकेज के माध्यम से, यह निर्धारित किया जा सकता है कि मॉडल में सुधार डेटा दोहराव या परीक्षण रिसाव के बजाय वास्तविक सामान्यीकरण से आता है।
गुणवत्ता संकेतकों को मॉडल जोखिमों के अनुसार मैप किया जाना चाहिए
विभिन्न त्रुटियों का मॉडल पर अलग-अलग प्रभाव पड़ता है। गलत उपशीर्षक पहचान, असामान्य परीक्षण मूल्यों की गलत रीडिंग, और विभिन्न रोगियों की रिपोर्टों का विलय, सभी को एक सामान्य फ़ील्ड त्रुटि के रूप में दर्ज नहीं किया जा सकता है। यह अनुशंसा की जाती है कि दोषों को गंभीरता के अनुसार वर्गीकृत किया जाए: त्रुटियां जो नैदानिक अर्थ या रोगी की विशेषता को बदल देंगी उन्हें गंभीर दोषों के रूप में सेट किया गया है; त्रुटियाँ जो मॉडल निर्णय को प्रभावित करती हैं लेकिन फिर भी मैन्युअल प्रक्रिया में पाई जा सकती हैं उन्हें प्रमुख दोषों के रूप में सेट किया गया है; प्रारूप के मुद्दे जो मूल शब्दार्थ को नहीं बदलते हैं उन्हें सामान्य दोष माना जाता है। प्रत्येक स्तर पर यह बताया जाना चाहिए कि कैसे गिनती की जाए, कैसे समीक्षा की जाए और कौन सी सुधारात्मक या अस्वीकृति कार्रवाइयां शुरू की जाएं। स्वीकृति रिपोर्ट में दोषों का वितरण प्रस्तुत किया जाना चाहिए, न कि केवल समग्र उत्तीर्ण दर।
"फ़ील्ड स्तर सटीकता दर" और "नमूना स्तर पास दर" के बीच अंतर करना भी आवश्यक है। एक फ़ील्ड निष्कर्षण कार्य सटीकता, रिकॉल, F1, संख्यात्मक अंतर सहनशीलता सीमा और फ़ील्ड स्थिति सटीकता की रिपोर्ट कर सकता है; एक रिपोर्ट की योग्यता आवश्यक फ़ील्ड, पूर्णता, संबंधित फ़ाइलों और चिकित्सा स्थिरता पर भी निर्भर करती है। यदि लाखों फ़ील्ड्स का औसत निकाला जाए, तो बड़ी संख्या में आसान फ़ील्ड्स द्वारा कुछ गंभीर त्रुटियाँ कम हो सकती हैं। एक बेहतर अभ्यास यह है कि रिपोर्टिंग श्रेणी और कठिनाई के आधार पर सूक्ष्म-औसत, मैक्रो-औसत, प्रमुख फ़ील्ड मेट्रिक्स और नमूना-स्तर पास अनुपात को एक साथ रिपोर्ट किया जाए। पूर्ण गुणवत्ता आश्वासन के रूप में एक छोटे नमूने के आकस्मिक उच्च स्कोर को बढ़ावा देने से बचने के लिए नमूना परिणामों के लिए नमूना पद्धति और अनुमानित अनिश्चितता भी दी जानी चाहिए।
डेटा वितरण के लिए भी गुणवत्ता नियंत्रण की आवश्यकता होती है। लिंग, आयु समूह, विभाग, परीक्षा प्रकार, असामान्य स्थिति, संस्था और रिपोर्ट प्रारूप का अनुपात मॉडल लक्ष्यों के लिए प्रासंगिक हो सकता है। डेटा संग्रह के दौरान कठिन उदाहरणों को उजागर करने के लिए संवर्धन प्रशिक्षण दक्षता में सुधार कर सकता है, लेकिन समग्र नमूना संरचना को बदल देता है; यदि मूल्यांकन सेट के लिए समान संवर्धन विधि का उपयोग किया जाता है, तो परिणाम सामान्य उपयोग परिदृश्यों का प्रतिनिधित्व नहीं कर सकते हैं।"प्रवीणता परीक्षण के लिए चुनौती सेट" और "लक्ष्य उपयोग परिदृश्य के करीब प्रतिनिधि मूल्यांकन सेट" दोनों को बनाए रखने और दोनों की चयन विधि को स्पष्ट करने की सिफारिश की गई है। दुर्लभ श्रेणियों के लिए, कम संख्या में नमूनों के आधार पर नियतात्मक निष्कर्ष निकालने से बचने के लिए सही नमूना आकार और आत्मविश्वास अंतराल की सूचना दी जानी चाहिए।
आपूर्ति और एनोटेशन प्रक्रिया में डेटा दोषों पर लूप बंद करें
स्वीकृति परिणाम केवल क्रेता की कटौती या रिटर्न रिकॉर्ड पर नहीं रुक सकता। प्रत्येक दोष का उसके मूल से पता लगाया जाना चाहिए: क्या स्रोत स्क्रीनिंग परिभाषा को पूरा नहीं करती है, क्या स्कैन अधिग्रहण छवि विरूपण का कारण बनता है, क्या ओसीआर कॉलम संबंधों को गलत बनाता है, क्या डी-आइडेंटिफिकेशन नियम चिकित्सा मूल्यों को अस्पष्ट करते हैं, क्या मैन्युअल समीक्षा छूट जाती है, क्या डिलीवरी परिवर्तन फ़ील्ड या पथ को नष्ट कर देता है। दोष के कारण को बैच, प्रसंस्करण संस्करण और जिम्मेदार लिंक के साथ जोड़ने के बाद, परियोजना टीम यह निर्धारित कर सकती है कि संग्रह विनिर्देशों, प्रसंस्करण नियमों, लेबलिंग प्रशिक्षण, या फ़ाइल पैकेजिंग प्रक्रिया को बदलना है या नहीं।
यह अनुशंसा की जाती है कि डिलीवरी के प्रत्येक बैच में फ़ाइल हैश या चेकसम मान, अनाम नमूना कुंजी, फ़ाइल प्रकार, पीढ़ी का समय, प्रसंस्करण संस्करण, सहसंबंध जांच घटना और समीक्षा स्थिति को रिकॉर्ड करने वाली मशीन-पठनीय मैनिफ़ेस्ट हो। संशोधनों के लिए, मूल फ़ाइल को सीधे अधिलेखित नहीं किया जाना चाहिए, बल्कि पुराने और नए संस्करणों के बीच संबंध और संशोधन के कारणों को दर्ज किया जाना चाहिए। जब आवश्यकताएं बदलती हैं, तो एक ही प्रोजेक्ट के विभिन्न बैचों के लिए अंतर्निहित नियमों के सेट का उपयोग करने से बचने के लिए मानक संस्करण संख्या, प्रभावी तिथि और प्रभावित बैचों को बरकरार रखा जाता है। दीर्घकालिक सहयोग के लिए, पुनर्खरीद का मतलब केवल पिछले बैच के प्रारूप की प्रतिलिपि बनाना नहीं है, बल्कि इनपुट के रूप में समस्या सूची का उपयोग करके फ़ील्ड परिभाषाओं और कठिन केस कवरेज को लगातार अपडेट करना है।
लैंगहुई का डिलीवरी विचार सत्यापन योग्य नियमों से शुरू होना चाहिए
चिकित्सा डेटा खरीद की व्यावसायिकता इस बात पर निर्भर नहीं करती है कि आवश्यकता दस्तावेज कितने समय तक लिखा गया है, बल्कि इस पर निर्भर करता है कि क्या लक्ष्यों को निष्पादन योग्य नमूना परिभाषाओं, क्षेत्र विनिर्देशों, गुणवत्ता संकेतकों, पीओसी प्रक्रियाओं और बैच स्वीकृति साक्ष्य में परिवर्तित किया जा सकता है। लैंगहुई की चिकित्सा डेटा परियोजनाओं की बाहरी अभिव्यक्ति विशेष रूप से आवश्यकता पृथक्करण, डेटा संरचना डिजाइन, चिकित्सा गुणवत्ता नियंत्रण, डी-पहचान समीक्षा और स्वीकृति बंद लूप के चरणों में आ सकती है; प्रत्येक प्रोजेक्ट उसके प्राधिकरण, नमूनों, कार्यों और स्वीकृति नियमों के आधार पर वास्तविक वितरण दायरा निर्धारित करता है। ऐसा बयान न केवल इंजीनियरिंग क्षमताओं को प्रतिबिंबित कर सकता है, बल्कि एक निश्चित खरीद परियोजना की सीमा को गलती से सभी ग्राहकों के लिए सार्वभौमिक प्रतिबद्धता के रूप में लिखे जाने से भी रोक सकता है।
एक परिपक्व खरीद समाधान अंततः एल्गोरिदम इंजीनियरों को सीधे पढ़ने योग्य फ़ाइलें और फ़ील्ड प्राप्त करने की अनुमति देगा, चिकित्सा विशेषज्ञों को संदर्भ और नैदानिक तर्क की समीक्षा करने की अनुमति देगा, और खरीद और अनुपालन कर्मियों को स्रोतों, प्राधिकरणों और स्वीकृति निष्कर्षों का पता लगाने की अनुमति देगा। रिपोर्टों की संख्या केवल प्रवेश द्वार है; रिपोर्ट के बीच, रिपोर्ट और छवियों के बीच, और फ़ील्ड और मूल पाठ के बीच संबंध यह निर्धारित करता है कि यह एक विश्वसनीय डेटा संपत्ति है या नहीं।
अक्सर पूछे जाने वाले प्रश्न
क्या मेडिकल एआई प्रशिक्षण डेटा की स्वीकृति के लिए केवल क्षेत्र सटीकता को देखना पर्याप्त है? पर्याप्त नहीं। नमूना परिभाषा, स्रोत प्राधिकरण, दस्तावेज़ीकरण पूर्णता, छवि गुणवत्ता, चित्र-से-पाठ पत्राचार, चिकित्सा शब्दार्थ, डी-पहचान, दोहराव दर और रोगी-स्तर विभाजन जैसी चीज़ों की भी जाँच की जानी चाहिए, और उच्च जोखिम वाले दोषों के लिए अलग नियम स्थापित किए जाने चाहिए।
मेडिकल रिपोर्ट के OCR को अस्पष्ट क्षेत्रों को कैसे संभालना चाहिए? ऐसी सामग्री को अनिश्चित के रूप में चिह्नित करें जिसे विश्वसनीय रूप से पहचाना नहीं जा सकता है, मूल छवि स्थान और आत्मविश्वास बनाए रखें, और मैन्युअल समीक्षा या उन्मूलन प्रक्रिया में प्रवेश करें। केवल संदर्भ के आधार पर चेक मानों, अपवाद फ़्लैग और नैदानिक निष्कर्षों का अनुमान न लगाएं। प्रतिनिधि बनने के लिए
प्रतिनिधि POC नमूने कैसे चुने जाने चाहिए? अपेक्षित कार्यों के अनुसार सामान्य और दुर्लभ लेआउट, विभिन्न रिपोर्ट प्रकार, असामान्य और सामान्य, स्पष्ट और कम परिभाषा, जटिल तालिकाओं और छवि सहसंबंधों को कवर करें, और केवल चयनित नमूनों का उपयोग करने से बचने के लिए यादृच्छिक नमूने बनाए रखें जिन्हें पारित करना आसान है।
संदर्भ
[1] DICOM PS3.15 2025e, सुरक्षा और सिस्टम प्रबंधन प्रोफाइल, परिशिष्ट ई: विशेषता गोपनीयता प्रोफाइल।https://dicom.nema.org/medical/dicom/2025e/output/html/part15.html
[2] मोंगन जे, एट अल। मेडिकल इमेजिंग में आर्टिफिशियल इंटेलिजेंस के लिए चेकलिस्ट (दावा): 2024 अपडेट। रेडियोलॉजी: आर्टिफिशियल इंटेलिजेंस. https://pmc.ncbi.nlm.nih.gov/articles/PMC11304031/
[3] STARD-AI स्टीयरिंग ग्रुप। कृत्रिम बुद्धिमत्ता का उपयोग करके नैदानिक सटीकता अध्ययन के लिए STARD-AI रिपोर्टिंग दिशानिर्देश। प्राकृतिक चिकित्सा, 2025. https://doi.org/10.1038/s41591-025-03953-8