Primero defina la unidad de datos y luego analice la cantidad de compra.
Un informe de examen físico puede ser un informe completo de un año completo o puede ser solo un formulario de informe único para un examen determinado. Ambos son archivos PDF o imágenes en la superficie, pero las tareas de capacitación son completamente diferentes: el primero se puede usar para comprender informes, inducir riesgos y analizar cambios entre años; este último suele servir para OCR, extracción de campos, identificación de anomalías o comprensión de informes de imágenes. Si la unidad de muestra, el contenido mínimo a entregar y las tareas esperadas no se determinan antes de la consulta, los proveedores pueden interpretarlos individualmente en términos de "páginas", "hojas" y "partes". La cantidad final puede parecer suficiente, pero el modelo carece de un contexto completo.
Por lo tanto, los requisitos de adquisición deben deducirse de la definición de datos de "lo que el modelo quiere aprender". Si el objetivo es analizar indicadores de inspección, la unidad más pequeña puede ser "un indicador y su contexto de informe"; si el objetivo es comprender la conclusión de un examen físico, la unidad de muestra debe incluir el texto del informe, sugerencias de conclusión y los materiales de examen correspondientes; Si el objetivo es conocer los cambios longitudinales en la salud, varios informes del mismo individuo anónimo deben estar relacionados de manera estable. El calibre cuantitativo debe describir simultáneamente el número de pacientes, el número de visitas médicas o exámenes físicos, el número de archivos, el número de páginas y el número de secuencias de imágenes. Estas unidades no se pueden mezclar en una cantidad total. Los tipos de demanda en el archivo adjunto
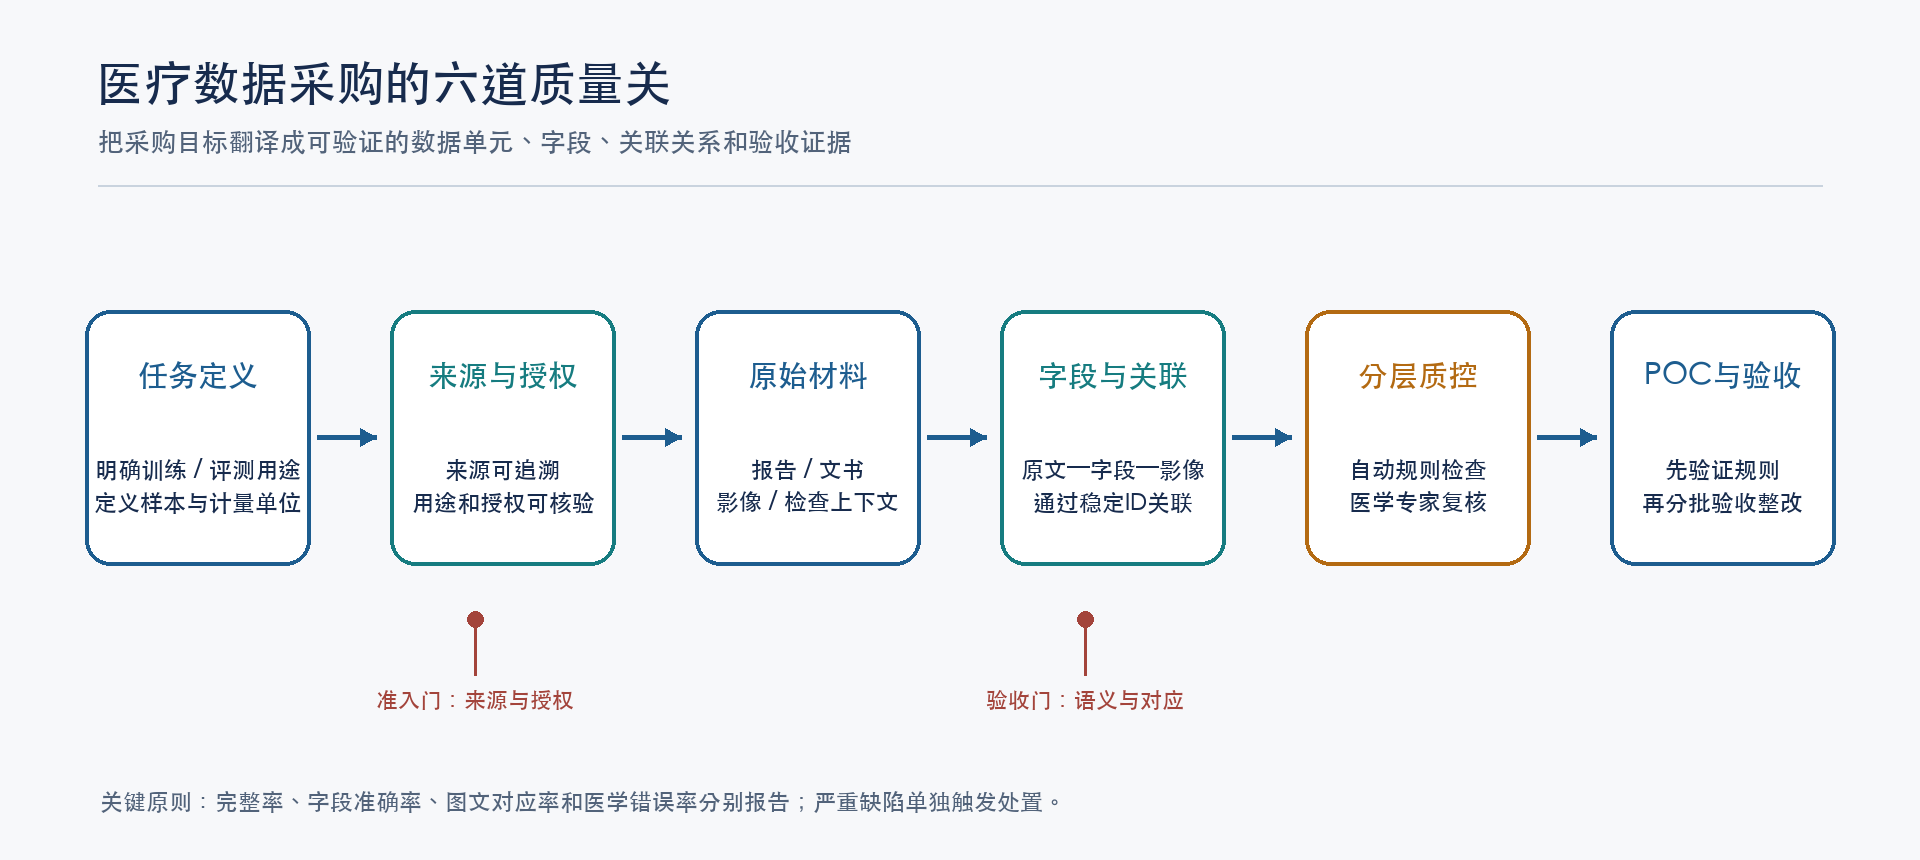
cubren diferentes objetos de procesamiento, como informes de exámenes físicos completos, hojas de informes, hojas de informes más contexto de casos, OCR de formularios complejos, corpus de texto, libros médicos y materiales de conocimiento. No pueden compartir un formulario de aceptación. Un paquete de adquisiciones razonable debe primero dividirse según el propósito y luego definir unidades de datos, campos obligatorios, archivos originales, claves asociadas, umbrales de calidad y métodos de muestreo para cada categoría. Esto puede reducir el retrabajo posterior y facilitar que el equipo del modelo determine qué muestras son adecuadas para el entrenamiento, cuáles son adecuadas para la verificación y cuáles solo son adecuadas para la recuperación de conocimientos.
Refinar "informado" en campos de aceptación ejecutables
La disponibilidad de los informes médicos no es simplemente "se puede abrir". Es necesario verificar el tipo de informe, el tipo de institución de origen, la fecha de inspección, la identificación anónima de la muestra, el texto del informe, los elementos de inspección, los resultados, las unidades, los intervalos de referencia, los indicadores anormales, las recomendaciones de conclusión y el mapeo entre archivos y registros estructurados. Para las inspecciones de imágenes, también se debe registrar la relación entre la modalidad, el sitio de inspección, la secuencia o identificación de la imagen, la fecha de la inspección, el informe de la imagen y la imagen original correspondiente. La lista de campos debe distinguir entre obligatorio, condicionalmente obligatorio y opcional, y explicar cómo codificar valores nulos, desconocidos, no marcados y no identificados, respectivamente. Si el paquete de datos también contiene una institución médica o un directorio de información de médicos, se debe registrar la fuente de la información, la afiliación de la institución y el departamento, el tiempo de actualización del campo y el alcance de la aplicación; Los campos dinámicos como la programación de turnos, las visitas a domicilio o las fuentes de números deben tener un ciclo de actualización claro, y la disponibilidad actual no puede juzgarse únicamente por la tasa de finalización de los campos estáticos.
Se recomienda conservar tres niveles de contenido. La primera capa es el documento original para asegurar la trazabilidad posterior; la segunda capa es una transcripción fiel o texto OCR, que marca caracteres no confirmados y áreas inciertas; la tercera capa son campos estandarizados, que guardan los resultados del mapeo de unidades, términos o codificaciones estándar. Debe haber una ID de muestra y un mapeo de ubicación entre las tres capas, y no solo se pueden conservar los "resultados limpios" que han sido procesados por el modelo o manualmente. Los valores originales y los valores estandarizados se guardan en columnas separadas, y la conversión estandarizada conserva las reglas y versiones para que se puedan distinguir la información médica original y los resultados del procesamiento de ingeniería.
En particular, evite tomar la confianza del OCR como precisión médica. El reconocimiento de diseño puede desalinear las columnas de la tabla, el reconocimiento numérico puede omitir puntos decimales, los intervalos de referencia pueden intercambiarse con indicadores adyacentes y también pueden omitirse flechas anormales. El control de calidad debe diseñar verificaciones basadas en tipos de errores: el reconocimiento de caracteres, el posicionamiento de las celdas, la atribución de campos, los valores y unidades numéricos, los rangos de referencia, la identificación de excepciones y las conclusiones a nivel de informe se verifican por separado. Para muestras de baja resolución, el comportamiento correcto debería ser marcar "lectura no confiable" y conservar el motivo, en lugar de autocompletar valores aparentemente razonables. El requisito de incluir imágenes de informes de baja calidad en los archivos adjuntos también ilustra este punto: los sistemas deben aprender a reconocer lagunas en la información en lugar de adivinar las ambigüedades.
La calidad médica debe verificar la cadena semántica en lugar de simplemente observar la tasa de finalización del campo
Los campos estructurados están completos, lo que no significa que la semántica clínica de la muestra sea correcta. La cadena médica de un informe incluye al menos los resultados del examen original, las unidades y rangos de referencia, los juicios de anomalías, las descripciones del médico y las conclusiones y recomendaciones generales del examen. Las auditorías de calidad deberían preguntar: ¿La identificación de anomalías coincide con el valor numérico y el rango de referencia?¿Las conclusiones están respaldadas por el texto del informe?¿Los hallazgos en las imágenes corresponden a las conclusiones?¿La desensibilización cubre contenidos médicos importantes?¿Las edades, fechas o elementos de la prueba de los pacientes entran en conflicto en diferentes páginas del informe? Por lo general, estos problemas no pueden detectarse mediante una simple verificación no nula.
Para el informe del examen físico completo, se recomienda adoptar un enfoque de dos niveles: "línea roja de admisión + puntuación secundaria". La línea roja se utiliza para determinar problemas inaceptables como autorización, filtraciones de privacidad, faltas graves de páginas, imágenes faltantes, discrepancias y errores de lógica médica; Después de pasar la línea roja, el informe se califica en dimensiones como la integridad del informe, la calidad de la imagen, la precisión del campo, la riqueza de elementos, la explicación de anomalías y la comparación longitudinal. La tasa de falta de campos básicos debe calcularse por separado, y los errores de lógica médica deben contarse por separado y no deben diluirse en un conjunto de puntuaciones promedio. Todos los indicadores deben anotar el denominador, la unidad de muestreo, el procesamiento de valores faltantes y las reglas de deduplicación de muestras duplicadas. El propio estándar de adquisiciones
también está sujeto a una revisión de coherencia. Por ejemplo, si un documento de aceptación adopta diferentes umbrales para el "número de páginas médicas válidas" en diferentes capítulos, el proveedor y la parte aceptante pueden implementar umbrales diferentes. De manera similar, también se deben definir claramente el alcance aplicable, los requisitos para adjuntar imágenes y los niveles de puntuación del "informe de examen físico", la "hoja de informe" y la "información del caso". Se recomienda implementar cada requisito en un campo único o elemento de aceptación y proporcionar la definición, el método de detección, las condiciones de aprobación, la parte responsable y el proceso de manejo de disputas. En la etapa POC, se utiliza un lote de muestras representativas para verificar las reglas. Si se encuentran conflictos de umbral, los estándares se revisarán primero antes de ingresar a la entrega por lotes.
El emparejamiento de imágenes y el procesamiento de privacidad deben ser parte de la cadena de entrega
Cuando el informe menciona ecografía, tomografía computarizada, resonancia magnética, endoscopia u otros exámenes de imágenes, los archivos de imágenes deben poder corresponder a la misma muestra anónima, el mismo examen y la descripción textual correspondiente. La aceptación no solo se basa en "hay imágenes en la carpeta", sino que también confirma que el tiempo de inspección, la modalidad, la ubicación y las conclusiones del informe coinciden entre sí; Las imágenes duplicadas, los mapas de lesiones incorrectos y las secuencias irrelevantes pueden provocar un sesgo en el aprendizaje del modelo. Si la entrega contiene DICOM, se debe verificar la integridad de la secuencia de imágenes, los metadatos clave y el procesamiento de la información de identificación; si la entrega es una captura de pantalla o una imagen de informe, se debe garantizar la resolución, dirección, legibilidad del texto y correspondencia imagen-texto.
La desidentificación no puede cubrir solo los nombres en el cuerpo del PDF. La información personal puede aparecer en encabezados y pies de página, códigos QR, códigos de barras, caracteres de grabación de imágenes, campos de encabezado DICOM, nombres de archivos escaneados, texto libre de documentos o directorios de exportación. Por otro lado, la fecha, la edad, los parámetros del examen y las asociaciones longitudinales pueden ser variables necesarias para la tarea de investigación y deben manejarse de manera basada en la evaluación de riesgos y el alcance de la autorización. Ambas partes de la entrega deben registrar el alcance del procesamiento, las herramientas o reglas de procesamiento, los métodos de revisión, los resultados del manejo de excepciones y la atribución de responsabilidad; realizar revisiones de muestreo de imágenes y documentos, y mantener registros de procesamiento auditables. El estándar DICOM proporciona un marco de referencia para la configuración de desidentificación de imágenes, pero la implementación real aún debe revisarse en función del texto incrustado en la imagen, la información fuera del archivo y los escenarios de uso específicos.[1]
Las fuentes de datos y los materiales autorizados deben gestionarse por separado de los datos de capacitación, pero pueden vincularse en el nivel de gobernanza. La aceptación de la adquisición no sólo debe basarse en la declaración "insensibilizada" del proveedor, sino que también debe confirmar que la descripción de la fuente, el alcance de la autorización, las restricciones de uso y las condiciones de transferencia cumplen con los requisitos del proyecto; Para los datos cuya fuente, autorización o propósito no está claro, el uso debe congelarse y aclararse primero. Antes de que la muestra ingrese al conjunto de datos, también se deben generar registros fuente, versiones de procesamiento y resúmenes de contenido para evitar no poder responder "de dónde provienen estos datos, qué procesamiento se ha sometido y para qué tareas se pueden utilizar".
Utilice POC y muestreo estratificado para reducir los riesgos de los lotes
Antes de la compra al por mayor, el propósito de POC no es mostrar la mejor muestra seleccionada por el proveedor, sino verificar si todo el proceso de entrega es repetible. El muestreo debe cubrir tipos de informes, diferentes formatos, calidad de imagen, resultados normales versus anormales, formularios complejos, registros que abarcan varios años y diferentes fuentes de equipos. La lista de muestras debe determinarse con la participación del lado de la demanda para evitar ver sólo datos fácilmente procesados y previamente seleccionados por el proveedor. La etapa POC verifica por separado el formato, los campos, la correspondencia imagen-texto, la semántica médica, la desensibilización y el mapeo de archivos, genera defectos artículo por artículo y corrige el circuito cerrado, y luego decide si se debe ampliar. Después de que
ingrese a la aceptación del lote, además de la tasa de aprobación general, también se debe prestar atención al desempeño de los subgrupos clave. La precisión general puede enmascarar fallas obvias en cierto tipo de informe, cierto dispositivo, cierto formato o una muestra de baja definición. El muestreo estratificado se puede realizar informando la categoría, la calidad de la imagen, la complejidad del campo y la categoría de la fuente, informando las tasas de error y los intervalos de confianza para cada estrato. Adoptar reglas de devolución de casos completos o suspensión de lotes para cuestiones de veto de un voto; establezca índices de revisión, límites de tiempo de retrabajo y estándares de reinspección para problemas solucionables. La versión original, la versión modificada y los resultados de las nuevas pruebas deben conservarse para cada revisión para evitar que se repitan problemas en diferentes lotes.
Desde una perspectiva algorítmica, la segmentación de muestras también pertenece al diseño de aceptación de adquisiciones. Si se distribuyen varios informes de la misma persona en el conjunto de entrenamiento y el conjunto de prueba, el modelo puede "recordar la respuesta" a través de contenido repetido o características personales, lo que da como resultado resultados de validación más altos. Para tareas longitudinales, el conjunto de datos debe segmentarse por paciente y la segmentación temporal debe ser clara; para el reconocimiento del diseño, también se debe considerar la desviación de distribución causada por la misma plantilla en todas las colecciones. Idealmente, el conjunto de pruebas debería conservar ejemplos difíciles, muestras de baja calidad y casos verdaderos faltantes, y las etiquetas de prueba deberían gestionarse mediante un proceso independiente. A través de la vinculación de adquisiciones, gobernanza y evaluación de modelos, se puede determinar que la mejora del modelo proviene de una verdadera generalización en lugar de la duplicación de datos o la fuga de pruebas.
Los indicadores de calidad deben asignarse a los riesgos del modelo.
Diferentes errores tienen diferentes efectos en el modelo. La identificación de subtítulos mal colocados, la lectura incorrecta de valores de prueba anormales y la combinación de informes de diferentes pacientes no pueden registrarse como errores de campo comunes. Se recomienda clasificar los defectos según su gravedad: los errores que cambiarán el significado clínico o la atribución del paciente se consideran defectos críticos; los errores que afectan el juicio del modelo pero que aún se pueden encontrar en el proceso manual se consideran defectos importantes; Los problemas de formato que no cambian la semántica central se consideran defectos generales. Cada nivel debe explicar cómo contar, cómo revisar y qué acciones correctivas o de rechazo se activan. El informe de aceptación debe presentar una distribución de defectos, no sólo una tasa de aprobación general.
También es necesario distinguir entre "tasa de precisión a nivel de campo" y "tasa de aprobación a nivel de muestra". Una tarea de extracción de campo puede informar precisión, recuperación, F1, rango de tolerancia de diferencia numérica y precisión de posicionamiento de campo; La calificación de un informe también depende de los campos obligatorios, la integridad, los archivos asociados y la coherencia médica. Si simplemente se promedian millones de campos, algunos errores graves pueden quedar diluidos por un gran número de campos fáciles. Una mejor práctica es informar micropromedios, macropromedios, métricas de campo clave y proporciones de aprobación a nivel de muestra simultáneamente, estratificados por categoría de informe y dificultad. También se deben proporcionar el método de muestreo y la incertidumbre estimada para los resultados del muestreo para evitar promover puntuaciones altas accidentales de una muestra pequeña como garantía total de calidad.
La propia distribución de datos también requiere control de calidad. Las proporciones de género, grupo de edad, departamento, tipo de examen, estado anormal, institución y formato del informe pueden ser relevantes para los objetivos del modelo. El enriquecimiento para resaltar ejemplos difíciles durante la recopilación de datos puede mejorar la eficiencia de la capacitación, pero cambia la estructura general de la muestra; Si se utiliza el mismo método de enriquecimiento para el conjunto de evaluación, los resultados no pueden representar escenarios de uso generales. Se recomienda mantener tanto un "conjunto de desafíos para pruebas de competencia" como un "conjunto de evaluación representativo cercano al escenario de uso objetivo", y aclarar el método de selección de los dos. Para categorías poco comunes, se debe informar el tamaño real de la muestra y el intervalo de confianza para evitar sacar conclusiones deterministas basadas en una pequeña cantidad de muestras.
Cerrar el círculo de defectos de datos en el proceso de suministro y anotación
El resultado de la aceptación no puede detenerse simplemente en el registro de deducciones o devoluciones del comprador. Cada defecto debe rastrearse hasta su origen: si la detección de la fuente no cumple con la definición, si la adquisición del escaneo causa distorsión de la imagen, si el OCR establece relaciones incorrectas entre las columnas, si las reglas de desidentificación oscurecen los valores médicos, si se omite la revisión manual, si la transformación de entrega destruye campos o rutas. Después de asociar la causa del defecto con el lote, la versión de procesamiento y el enlace responsable, el equipo del proyecto puede determinar si se deben cambiar las especificaciones de recopilación, las reglas de procesamiento, la capacitación en etiquetado o el proceso de empaquetado de archivos.
Se recomienda que cada lote de entrega tenga un manifiesto legible por máquina que registre el valor hash o de suma de verificación del archivo, la clave de muestra anónima, el tipo de archivo, el tiempo de generación, la versión de procesamiento, el evento de verificación de correlación y el estado de revisión. Para las revisiones, el archivo original no debe sobrescribirse directamente, pero se debe registrar la relación entre la versión antigua y la nueva y los motivos de la modificación. Cuando los requisitos cambian, el número de versión estándar, la fecha de vigencia y los lotes afectados se conservan para evitar el uso de un conjunto de reglas implícitas para diferentes lotes del mismo proyecto. Para una cooperación a largo plazo, la recompra no significa simplemente copiar el formato del lote anterior, sino actualizar continuamente las definiciones de campo y la cobertura de casos difíciles utilizando la lista de problemas como entrada.
La idea de entrega de Langhui debería comenzar con reglas verificables
La profesionalidad de la adquisición de datos médicos no depende de cuánto tiempo esté escrito el documento de requisitos, sino de si los objetivos se pueden convertir en definiciones de muestras ejecutables, especificaciones de campo, indicadores de calidad, procesos POC y evidencia de aceptación de lotes. La expresión externa de Langhui de proyectos de datos médicos puede caer específicamente en los pasos de desmontaje de requisitos, diseño de estructura de datos, control de calidad médica, revisión de desidentificación y circuito cerrado de aceptación; Luego, cada proyecto determina el alcance de entrega real en función de su autorización, muestras, tareas y reglas de aceptación. Tal declaración no sólo puede reflejar las capacidades de ingeniería, sino también evitar que el umbral de un determinado proyecto de adquisición se escriba erróneamente como un compromiso universal para todos los clientes.
Una solución de adquisiciones madura permitirá en última instancia a los ingenieros de algoritmos obtener archivos y campos directamente legibles, permitirá a los expertos médicos revisar el contexto y la lógica clínica, y permitirá al personal de adquisiciones y cumplimiento rastrear fuentes, autorizaciones y conclusiones de aceptación. La cantidad de informes es sólo la entrada; la relación entre informes, entre informes e imágenes, y entre campos y texto original determina si se trata de un activo de datos confiable. Preguntas frecuentes sobre
Preguntas frecuentes
¿Es suficiente observar únicamente la precisión del campo para aceptar los datos de entrenamiento de IA médica? No es suficiente. También se deben verificar aspectos como la definición de la muestra, la autorización de la fuente, la integridad de la documentación, la calidad de la imagen, la correspondencia entre imagen y texto, la semántica médica, la desidentificación, la tasa de duplicación y la segmentación a nivel de paciente, y se deben establecer reglas separadas para los defectos de alto riesgo.
¿Cómo debe manejar el OCR de informes médicos las áreas borrosas? Marque el contenido que no pueda identificarse de forma fiable como incierto, conserve la ubicación y la confianza de la imagen original y entre en el proceso de revisión o eliminación manual. No adivine los valores de verificación, los indicadores de excepción y las conclusiones de diagnóstico basándose únicamente en el contexto. ¿Cómo seleccionar muestras POC
¿Cómo se deben seleccionar muestras de POC representativas? Cubre diseños comunes y raros, diferentes tipos de informes, anormales y normales, claros y de baja definición, tablas complejas y correlaciones de imágenes de acuerdo con las tareas esperadas, y conserva muestras aleatorias para evitar usar solo muestras seleccionadas que sean fáciles de aprobar.
Referencias
[1] DICOM PS3.15 2025e, Perfiles de administración del sistema y seguridad, Apéndice E: Perfiles de confidencialidad de atributos.https://dicom.nema.org/medical/dicom/2025e/output/html/part15.html
[2] Mongan J, et al. Lista de verificación para inteligencia artificial en imágenes médicas (CLAIM): actualización 2024. Radiología: Inteligencia Artificial. https://pmc.ncbi.nlm.nih.gov/articles/PMC11304031/
[3] Grupo directivo STARD-AI. La guía de informes STARD-AI para estudios de precisión diagnóstica que utilizan inteligencia artificial. Medicina natural, 2025. https://doi.org/10.1038/s41591-025-03953-8