Définissez d'abord l'unité de données, puis discutez de la quantité achetée.
Un rapport d'examen physique peut être un rapport complet pour une année complète, ou il peut s'agir simplement d'un formulaire de rapport unique pour un examen donné. Les deux sont des PDF ou des images en surface, mais les tâches de formation sont complètement différentes : la première peut être utilisée pour la compréhension des rapports, l'induction des risques et l'analyse des changements sur une année ; ce dernier sert généralement à l'OCR, à l'extraction de champs, à l'identification d'anomalies ou à la compréhension de rapports d'images. Si l'unité d'échantillonnage, le contenu minimum livrable et les tâches attendues ne sont pas déterminés avant la demande, les fournisseurs peuvent les interpréter individuellement en termes de « pages », de « feuilles » et de « pièces ». La quantité finale peut sembler suffisante, mais le modèle manque de contexte complet.
Par conséquent, les exigences en matière d'approvisionnement doivent être déduites de la définition des données à partir de « ce que le modèle veut apprendre ». Si l'objectif est d'analyser des indicateurs d'inspection, la plus petite unité peut être « un indicateur et son contexte de rapport » ; si l'objectif est de comprendre une conclusion d'un examen physique, l'unité d'échantillonnage doit inclure le texte du rapport, les suggestions de conclusion et le matériel d'examen correspondant ; si l’objectif est d’apprendre les changements longitudinaux en matière de santé, plusieurs rapports provenant de la même personne anonyme doivent être liés de manière stable. Le calibre quantitatif doit décrire simultanément le nombre de patients, le nombre de visites médicales ou d’examens physiques, le nombre de dossiers, le nombre de pages et le nombre de séquences d’images. Ces unités ne peuvent pas être mélangées à un montant total. Les types de demandes dans la pièce jointe
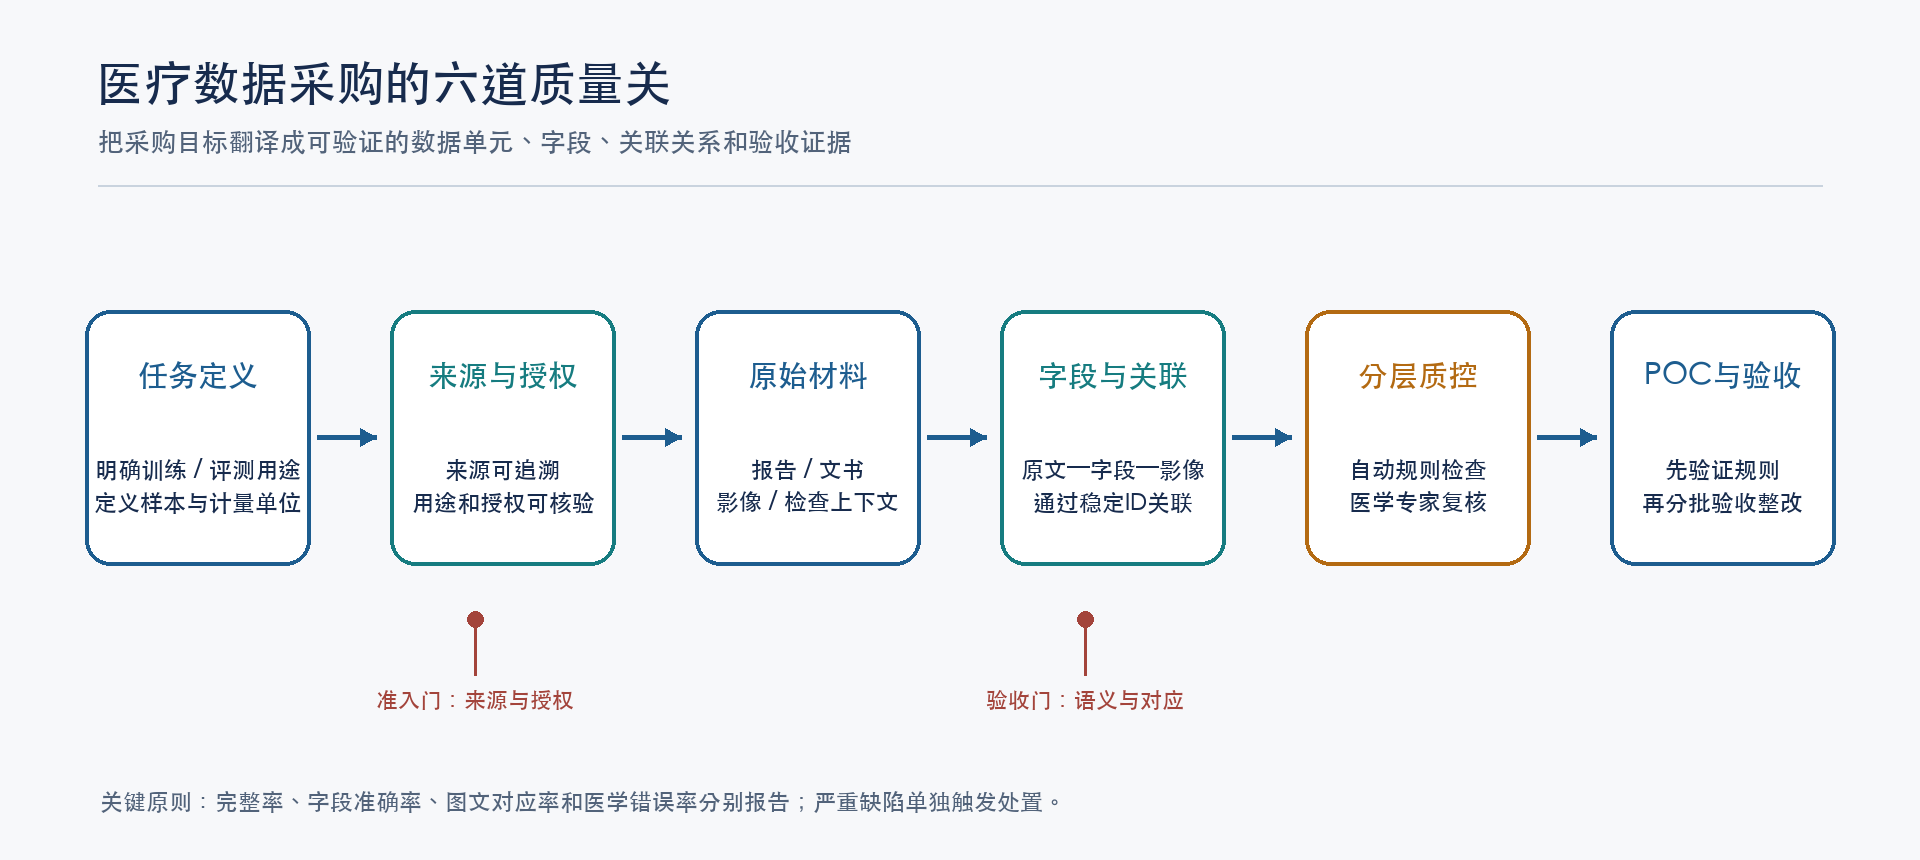
couvrent différents objets de traitement tels que les rapports d'examen physique complets, les feuilles de rapport, les feuilles de rapport plus le contexte du cas, l'OCR de formulaires complexes, le corpus de textes, les livres médicaux et les supports de connaissances. Ils ne peuvent pas partager un formulaire d’acceptation. Un package d'achat raisonnable doit d'abord être divisé en fonction de l'objectif, puis définir les unités de données, les champs obligatoires, les fichiers originaux, les clés associées, les seuils de qualité et les méthodes d'échantillonnage pour chaque catégorie. Cela peut réduire les retouches ultérieures et permettre à l'équipe de modèle de déterminer plus facilement quels échantillons conviennent à la formation, lesquels conviennent à la vérification et lesquels conviennent uniquement à la récupération des connaissances.
Affiner « signalé » dans les champs d'acceptation exécutables
La disponibilité des rapports médicaux ne peut pas simplement être « ouverte ». Il est nécessaire de vérifier le type de rapport, le type d'institution source, la date d'inspection, l'échantillon d'identification anonyme, le texte du rapport, les éléments d'inspection, les résultats, les unités, les intervalles de référence, les indicateurs anormaux, les recommandations de conclusion et le mappage entre les fichiers et les enregistrements structurés. Pour les inspections d'images, la relation entre la modalité, le site d'inspection, l'identification de la séquence ou de l'image, la date d'inspection, le rapport d'image et l'image originale correspondante doit également être enregistrée. La liste des champs doit faire la distinction entre les valeurs obligatoires, obligatoires sous condition et facultatives, et expliquer comment coder respectivement les valeurs nulles, inconnues, non cochées et non identifiées. Si le paquet de données contient également un répertoire d'informations sur les établissements médicaux ou les médecins, la source des informations, l'affiliation de l'établissement et du département, l'heure de mise à jour sur le terrain et le champ d'application doivent être enregistrés ; les champs dynamiques tels que la planification des équipes, les visites à domicile ou les sources de numéros doivent avoir un cycle de rafraîchissement clair, et la disponibilité actuelle ne peut pas être jugée uniquement sur le taux de complétion des champs statiques.
Il est recommandé de conserver trois niveaux de contenu. La première couche est le document original pour assurer la traçabilité ultérieure ; la deuxième couche est une transcription fidèle ou un texte OCR, marquant les caractères non confirmés et les zones incertaines ; la troisième couche est constituée de champs standardisés, qui enregistrent les résultats de mappage des unités, termes ou codages standard. Il doit y avoir un ID d'échantillon et un mappage d'emplacement entre les trois couches, et vous ne pouvez pas uniquement conserver les « résultats propres » qui ont été traités par le modèle ou manuellement. Les valeurs originales et les valeurs standardisées sont enregistrées dans des colonnes séparées, et la conversion standardisée conserve les règles et les versions afin que les informations médicales originales et les résultats du traitement technique puissent être distingués.
En particulier, évitez de considérer la confiance OCR comme une précision médicale. La reconnaissance de la mise en page peut mal aligner les colonnes du tableau, la reconnaissance numérique peut manquer de points décimaux, les intervalles de référence peuvent être interchangés avec des indicateurs adjacents et des flèches anormales peuvent également manquer. Le contrôle qualité doit concevoir des contrôles basés sur les types d'erreurs : la reconnaissance des caractères, le positionnement des cellules, l'attribution des champs, les valeurs et unités numériques, les plages de référence, l'identification des exceptions et les conclusions au niveau du rapport sont vérifiées séparément. Pour les échantillons à basse résolution, le comportement correct devrait être de marquer « lecture peu fiable » et de conserver la raison, plutôt que de compléter automatiquement des valeurs apparemment raisonnables. L’exigence d’images de rapport de mauvaise qualité dans la pièce jointe illustre également ce point : les systèmes doivent apprendre à reconnaître les lacunes dans les informations plutôt que de deviner les ambiguïtés.
La qualité médicale doit vérifier la chaîne sémantique au lieu de simplement regarder le taux de complétion des champs
Les champs structurés sont complets, ce qui ne signifie pas que la sémantique clinique de l'échantillon est correcte. La chaîne médicale d'un rapport comprend au moins les résultats d'examen originaux, les unités et les plages de référence, les jugements d'anomalies, les descriptions du médecin et les conclusions et recommandations générales de l'examen. Les audits de qualité doivent poser les questions suivantes : l'identification de l'anomalie correspond-elle à la valeur numérique et à la plage de référence ? Les conclusions sont-elles étayées par le texte du rapport ? Les résultats des images correspondent-ils aux conclusions ? La désensibilisation couvre-t-elle un contenu médical important ? Les âges des patients, les dates ou les éléments de test sont-ils en conflit sur différentes pages du rapport ? Ces problèmes ne peuvent généralement pas être détectés par une simple vérification non nulle.
Pour le rapport d'examen physique complet, il est recommandé d'adopter une approche à deux niveaux « ligne rouge d'admission + sous-score ». La ligne rouge est utilisée pour déterminer les problèmes inacceptables tels que l'autorisation, les fuites de confidentialité, les pages manquantes graves, les images manquantes, les discordances et les erreurs de logique médicale ; après avoir franchi la ligne rouge, le rapport est noté sur des dimensions telles que l'exhaustivité du rapport, la qualité de l'image, la précision du champ, la richesse des éléments, l'explication des anomalies et la comparaison longitudinale. Le taux manquant dans les domaines de base doit être calculé séparément, et les erreurs de logique médicale doivent être comptées séparément et ne doivent pas être diluées par un ensemble de scores moyens. Tous les indicateurs doivent noter le dénominateur, l'unité d'échantillonnage, le traitement des valeurs manquantes et les règles de déduplication des échantillons en double. La norme d'approvisionnement
elle-même est également soumise à un examen de cohérence. Par exemple, si un document d'acceptation adopte des seuils différents pour le « nombre de pages médicales valides » dans différents chapitres, le fournisseur et la partie acceptante peuvent chacun mettre en œuvre des seuils différents. De même, le champ d'application applicable, les exigences en matière de pièces jointes d'images et les niveaux de notation du « rapport d'examen physique », de la « feuille de rapport » et des « informations sur le cas » doivent également être clairement définis. Il est recommandé de mettre en œuvre chaque exigence dans un champ ou un élément d'acceptation unique, et de fournir la définition, la méthode de détection, les conditions de réussite, la partie responsable et le processus de traitement des litiges. Lors de l’étape POC, un lot d’échantillons représentatifs est utilisé pour vérifier les règles. Si des conflits de seuils sont détectés, les normes seront d'abord révisées avant de passer à la livraison par lots.
Le couplage d’images et le traitement de la confidentialité doivent faire partie de la chaîne de livraison
Lorsque le rapport mentionne des examens échographiques, tomodensitométriques, IRM, endoscopie ou autres examens d'imagerie, les fichiers images doivent pouvoir correspondre au même échantillon anonyme, au même examen et à la description textuelle correspondante. L'acceptation n'est pas seulement basée sur « il y a des photos dans le dossier », mais confirme également que l'heure, les modalités, le lieu et les conclusions du rapport d'inspection correspondent ; des images en double, des cartes de lésions erronées et des séquences non pertinentes peuvent entraîner un biais d'apprentissage du modèle. Si la livraison contient du DICOM, l'intégrité de la séquence d'images, les métadonnées clés et le traitement des informations d'identification doivent être vérifiés ; si la livraison est une capture d'écran ou une image de rapport, la résolution, la direction, la lisibilité du texte et la correspondance image-texte doivent être assurées.
La désidentification ne peut pas couvrir uniquement les noms dans le corps du PDF. Les informations personnelles peuvent apparaître dans les en-têtes et pieds de page, les codes QR, les codes-barres, les caractères de gravure d'images, les champs d'en-tête DICOM, les noms de fichiers numérisés, le texte libre des documents ou les répertoires d'exportation. D'un autre côté, la date, l'âge, les paramètres d'examen et les associations longitudinales peuvent être des variables nécessaires à la tâche de recherche et doivent être traités d'une manière fondée sur l'évaluation des risques et la portée de l'autorisation. Les deux parties à la livraison doivent enregistrer l'étendue du traitement, les outils ou règles de traitement, les méthodes d'examen, les résultats du traitement des exceptions et l'attribution des responsabilités ; effectuer des examens par échantillonnage d’images et de documents et conserver des journaux de traitement vérifiables. La norme DICOM fournit un cadre de référence pour la configuration de la désidentification des images, mais la mise en œuvre réelle doit encore être revue en fonction du texte intégré dans l'image, des informations extérieures au fichier et des scénarios d'utilisation spécifiques.[1]
Les sources de données et les supports autorisés doivent être gérés séparément des données de formation, mais peuvent être liés au niveau de gouvernance. L'acceptation du marché ne doit pas uniquement reposer sur la déclaration « désensibilisée » du fournisseur, mais doit également confirmer que la description de la source, la portée de l'autorisation, les restrictions d'utilisation et les conditions de transfert répondent aux exigences du projet ; pour les données dont la source, l’autorisation ou la finalité ne sont pas claires, l’utilisation doit d’abord être gelée et clarifiée. Avant que l'échantillon n'entre dans le pool de données, les enregistrements sources, les versions de traitement et les résumés de contenu doivent également être générés pour éviter de ne pas être en mesure de répondre « d'où viennent ces données, quel traitement elles ont subi et pour quelles tâches elles peuvent être utilisées ».
Utiliser le POC et l'échantillonnage stratifié pour réduire les risques liés aux lots
Avant l'achat groupé, le but du POC n'est pas de montrer le meilleur échantillon sélectionné par le fournisseur, mais de vérifier si l'ensemble du processus de livraison est reproductible. L'échantillonnage doit couvrir les types de rapports, les différents formats, la qualité des images, les résultats normaux ou anormaux, les formulaires complexes, les enregistrements s'étalant sur plusieurs années et les différentes sources d'équipement. La liste d'échantillons doit être déterminée avec la participation du côté de la demande afin d'éviter de voir uniquement des données faciles à traiter et présélectionnées par le fournisseur. L'étape POC vérifie séparément le format, les champs, la correspondance image-texte, la sémantique médicale, la désensibilisation et le mappage des fichiers, génère les défauts élément par élément et corrige la boucle fermée, puis décide s'il faut passer à l'échelle. Une fois que
est entré dans l'acceptation par lots, en plus du taux de réussite global, il convient également de prêter attention aux performances des sous-groupes clés. La précision globale peut masquer des défauts évidents dans un certain type de rapport, un certain appareil, un certain format ou un échantillon basse définition. L'échantillonnage stratifié peut être effectué par catégorie de rapport, qualité d'image, complexité du champ et catégorie de source, en signalant les taux d'erreur et les intervalles de confiance pour chaque strate. Adopter des règles de retour de dossiers complets ou de suspension par lots pour les questions de veto à une voix ; définir des ratios d'examen, des délais de reprise et des normes de réinspection pour les problèmes réparables. La version originale, la version modifiée et les résultats des nouveaux tests doivent être conservés pour chaque révision afin d'éviter que des problèmes ne se reproduisent dans différents lots.
D'un point de vue algorithmique, la segmentation des échantillons appartient également à la conception de l'acceptation des achats. Si plusieurs rapports de la même personne sont dispersés dans l'ensemble de formation et l'ensemble de test, le modèle peut « se souvenir de la réponse » grâce à un contenu répété ou à des caractéristiques personnelles, ce qui entraîne des résultats de validation plus élevés. Pour les tâches longitudinales, l'ensemble de données doit être segmenté par patient et la segmentation temporelle doit être claire ; pour la reconnaissance de la mise en page, l'écart de distribution provoqué par le même modèle dans les collections doit également être pris en compte. L’ensemble de tests devrait idéalement conserver des exemples difficiles, des échantillons de mauvaise qualité et de véritables cas manquants, et les étiquettes de test devraient être gérées par un processus indépendant. Grâce au lien entre l'approvisionnement, la gouvernance et l'évaluation du modèle, il peut être déterminé que l'amélioration du modèle provient d'une véritable généralisation plutôt que d'une duplication de données ou d'une fuite de tests.
Les indicateurs de qualité doivent être cartographiés pour modéliser les risques
Différentes erreurs ont des effets différents sur le modèle. L'identification égarée des sous-titres, la lecture incorrecte des valeurs de test anormales et la fusion des rapports de différents patients ne peuvent pas être enregistrées comme une erreur de champ courante. Il est recommandé que les défauts soient classés en fonction de leur gravité : les erreurs qui modifieront la signification clinique ou l'attribution au patient sont définies comme défauts critiques ; les erreurs qui affectent le jugement du modèle mais peuvent toujours être trouvées dans le processus manuel sont définies comme des défauts majeurs ; les problèmes de format qui ne modifient pas la sémantique de base sont considérés comme des défauts généraux. Chaque niveau doit expliquer comment compter, comment réviser et quelles actions correctives ou de rejet sont déclenchées. Le rapport de réception doit présenter une répartition des défauts, et pas seulement un taux de réussite global.
Il est également nécessaire de faire la distinction entre le « taux de précision au niveau du champ » et le « taux de réussite au niveau de l'échantillon ». Une tâche d'extraction de champ peut signaler la précision, le rappel, F1, la plage de tolérance de différence numérique et la précision de positionnement sur le terrain ; la qualification d'un rapport dépend également des champs obligatoires, de son exhaustivité, des dossiers associés et de sa cohérence médicale. Si l'on fait simplement une moyenne de millions de champs, quelques erreurs graves peuvent être diluées par un grand nombre de champs faciles. Une meilleure pratique consiste à déclarer simultanément les micro-moyennes, les macro-moyennes, les indicateurs de terrain clés et les proportions de réussite au niveau de l'échantillon, stratifiés par catégorie de déclaration et difficulté. La méthode d'échantillonnage et l'incertitude estimée doivent également être indiquées pour les résultats d'échantillonnage afin d'éviter de promouvoir les scores élevés accidentels d'un petit échantillon comme une assurance qualité complète.
La distribution des données elle-même nécessite également un contrôle qualité. Les proportions de sexe, de groupe d'âge, de département, de type d'examen, de statut anormal, d'établissement et de format de rapport peuvent être pertinentes par rapport aux objectifs du modèle. L'enrichissement afin de mettre en évidence des exemples difficiles lors de la collecte de données peut améliorer l'efficacité de la formation, mais modifie la structure globale de l'échantillon ; si la même méthode d'enrichissement est utilisée pour l'ensemble d'évaluation, les résultats ne peuvent pas représenter des scénarios d'utilisation généraux. Il est recommandé de maintenir à la fois un « ensemble de défis pour les tests d'aptitude » et un « ensemble d'évaluations représentatives proches du scénario d'utilisation cible » et de clarifier la méthode de sélection des deux. Pour les catégories rares, la taille réelle de l’échantillon et l’intervalle de confiance doivent être indiqués afin d’éviter de tirer des conclusions déterministes basées sur un petit nombre d’échantillons.
Boucler la boucle sur les défauts de données dans le processus de fourniture et d'annotation
Le résultat de l’acceptation ne peut pas s’arrêter uniquement à la déduction ou au dossier de retour de l’acheteur. Chaque défaut doit être retracé jusqu'à son origine : si le filtrage de la source ne répond pas à la définition, si l'acquisition par balayage provoque une distorsion de l'image, si l'OCR provoque des relations erronées entre les colonnes, si les règles de désidentification obscurcissent les valeurs médicales, si l'examen manuel est manqué, si la transformation de la livraison détruit des champs ou des chemins. Après avoir associé la cause du défaut au lot, à la version de traitement et au lien responsable, l'équipe de projet peut déterminer s'il convient de modifier les spécifications de collecte, les règles de traitement, la formation à l'étiquetage ou le processus de conditionnement des fichiers.
Il est recommandé que chaque lot de livraison dispose d'un manifeste lisible par machine enregistrant la valeur de hachage ou de somme de contrôle du fichier, l'échantillon de clé anonyme, le type de fichier, l'heure de génération, la version de traitement, l'événement de vérification de corrélation et l'état de révision. Pour les révisions, le fichier original ne doit pas être directement écrasé, mais la relation entre l'ancienne et la nouvelle version ainsi que les raisons de la modification doivent être enregistrées. Lorsque les exigences changent, le numéro de version standard, la date d'entrée en vigueur et les lots concernés sont conservés pour éviter d'utiliser un ensemble de règles implicites pour différents lots du même projet. Pour une coopération à long terme, le rachat ne signifie pas simplement copier le format du lot précédent, mais mettre à jour continuellement les définitions de champs et la couverture des cas difficiles en utilisant la liste de problèmes comme entrée.
L'idée de livraison de Langhui devrait commencer par des règles vérifiables
Le professionnalisme de l'acquisition de données médicales ne dépend pas de la durée de rédaction du document d'exigences, mais de la possibilité de convertir les objectifs en définitions d'échantillons exécutables, spécifications de terrain, indicateurs de qualité, processus POC et preuves d'acceptation de lots. L'expression externe des projets de données médicales de Langhui peut spécifiquement tomber dans les étapes de démontage des exigences, de conception de la structure des données, de contrôle de la qualité médicale, d'examen de désidentification et d'acceptation en boucle fermée ; chaque projet détermine ensuite l'étendue réelle de la livraison en fonction de son autorisation, de ses échantillons, de ses tâches et de ses règles d'acceptation. Une telle déclaration peut non seulement refléter les capacités d'ingénierie, mais également empêcher que le seuil d'un certain projet d'approvisionnement ne soit rédigé par erreur comme un engagement universel pour tous les clients.
Une solution d'approvisionnement mature permettra à terme aux ingénieurs en algorithmes d'obtenir des fichiers et des champs directement lisibles, aux experts médicaux d'examiner le contexte et la logique clinique, et au personnel d'approvisionnement et de conformité de retracer les sources, les autorisations et les conclusions d'acceptation. Le nombre de rapports n’est qu’un début ; la relation entre les rapports, entre les rapports et les images, et entre les champs et le texte original détermine s'il s'agit d'un actif de données fiable. FAQ
Questions fréquentes
Suffit-il uniquement d’examiner la précision sur le terrain pour accepter les données de formation de l’IA médicale ? Cela ne suffit pas. Des éléments tels que la définition des échantillons, l'autorisation de la source, l'exhaustivité de la documentation, la qualité de l'image, la correspondance image-texte, la sémantique médicale, la désidentification, le taux de duplication et la segmentation au niveau du patient doivent également être vérifiés, et des règles distinctes doivent être établies pour les défauts à haut risque.
Comment l'OCR des rapports médicaux doit-elle gérer les zones floues ? Marquez le contenu qui ne peut pas être identifié de manière fiable comme incertain, conservez l'emplacement et la confiance de l'image d'origine, et passez au processus de révision ou d'élimination manuelle. Ne devinez pas les valeurs de contrôle, les indicateurs d’exception et les conclusions de diagnostic basées uniquement sur le contexte. Comment sélectionner les échantillons POC
Comment sélectionner des échantillons POC représentatifs ? Couvrez les mises en page courantes et rares, les différents types de rapports, les définitions anormales et normales, claires et basses, les tableaux complexes et les corrélations d'images en fonction des tâches attendues, et conservez des échantillons aléatoires pour éviter d'utiliser uniquement des échantillons sélectionnés faciles à transmettre.
Références
[1] DICOM PS3.15 2025e, Profils de sécurité et de gestion du système, Annexe E : Profils de confidentialité des attributs.https://dicom.nema.org/medical/dicom/2025e/output/html/part15.html
[2] Mongan J, et al. Liste de contrôle pour l'intelligence artificielle en imagerie médicale (CLAIM) : mise à jour 2024. Radiologie : Intelligence Artificielle. https://pmc.ncbi.nlm.nih.gov/articles/PMC11304031/
[3] Groupe de pilotage STARD-AI. La ligne directrice de reporting STARD-AI pour les études d’exactitude des diagnostics utilisant l’intelligence artificielle. Médecine naturelle, 2025. https://doi.org/10.1038/s41591-025-03953-8