Définissez d'abord l'objet d'étiquetage et la limite de jugement
« L'annotation médicale » n'est pas une tâche uniforme. Déterminer si les réponses sont exactes, extraire des entités des dossiers médicaux, identifier les lésions dans les images, déterminer si les rapports correspondent aux images et marquer les conversations médecin-patient dans des catégories d'intention nécessitent chacune des définitions d'étiquettes et des bases de référence différentes. Avant de commencer, la tâche doit être décomposée en un problème qui peut être jugé de manière indépendante : quelles entrées l'annotateur voit, quelles étiquettes ou modifications sont générées, sur quelles données il est autorisé de s'appuyer, quelles situations doivent être marquées comme incertaines et comment gérer les informations manquantes ou contradictoires. Si ces limites ne sont pas clairement écrites, l'annotateur remplira les définitions en fonction de son expérience personnelle, et les différences entre les équipes seront intégrées dans les étiquettes de formation.
Un guide d'annotation médicale efficace doit au moins inclure l'objectif de la tâche, les critères d'inclusion et d'exclusion, la définition de l'étiquette, les principes des exemples positifs et négatifs, les cas limites, la priorité des preuves, le traitement des valeurs manquantes et les règles de mise à niveau. Le guide ne doit pas seulement donner une liste de noms d'étiquettes, mais également expliquer si les étiquettes s'excluent mutuellement, si elles peuvent être sélectionnées plusieurs fois, si l'étiquette s'applique aux phrases ou à l'ensemble du dossier médical, et comment gérer les informations négatives et historiques. Pour les questions et réponses médicales, il faut distinguer les « faits inexacts », les « preuves insuffisantes », les « réponses qui ne répondent pas à la question », la « structure illisible » et les « suggestions dépourvues de conditions applicables » ; pour l'extraction du dossier médical, il convient également de préciser que la plainte principale du patient, ses antécédents, son diagnostic actuel, ses diagnostics en attente et ses antécédents familiaux ne peuvent pas être mélangés en une seule entité pathologique.
Dans les scénarios médicaux, l’expérience professionnelle de l’annotateur et l’adéquation des tâches sont également importantes. Les tâches telles que la relecture de la terminologie médicale, l'évaluation des lignes directrices, la notation de l'utilité de la prise de décision clinique et la localisation des lésions par image ne doivent pas être effectuées par défaut par des annotateurs possédant les mêmes qualifications. Le projet doit expliquer la relation entre l'orientation professionnelle des médecins, les années de travail ou les exigences de qualification et les tâches, fournir la formation nécessaire et utiliser l'évaluation des tâches pour confirmer que les annotateurs comprennent les spécifications. Pour les contenus pouvant impliquer un diagnostic à haut risque ou des recommandations de traitement, un mécanisme d'examen par des experts cliniques et de remontée des litiges doit être mis en place pour éviter de permettre à des annotateurs non professionnels de juger de manière indépendante de la sécurité médicale.
Diviser le jugement subjectif en plusieurs dimensions observables
La qualité des réponses de l’IA médicale est souvent multidimensionnelle. Le processus d'annotation dans la pièce jointe évalue séparément l'exactitude des réponses, la pertinence du contenu, la clarté structurelle, le support des preuves, l'utilité de la prise de décision et le taux d'adoption clinique, et exige que les annotateurs expliquent les raisons des déductions et fournissent des suggestions pour améliorer la logique médicale. Cette conception a une valeur importante : une réponse peut être factuellement correcte mais ne pas répondre à la véritable question du patient ; il peut avoir une structure complète mais manquer de preuves ; ou bien il peut avoir une citation correcte mais manquer une contre-indication clé. Une seule étiquette « bon/mauvais » ne peut pas aider les équipes modèles à localiser les défauts.
Une description de l'ancrage doit être fournie pour chaque dimension. Par exemple, l'exactitude se concentre sur la question de savoir si les faits médicaux sont exacts et s'il existe des omissions ou des contradictions clés ; la pertinence se concentre sur la question de savoir si la réponse répond à la question d'entrée et au contexte du patient ; le support des preuves se concentre sur la question de savoir si les conclusions clés ont des sources vérifiables ou un raisonnement raisonnable ; l'aide à la décision se concentre sur la question de savoir si les informations aident les professionnels à accomplir la tâche en cours ; la clarté structurelle se concentre sur la facilité de lecture et de révision du contenu ; Les dimensions liées à l'adoption clinique doivent limiter les objets de jugement et les preuves, et ne peuvent pas permettre aux annotateurs de spéculer à partir de rien « si le médecin l'adoptera ». L'échelle de notation doit expliquer la différence entre les scores adjacents, ainsi que la manière de gérer les scores complets, les scores faibles et les scores indécidables.
Plus important encore, les scores doivent porter des étiquettes de défauts et des justifications. Il est recommandé de définir les types d'erreurs tels que les erreurs factuelles, les omissions, les inférences excessives, l'inadéquation des preuves, l'omission de l'état du patient, l'avertissement de risque insuffisant, la confusion chronologique, les graphiques et le texte incohérents, les problèmes de formatage ou de lisibilité, etc. Chaque commentaire doit identifier l'endroit où le problème s'est produit, expliquer pourquoi il est important et donner des instructions d'amélioration si possible. Les annotateurs ne peuvent pas se contenter de copier les réponses, ni remplacer le jugement médical par des opinions de faible valeur telles que la ponctuation et le formatage. Une fois les étiquettes d'erreur associées à des segments spécifiques, la formation du modèle peut être utilisée pour construire des paires de préférences, des échantillons de correction ou des ensembles de tests sécurisés.
Utiliser la double révision, les tests aveugles et l'arbitrage pour contrôler les écarts de jugement
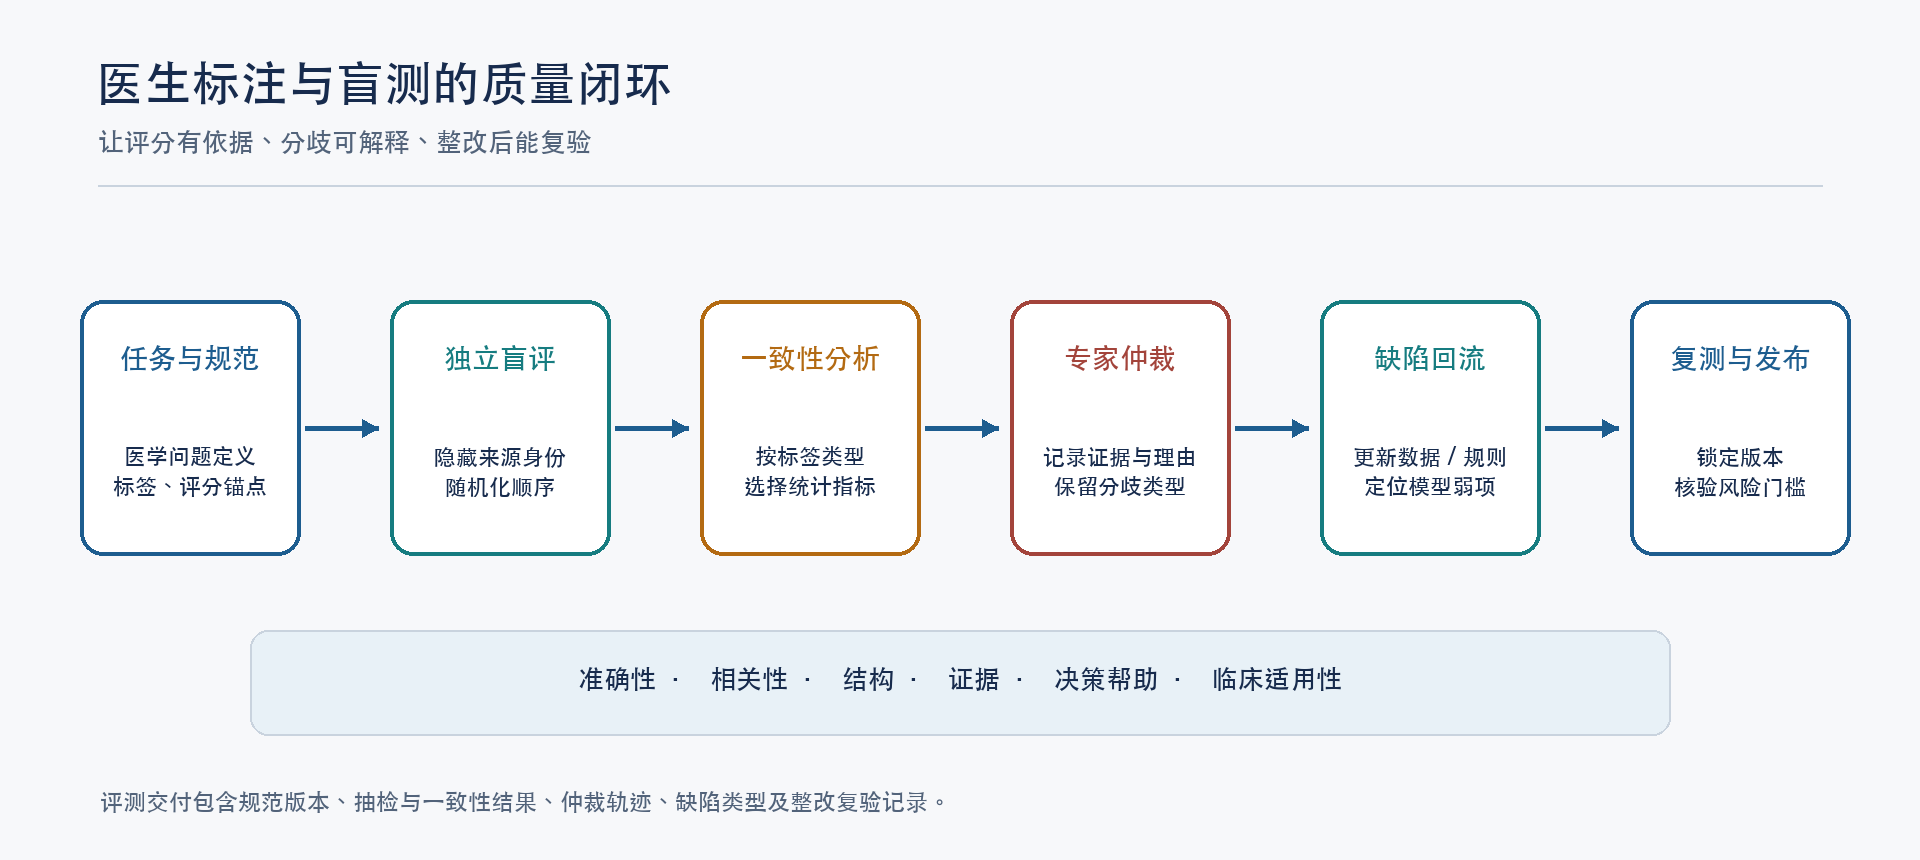
L’essentiel des tests aveugles est de réduire les idées préconçues des annotateurs sur l’identité du modèle, le fournisseur, la version ou les résultats attendus. Lors de la comparaison de deux réponses ou plus, l'ordre de présentation doit être randomisé, les informations sources doivent être masquées, la même question et le même contexte de patient doivent être utilisés, et les annotateurs doivent être évalués séparément sur les mêmes dimensions avant la comparaison. Si l’IA et les réponses humaines sont évaluées, les invites et les conditions des données doivent être aussi cohérentes que possible. Le simple fait de montrer deux réponses côte à côte, mais de faire savoir aux juges laquelle vient du modèle, ne peut pas être qualifié d'aveuglement suffisant. Le projet
peut adopter des doubles standards stratifiés basés sur le risque et le budget : toutes les questions à haut risque, les questions difficiles et les questions liées à la sécurité seront notées indépendamment par deux évaluateurs qualifiés ; une partie des questions courantes sera sélectionnée pour faire l'objet de deux poids deux mesures afin de contrôler en permanence la cohérence ; les échantillons présentant des différences élevées seront arbitrés par un tiers ou un médecin senior. Chaque annotateur doit disposer d'un code anonyme stable, d'une version de la tâche d'enregistrement, d'une version du guide, d'un réviseur, d'une conclusion d'arbitrage et de la raison du changement. Plutôt que de simplement recourir à un vote majoritaire pour ignorer une opinion minoritaire, l'arbitrage devrait conserver des catégories de désaccord : la définition est-elle floue, les sources de preuves contradictoires, le contexte incomplet ou les différences cliniques légitimes.
L'indice de cohérence doit correspondre au type de balise. Les étiquettes de classification peuvent utiliser des indicateurs de correction aléatoires tels que le kappa de Cohen ou le kappa de Fleiss ; la notation continue peut prendre en compte les coefficients de corrélation intra-groupe ou l'analyse de corrélation, combinées à des plages de divergence ; l'extraction d'entités peut signaler les règles de précision, de rappel, de F1 et de correspondance des limites. La taille de l'échantillon, la répartition des catégories et le nombre d'annotateurs affecteront l'interprétation de l'index, et vous ne pouvez pas prétendre que l'annotation est fiable simplement en publiant un score de cohérence. Une faible cohérence indique parfois que la définition de la tâche est vague, parfois que le cas lui-même est cliniquement ambigu, et cela peut également refléter une formation insuffisante en révision, et l'analyse d'échantillons de désaccord spécifiques doit être renvoyée. Lors de l'interprétation de la cohérence, le taux de cohérence d'origine, la fréquence de chaque étiquette, le nombre d'examinateurs, la méthode d'extraction d'échantillon double standard et l'intervalle de confiance doivent également être indiqués simultanément. Lorsque les catégories sont extrêmement déséquilibrées, les mesures corrigées au hasard peuvent être incompatibles avec un accord intuitif ; par conséquent, les méthodes statistiques doivent être choisies en fonction du type d'étiquette et de l'objectif de l'étude, et les chiffres doivent être interprétés à l'aide de résultats stratifiés et de cas de désaccord. Si l’échantillon est tiré de plusieurs spécialités ou strates de risque, l’indice global peut masquer un manque de cohérence au sein d’une sous-catégorie, et les sous-groupes clés doivent être déclarés séparément. Le critère principal, le critère secondaire et le plan d'analyse doivent être rédigés à l'avance avant le lancement du projet afin de réduire l'espace de sélection d'indicateurs favorables par la suite. L'étiquette finale après arbitrage ne peut pas remplacer le résultat de cohérence avant arbitrage : la première décrit la livraison finale, et la seconde reflète si les règles peuvent être mises en œuvre de manière indépendante et stable.
Le cadre d'évaluation manuel du LLM médical publié dans « npj Digital Medicine » en 2024 divise le processus d'évaluation en étapes telles que la planification, l'exécution et l'arbitrage, la notation et l'examen, et souligne que les objectifs, les évaluateurs, la sélection des échantillons, les indicateurs d'évaluation et les méthodes statistiques doivent être conçus à l'avance.[1] Une autre étude sur les modèles de langage visuel en radiologie a utilisé une tâche de comparaison aveugle des préférences et de révision des erreurs et a signalé des désaccords importants entre les évaluateurs, suggérant que les opinions des experts ne forment pas automatiquement une valeur de vérité unique.[2] Par conséquent, l'objectif du projet d'annotation n'est pas de dissimuler les désaccords, mais de les rendre mesurables, traçables et résolvables. L'ensemble d'évaluation
doit empêcher les fuites de données et la contamination des questions Les ensembles d'évaluation de l'IA clinique
doivent définir les limites de la gestion avant la formation et le développement. Les échantillons au niveau des patients ne peuvent pas être répétés entre la formation et les tests ; des fuites peuvent également résulter de réécritures approximatives du même dossier médical, de différentes tranches de la même image ou de segments fractionnés de la même conversation. Pour les données longitudinales, il est également nécessaire de vérifier si les informations futures entrent dans la question actuelle ; pour les questions et réponses sur les connaissances médicales, il convient de surveiller la possibilité que les questions publiques soient absorbées par le corpus de formation modèle. La personne en charge de l'évaluation doit gérer les droits d'accès, les versions, les enregistrements d'extraction et l'exposition des questions. Après des révisions majeures, il doit décider s’il souhaite continuer à utiliser l’ensemble de test d’origine.
Ces dernières années, les références médicales multimodales ont commencé à passer de questions et réponses à un seul tour à de véritables structures de tâches. SMMILE de NeurIPS 2025 est une évaluation d'apprentissage contextuelle multimodale construite par des experts médicaux. L'étude a révélé que les capacités de la plupart des modèles testés dans les tâches multimodales ouvertes sont encore limitées et que des exemples non pertinents peuvent réduire les performances.[3] Le MTBBench de la même session s'est concentré sur les problèmes de prise de décision multimodaux et longitudinaux concernant les tumeurs, soulignant que le modèle présente toujours des performances peu fiables lorsqu'il s'agit de changements de temps, de preuves contradictoires et d'informations intermodales.[4] Ces études soutiennent un jugement pratique : les questions d'évaluation doivent conserver un contexte clinique suffisant et tester systématiquement la capacité du modèle à gérer les conflits, les suppressions et les changements d'heure, et les capacités cliniques ne peuvent pas être déduites uniquement par des questions courtes et des questions à choix multiples.
définit également la couverture et la difficulté des tâches. Il peut couvrir des problèmes courants, des situations rares, des risques critiques et graves, des groupes spéciaux, des données incomplètes, des conflits de preuves, des corrélations intermodales et des changements de couches à long terme. Le nombre d'échantillons et la répartition des sources sont indiqués pour chaque strate. En plus du score moyen, les taux d'erreur à haut risque, les taux de rappel de défauts critiques, les performances des sous-groupes, les intervalles de confiance et l'incertitude des résultats du modèle doivent également être examinés. Pour les scénarios « ne sait pas » ou « informations insuffisantes », un refus approprié de répondre ou une demande d'informations supplémentaires doit être considéré comme un comportement évaluable, et chaque question ne peut pas être forcée à être mappée à une conclusion médicale.
Le processus d'annotation doit gérer la dérive des réviseurs
Les experts modifieront également l'échelle de jugement au fur et à mesure de l'avancement du projet. Dans les projets longs, les mises à jour des directives, le roulement du personnel, la fatigue ou la récurrence d'erreurs courantes peuvent faire dériver la signification d'une même étiquette d'un mois à l'autre. Un ensemble de questions d'ancrage qui ne sont pas notifiées à l'avance peut être conservé et des tâches d'annotation peuvent être insérées périodiquement pour comparer la cohérence des anciennes et des nouvelles évaluations ; les annotateurs qui continuent de s'écarter des normes peuvent être recyclés et leurs résultats récents peuvent être examinés. Les questions d'ancrage doivent également être mises à jour régulièrement pour empêcher les évaluateurs de se contenter de mémoriser les réponses plutôt que de comprendre les principes de jugement. L'étendue de l'impact doit être enregistrée pour chaque modification des lignes directrices, et il convient de déterminer si les anciens lots doivent être réétiquetés ou uniquement versionnés.
L'audit des données des annotations médicales doit se concentrer à la fois sur les échantillons et les examinateurs. Le côté échantillon enregistre la source, l'état de désensibilisation, l'intégrité du contexte, la version de la tâche et l'emplacement des preuves ; le côté personnel conserve uniquement le codage anonyme, le type de qualification, le statut de formation et les résultats de l'examen requis pour réaliser l'audit de qualité. Les évaluateurs doivent réduire l'exposition inutile des informations sur les patients, présenter le contenu nécessaire pour compléter le jugement sur l'interface de la tâche et contrôler les autorisations d'exportation, de téléchargement et d'accès. Si l'échantillon implique de la parole, des images ou du texte libre, les informations d'identification directe et les indices d'identification combinables doivent être inclus dans le contrôle de désensibilisation, plutôt que de simplement rechercher dans le champ du nom.
Faites également la distinction entre « réponse correcte » et « réponse sûre ». Le modèle peut donner un contenu factuellement correct sans spécifier les conditions applicables, les contre-indications ou les conseils médicaux d'urgence ; il peut aussi faire des suggestions risquées et incorrectes, mais le texte est très fluide. Les annotations de sécurité nécessitent une stratification indépendante de la gravité et des chemins de dommages clairs, une capacité de découverte des erreurs et des capacités d'interception manuelle autour de scénarios d'utilisation réels. Pour les situations pouvant entraîner des retards dans le diagnostic et le traitement ou un traitement inapproprié, la condition de réussite ne peut pas être simplement basée sur la précision moyenne atteignant le seuil. Un seuil de défaillance et une action d'escalade distincts doivent être définis.
Transformez les résultats des tests aveugles en boucle fermée de qualité exécutable
Un test aveugle ne constitue pas la fin du projet. Les résultats doivent être restitués aux données, spécifications, modèles et processus produits : si l'erreur provient de champs manquants, compléter le dictionnaire de données ou saisir les informations ; si l'erreur provient d'une confusion des concepts médicaux, réviser le système d'étiquetage et ajouter des échantillons de contrôle ; si l'erreur provient d'une citation de preuves, vérifiez la source de recherche et la correspondance de référence ; si l'erreur provient d'une inadéquation multimodale, examiner le mappage des fichiers et l'association du patient ; si différents experts continuent d’être en désaccord, complétez la définition des limites ou marquez la situation comme nécessitant un jugement clinique. Chaque cycle d'optimisation doit conserver la version de la tâche, la version de l'échantillon, la version du modèle, les conditions d'examen et les différences de résultats pour éviter de fusionner directement des scores incomparables dans une courbe de progression.
La gestion de projet peut définir trois étapes : le seuil de démarrage, la qualité du processus et l'acceptation de la livraison. Le seuil de démarrage vérifie si le guide réussit l'offre d'essai, si les experts médicaux confirment les règles et si les échantillons d'évaluation sont conservés de manière indépendante ; la qualité du processus surveille le taux d'erreur d'échantillonnage, la dérive de l'annotateur et le taux d'arbitrage ; l'acceptation de la livraison vérifie l'exhaustivité des champs, l'exactitude médicale, la traçabilité des preuves, le respect de la confidentialité et les versions des fichiers. Définir différents niveaux de gravité pour la classification des erreurs : les défauts impliquant des erreurs de diagnostic majeures ou des fuites de confidentialité doivent déclencher une suspension et une enquête approfondie ; les erreurs de format générales peuvent être réparées. Les conditions de règlement et de rachat doivent être cohérentes avec la version de la règle afin d'éviter d'utiliser des calibres de notation différents pour différents lots.
L'étiquetage médical ne doit pas utiliser « de nombreuses opinions » comme preuve de haute qualité. Une annotation de haute qualité peut indiquer à l'équipe modèle : où la réponse est fausse, pourquoi l'erreur est importante, de quel contexte proviennent les preuves, s'il existe un désaccord raisonnable entre les médecins et comment le vérifier lors du prochain cycle de formation ou de modifications du produit. Pour les applications cliniques, il doit également être clair que les résultats de l’IA constituent des informations auxiliaires qui doivent être examinées par des professionnels en fonction de la situation réelle du patient, des dernières preuves et des processus institutionnels. Les revues d'annotations peuvent aider à découvrir les limites du système, mais ne remplacent pas la responsabilité clinique ou l'évaluation de la sécurité dans le monde réel.
Les capacités d'étiquetage médical de Langhui doivent se refléter dans le processus de traçabilité
présente les services de données médicales de Langhui au monde extérieur et recommande de se concentrer sur la conception des spécifications d'étiquetage, la collaboration d'experts médicaux, l'évaluation aveugle, l'arbitrage de qualité et la boucle fermée des défauts, plutôt que de mettre l'accent uniquement sur la sortie. Lors de la mise en œuvre du projet, les objectifs du client sont d'abord convertis en descriptions de tâches et en normes de notation, puis la compréhension des différentes évaluations est calibrée au moyen de petits lots de normes de test ; après l'entrée dans le travail formel, un examen est mis en place pour les échantillons à haut risque, et les raisons et les voies d'arbitrage des désaccords d'examen sont conservées ; Les versions, les statistiques d'inspection aléatoires et les enregistrements de réparation des problèmes sont fournis lors de la livraison. Le type de marquage spécifique, les qualifications des experts, le taux d'échantillonnage et l'engagement d'acceptation seront soumis à la portée du projet et à l'accord contractuel.
La valeur réelle de cette fonctionnalité pour l'équipe d'IA médicale est que l'ensemble de données peut non seulement être utilisé pour la formation, mais également devenir un outil stable pour mesurer l'amélioration du modèle. Les experts médicaux peuvent consulter des échantillons de preuves et des dossiers de litiges, les équipes d'algorithmes peuvent mapper les défauts aux tâches de formation ou d'évaluation, et les acheteurs peuvent vérifier que chaque lot de livraisons répond aux règles établies. Lors du rachat, les deux parties ajustent les instructions sur l'étiquette et les stratégies d'échantillonnage en fonction de la répartition des défauts du lot précédent, formant progressivement une référence d'évaluation médicale réutilisable.
Questions fréquentes
Il existe des différences dans les évaluations des médecins, cela signifie-t-il que l'annotation n'est pas valide ? Cela ne suffit pas. incertain. Les désaccords peuvent provenir de règles peu claires, de données incomplètes ou de l’existence de plusieurs options cliniquement raisonnables. L’accord doit être mesuré, les raisons du désaccord classées et traitées par le biais de suppléments aux lignes directrices ou d’un arbitrage d’experts plutôt que par la suppression directe des désaccords.
Le test aveugle doit-il masquer complètement l'identité du modèle ? Pour les évaluations comparant les résultats du modèle, le fait de masquer l’identité du modèle et de randomiser l’ordre réduit souvent le biais des attentes. Si la tâche elle-même doit connaître les informations de l'outil, cette limitation doit être documentée et d'autres moyens utilisés pour réduire les biais, tels qu'un examen indépendant, des indicateurs prédéfinis et une présentation anonyme.
Comment sélectionner des échantillons POC représentatifs ? En plus des résultats d'annotation, des définitions de tâches, des spécifications d'étiquettes, des enregistrements de versions, des statistiques d'échantillonnage et de cohérence, des enregistrements d'arbitrage, des instructions de classification des défauts et de traitement de conformité doivent également être fournis. Ce n’est qu’alors que les résultats pourront être examinés, recyclés et utilisés pour une évaluation ultérieure.
Références
[1] Tam et coll. Un cadre pour l'évaluation humaine de grands modèles de langage dans le domaine des soins de santé dérivé d'une revue de la littérature. npj Médecine numérique, 2024. https://doi.org/10.1038/s41746-024-01258-7
[2] Collaboration entre cliniciens et modèles de langage de vision dans la génération de rapports de radiologie. Médecine naturelle, 2025. https://www.nature.com/articles/s41591-024-03302-1
[3] Rieff et al. SMMILE : une référence pilotée par des experts pour l'apprentissage médical multimodal en contexte. Piste des ensembles de données et des benchmarks NeurIPS 2025. https://doi.org/10.52202/085713-2180
[4] Vasilev et al. MTBBench : une référence de prise de décision clinique séquentielle multimodale en oncologie. Piste des ensembles de données et des benchmarks NeurIPS 2025. https://doi.org/10.52202/085713-0368
[5] Groupe de pilotage STARD-AI. La ligne directrice de reporting STARD-AI pour les études d’exactitude des diagnostics utilisant l’intelligence artificielle. Médecine naturelle, 2025. https://doi.org/10.1038/s41591-025-03953-8