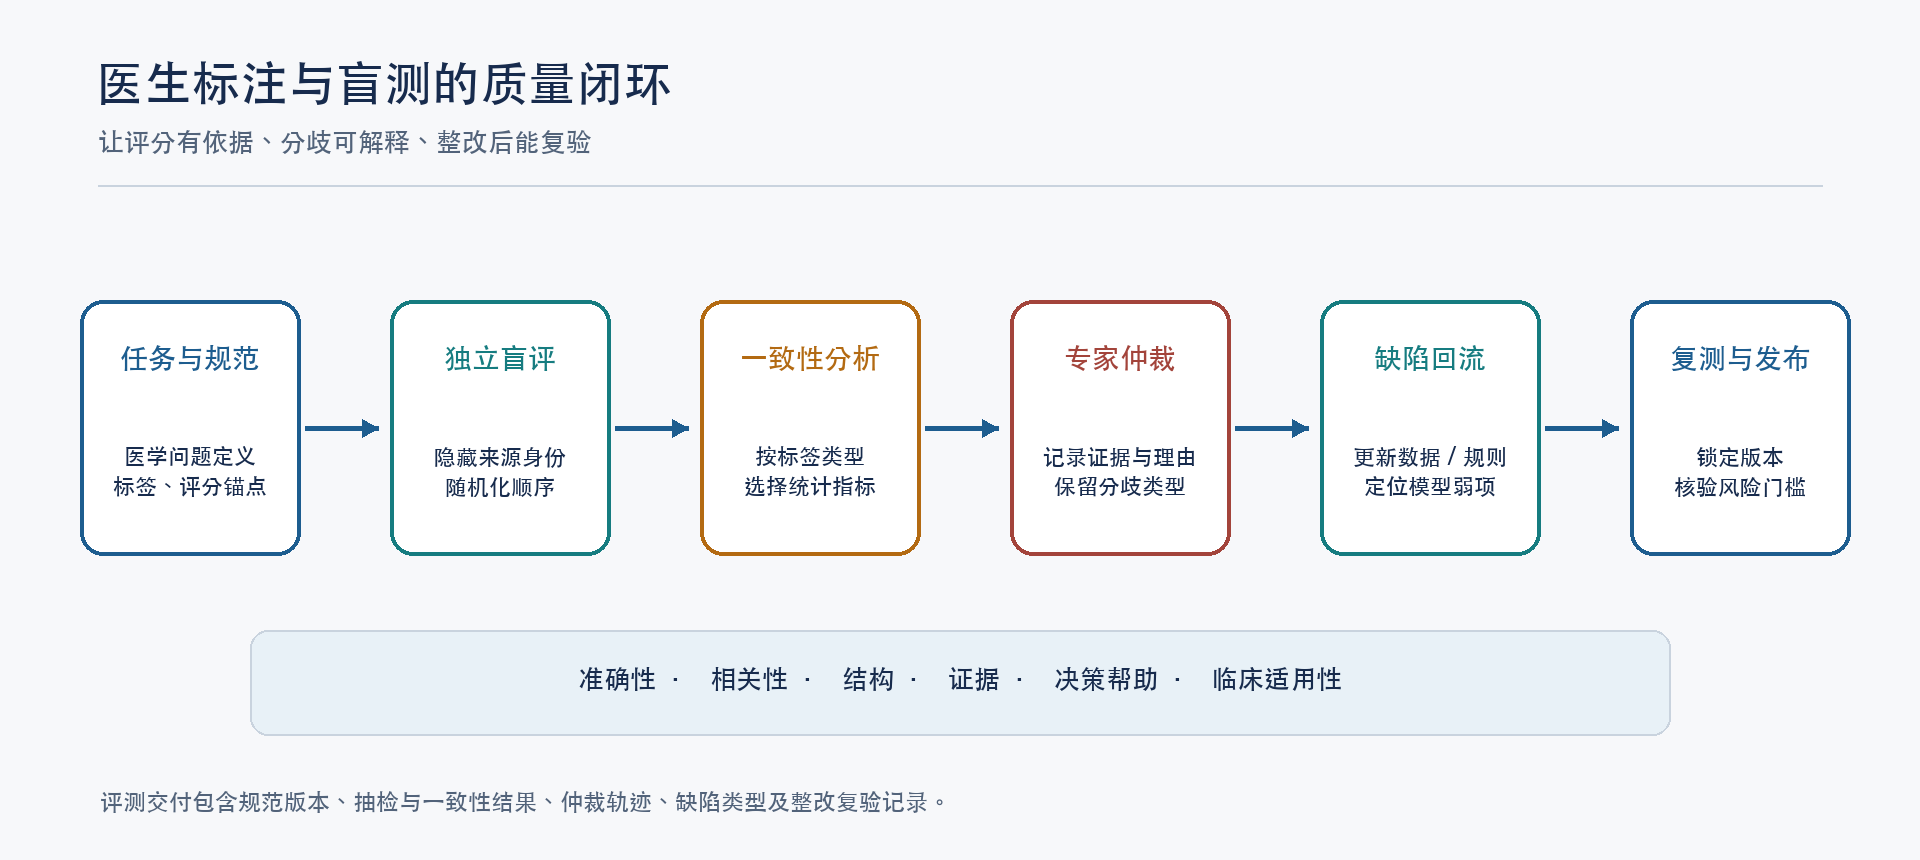
Primero defina el objeto de etiquetado y el límite de juicio
La “anotación médica” no es una tarea uniforme. Determinar si las respuestas son precisas, extraer entidades de los registros médicos, identificar lesiones en imágenes, determinar si los informes coinciden con las imágenes y marcar las conversaciones médico-paciente en categorías de intención requieren diferentes definiciones de etiquetas y bases de referencia. Antes de comenzar, la tarea debe dividirse en un problema que pueda juzgarse de forma independiente: qué entradas ve el anotador, qué etiquetas o modificaciones se generan, en qué datos se puede confiar, qué situaciones se deben marcar como inciertas y cómo lidiar con la información faltante o contradictoria. Si estos límites no están claramente escritos, el anotador completará las definiciones basándose en su experiencia personal y las diferencias entre equipos se mezclarán en las etiquetas de entrenamiento.
Una guía de anotación médica eficaz debe incluir al menos el propósito de la tarea, los criterios de inclusión y exclusión, la definición de la etiqueta, los principios de ejemplos positivos y negativos, los casos límite, la prioridad de las pruebas, el procesamiento de valores faltantes y las reglas de actualización. La guía no solo debe brindar una lista de nombres de etiquetas, sino también explicar si las etiquetas son mutuamente excluyentes, si se pueden seleccionar múltiples veces, si la etiqueta se aplica a oraciones o a todo el historial médico, y cómo manejar la información histórica y negativa. En el caso de las preguntas y respuestas médicas, se deben distinguir "hechos inexactos", "evidencias insuficientes", "respuestas que no abordan la pregunta", "estructura ilegible" y "sugerencias que carecen de condiciones aplicables"; Para la extracción de registros médicos, también se debe indicar que la queja principal del paciente, los antecedentes, el diagnóstico actual, los diagnósticos pendientes y los antecedentes familiares no se pueden mezclar en una sola entidad patológica.
En escenarios médicos, la experiencia profesional del anotador y la correspondencia de tareas también son importantes. De forma predeterminada, tareas como la revisión de la terminología médica, la evaluación de la evidencia de las guías, la puntuación de la utilidad para la toma de decisiones clínicas y la localización de lesiones por imágenes no deben ser completadas por anotadores con las mismas calificaciones. El proyecto debe explicar la relación entre la dirección profesional de los médicos, los años de trabajo o los requisitos y tareas de calificación, proporcionar la capacitación necesaria y utilizar la evaluación de tareas para confirmar que los anotadores comprenden las especificaciones. Para el contenido que pueda implicar diagnósticos de alto riesgo o recomendaciones de tratamiento, se debe establecer una revisión de expertos clínicos y un mecanismo de escalada de disputas para evitar permitir que anotadores no profesionales juzguen de forma independiente la seguridad médica.
Dividir el juicio subjetivo en múltiples dimensiones observables
La calidad de las respuestas de la IA médica suele ser multidimensional. El proceso de anotación en el archivo adjunto califica por separado la precisión de las respuestas, la relevancia del contenido, la claridad estructural, el respaldo de la evidencia, la utilidad para la toma de decisiones y la tasa de adopción clínica, y requiere que los anotadores expliquen los motivos de las deducciones y brinden sugerencias para mejorar la lógica médica. Este diseño tiene un valor importante: una respuesta puede ser objetivamente correcta pero no responder a la pregunta real del paciente; puede tener una estructura completa pero carecer de evidencia; o puede tener una cita correcta pero omitir una contraindicación clave. Una sola etiqueta “bueno/malo” no puede ayudar a los equipos modelo a localizar defectos.
Se debe proporcionar una descripción del anclaje para cada dimensión. Por ejemplo, la precisión se centra en si los hechos médicos son correctos y si existen omisiones o contradicciones clave; la relevancia se centra en si la respuesta responde a la pregunta inicial y al contexto del paciente; el respaldo de la evidencia se centra en si las conclusiones clave tienen fuentes verificables o un razonamiento razonable; la asistencia para la toma de decisiones se centra en si la información ayuda a los profesionales a completar la tarea actual; la claridad estructural se centra en si el contenido es fácil de leer y revisar; Las dimensiones clínicas relacionadas con la adopción deben limitar los objetos de juicio y la evidencia, y no pueden permitir que los anotadores especulen de la nada "si el médico lo adoptará". La escala de puntuación debe explicar la diferencia entre puntuaciones adyacentes, así como cómo manejar puntuaciones completas, puntuaciones bajas y puntuaciones indecidibles.
Más importante aún, las partituras deben llevar etiquetas de defectos y justificaciones. Se recomienda establecer tipos de error como errores fácticos, omisiones, inferencia excesiva, discrepancia de evidencia, omisión de condiciones del paciente, advertencia de riesgo insuficiente, confusión cronológica, gráficos y texto inconsistentes, problemas de formato o legibilidad, etc. Cada comentario debe identificar dónde ocurrió el problema, explicar por qué es importante y, si es posible, brindar instrucciones para mejorar. Los anotadores no pueden simplemente copiar respuestas ni reemplazar el juicio médico con opiniones de poco valor, como la puntuación y el formato. Una vez que las etiquetas de error se asocian con segmentos específicos, se puede utilizar el entrenamiento del modelo para construir pares de preferencias, muestras de corrección o conjuntos de prueba seguros.
Utilice revisión doble, pruebas ciegas y arbitraje para controlar las desviaciones de juicio
El núcleo de las pruebas ciegas es reducir las ideas preconcebidas de los anotadores sobre la identidad del modelo, el proveedor, la versión o los resultados esperados. Al comparar dos o más respuestas, el orden de presentación debe ser aleatorio, la fuente de información debe ocultarse, se debe utilizar la misma pregunta y el mismo contexto del paciente, y los anotadores deben calificarse por separado en las mismas dimensiones antes de la comparación. Si se evalúan las respuestas humanas y de IA, las indicaciones y las condiciones de los datos deben ser lo más consistentes posible. Mostrar dos respuestas una al lado de la otra, pero dejar que los jueces sepan cuál proviene del modelo, no puede considerarse suficiente ceguera. El proyecto
puede adoptar dobles estándares estratificados basados en el riesgo y el presupuesto: todas las preguntas de alto riesgo, preguntas difíciles y preguntas relacionadas con la seguridad serán calificadas de forma independiente por dos revisores calificados; una parte de las preguntas comunes se seleccionará según un doble rasero para monitorear continuamente la coherencia; Las muestras con grandes diferencias serán arbitradas por un tercero o un médico experimentado. Cada anotador debe tener un código anónimo estable, una versión de la tarea de registro, una versión de la guía, un revisor, una conclusión del arbitraje y el motivo del cambio. En lugar de simplemente utilizar un voto mayoritario para anular una opinión minoritaria, el arbitraje debe conservar las categorías de desacuerdo: si la definición no es clara, fuentes de evidencia contradictorias, contexto incompleto o diferencias clínicas legítimas.
El índice de coherencia debe coincidir con el tipo de etiqueta. Las etiquetas de clasificación pueden utilizar indicadores de corrección de probabilidad como la kappa de Cohen o la kappa de Fleiss; la puntuación continua puede considerar coeficientes de correlación intragrupo o análisis de correlación, combinados con rangos de divergencia; La extracción de entidades puede informar reglas de precisión, recuperación, F1 y coincidencia de límites. El tamaño de la muestra, la distribución de categorías y el número de anotadores afectarán la interpretación del índice, y no se puede afirmar que la anotación es confiable simplemente publicando una puntuación de coherencia. La baja consistencia a veces indica que la definición de la tarea es vaga, a veces indica que el caso en sí es clínicamente ambiguo y también puede reflejar una capacitación de revisión insuficiente y se debe devolver el análisis de muestras de desacuerdo específicas. Al interpretar la coherencia, también se deben informar simultáneamente la tasa de coherencia original, la frecuencia de cada etiqueta, el número de revisores, el método de extracción de muestras de doble estándar y el intervalo de confianza. Cuando las categorías están extremadamente desequilibradas, las métricas corregidas por el azar pueden ser inconsistentes con el acuerdo intuitivo; por lo tanto, los métodos estadísticos deben elegirse según el tipo de etiqueta y el propósito del estudio, y los números deben interpretarse utilizando resultados estratificados y casos de desacuerdo. Si la muestra se extrae de múltiples especialidades o estratos de riesgo, el índice general puede enmascarar una falta de coherencia dentro de una subcategoría, y los subgrupos clave deben informarse por separado. El criterio de valoración principal, el criterio de valoración secundario y el plan de análisis deben redactarse con antelación antes de que se lance el proyecto para reducir el espacio para seleccionar indicadores favorables posteriormente. La etiqueta final después del arbitraje no puede reemplazar el resultado de coherencia antes del arbitraje: la primera describe la entrega final y la segunda refleja si las reglas pueden implementarse de manera independiente y estable.
El marco de evaluación del manual médico LLM publicado en "npj Digital Medicine" en 2024 divide el proceso de evaluación en etapas como planificación, ejecución y arbitraje, puntuación y revisión, y enfatiza que los objetivos, los revisores, la selección de muestras, los indicadores de evaluación y los métodos estadísticos deben diseñarse con anticipación.[1] Otro estudio de modelos de lenguaje visual en radiología empleó una comparación ciega de preferencias y una tarea de revisión de errores e informó desacuerdos significativos entre los revisores, lo que sugiere que las opiniones de los expertos no forman automáticamente un valor de verdad único.[2] Por lo tanto, el objetivo del proyecto de anotación no es encubrir los desacuerdos, sino hacerlos mensurables, rastreables y resolubles. El conjunto de evaluación
debería evitar la fuga de datos y la contaminación de preguntas.
Los conjuntos de evaluación de IA clínica deben establecer límites de gestión antes de la capacitación y el desarrollo. Las muestras a nivel de paciente no se pueden repetir entre el entrenamiento y las pruebas; Las filtraciones también pueden ocurrir a partir de reescrituras aproximadas del mismo historial médico, diferentes fragmentos de la misma imagen o segmentos divididos de la misma conversación. Para los datos longitudinales, también es necesario verificar si la información futura ingresa en la entrada de la pregunta actual; Para las preguntas y respuestas sobre conocimientos médicos, se debe monitorear la posibilidad de que las preguntas del público sean absorbidas por el corpus de capacitación modelo. El responsable de la evaluación debe gestionar los derechos de acceso, versiones, registros de extracción y exposición de preguntas. Después de revisiones importantes, debería decidir si continúa utilizando el conjunto de prueba original.
En los últimos años, los puntos de referencia médicos multimodales han comenzado a pasar de preguntas y respuestas de una sola ronda a estructuras de tareas reales. SMMILE de NeurIPS 2025 es una evaluación de aprendizaje contextual multimodal construida por expertos médicos. El estudio encontró que las capacidades de la mayoría de los modelos probados en tareas multimodales abiertas aún son limitadas y los ejemplos irrelevantes pueden reducir el rendimiento.[3] El MTBBench de la misma sesión se centró en problemas de toma de decisiones sobre tumores longitudinales y multimodales, señalando que el modelo aún muestra un rendimiento poco confiable cuando se trata de cambios de tiempo, evidencia contradictoria e información intermodal.[4] Estos estudios respaldan un juicio práctico: las preguntas de evaluación deben conservar suficiente contexto clínico y probar sistemáticamente la capacidad del modelo para manejar conflictos, eliminaciones y cambios de tiempo, y las capacidades clínicas no pueden inferirse únicamente mediante preguntas breves y preguntas de opción múltiple.
también define la cobertura y la dificultad de las tareas. Puede cubrir problemas comunes, situaciones raras, riesgos críticos y graves, grupos especiales, datos incompletos, conflictos de evidencia, correlaciones intermodales y cambios de capas a largo plazo. El número de muestras y la distribución de fuentes se informan para cada estrato. Además de la puntuación promedio, también se deben examinar las tasas de error de alto riesgo, las tasas de recuperación de defectos críticos, el desempeño de los subgrupos, los intervalos de confianza y la incertidumbre en los resultados del modelo. Para escenarios de “no sé” o “información insuficiente”, la negativa apropiada a responder o solicitar información adicional debe considerarse como un comportamiento evaluable, y no se puede obligar a que cada pregunta se asigne a una conclusión médica.
El proceso de anotación necesita gestionar la deriva del revisor
Los expertos también cambiarán la escala de juicio a medida que avance el proyecto. En proyectos largos, las actualizaciones de las directrices, la rotación de personal, la fatiga o la recurrencia de errores comunes pueden hacer que el significado de la misma etiqueta varíe de un mes a otro. Se puede conservar un conjunto de preguntas ancla que no se notifican con anticipación y se pueden insertar tareas de anotación periódicamente para comparar la coherencia de las revisiones antiguas y nuevas; Los anotadores que continúan desviándose de las normas pueden volver a capacitarse y revisar sus resultados recientes. Las preguntas ancla también deben actualizarse periódicamente para evitar que los revisores simplemente memoricen las respuestas en lugar de comprender los principios de juicio. Se debe registrar el alcance del impacto para cada cambio en las pautas y se debe determinar si es necesario volver a etiquetar los lotes antiguos o solo versionarlos.
La auditoría de datos de anotaciones médicas debe centrarse tanto en las muestras como en los revisores. El lado de la muestra registra la fuente, el estado de desensibilización, la integridad del contexto, la versión de la tarea y la ubicación de la evidencia; el lado del personal solo conserva la codificación anónima, el tipo de calificación, el estado de la capacitación y los resultados de la revisión necesarios para completar la auditoría de calidad. Los evaluadores deben reducir la exposición innecesaria de la información del paciente, presentar el contenido necesario para completar el juicio en la interfaz de la tarea y controlar los permisos de exportación, descarga y acceso. Si la muestra incluye voz, imágenes o texto libre, se debe incluir información de identificación directa y pistas de identificación combinables en la verificación de desensibilización, en lugar de simplemente buscar en el campo del nombre.
Distinga también entre "respuesta correcta" y "respuesta segura". El modelo puede ofrecer contenido objetivamente correcto sin especificar condiciones aplicables, contraindicaciones o consejos médicos de emergencia; También puede hacer sugerencias arriesgadas e incorrectas, pero el texto es muy fluido. Las anotaciones de seguridad requieren una estratificación de gravedad independiente y rutas de daño claras, capacidad de detección de errores y capacidades de interceptación manual en escenarios de uso reales. Para situaciones que pueden provocar retrasos en el diagnóstico y tratamiento o un tratamiento inadecuado, la condición de aprobación no puede basarse únicamente en la precisión promedio que alcanza el umbral. Se debe establecer un umbral de falla y una acción de escalamiento separados.
Convierta los resultados de las pruebas ciegas en un circuito cerrado de calidad ejecutable
Una prueba a ciegas no es el final del proyecto. Los resultados deben devolverse a los datos, especificaciones, modelos y procesos del producto: si el error proviene de campos faltantes, completar el diccionario de datos o ingresar información; si el error proviene de confusión de conceptos médicos, revisar el sistema de etiquetado y agregar muestras de control; si el error proviene de la cita de evidencia, verifique la fuente de búsqueda y la correspondencia de referencia; si el error proviene de una falta de coincidencia multimodal, revise el mapeo de archivos y la asociación del paciente; si diferentes expertos continúan en desacuerdo, complemente la definición de límites o marque la situación como que requiere juicio clínico. Cada ronda de optimización debe conservar la versión de la tarea, la versión de muestra, la versión del modelo, las condiciones de revisión y las diferencias de resultados para evitar unir directamente puntuaciones incomparables en una curva de progreso.
La gestión de proyectos puede establecer tres etapas: umbral de inicio, calidad del proceso y aceptación de la entrega. El umbral de inicio verifica si la guía pasa la oferta de prueba, si los expertos médicos confirman las reglas y si las muestras de evaluación se conservan de forma independiente; la calidad del proceso monitorea la tasa de error de muestreo, la deriva del anotador y la tasa de arbitraje; La aceptación de la entrega verifica la integridad de los campos, la precisión médica, la trazabilidad de las pruebas, el cumplimiento de la privacidad y las versiones de los archivos. Establecer diferentes niveles de gravedad para la clasificación de errores: los defectos que impliquen errores de diagnóstico importantes o filtraciones de privacidad deberían dar lugar a una suspensión y una investigación exhaustiva; Los errores de formato generales se pueden dirigir a reparar. Los términos de liquidación y recompra deben ser consistentes con la versión de la regla para evitar el uso de diferentes calibres de puntuación para diferentes lotes.
El etiquetado médico no debe utilizar “muchas opiniones” como evidencia de alta calidad. Las anotaciones de alta calidad pueden indicarle al equipo modelo: dónde es incorrecta la respuesta, por qué el error es importante, de qué contexto proviene la evidencia, si existe un desacuerdo razonable entre los médicos y cómo verificarlo en la siguiente ronda de capacitación o cambios de producto. Para aplicaciones clínicas, también debe quedar claro que los resultados de la IA son información auxiliar, que debe ser revisada por profesionales en función de la situación real del paciente, la evidencia más reciente y los procesos institucionales. Las revisiones de anotaciones pueden ayudar a descubrir los límites del sistema, pero no sustituyen la responsabilidad clínica ni la evaluación de seguridad en el mundo real.
Las capacidades de etiquetado médico de Langhui deben reflejarse en el proceso de trazabilidad
presenta los servicios de datos médicos de Langhui al mundo exterior y recomienda centrarse en el diseño de especificaciones de etiquetado, la colaboración de expertos médicos, la evaluación ciega, el arbitraje de calidad y el circuito cerrado de defectos, en lugar de centrarse únicamente en la producción. Al implementar el proyecto, los objetivos del cliente se convierten primero en descripciones de tareas y estándares de puntuación, y luego se calibra la comprensión de las diferentes revisiones mediante pequeños lotes de estándares de prueba; después de ingresar al trabajo formal, se establece una revisión para las muestras de alto riesgo y se conservan los motivos y las vías de arbitraje para los desacuerdos en la revisión; Durante la entrega se proporcionan versiones, estadísticas de inspección aleatoria y registros de reparación de problemas. El tipo de calificación específico, las calificaciones de los expertos, el índice de muestreo y el compromiso de aceptación estarán sujetos al alcance del proyecto y al acuerdo del contrato.
El valor real de esta capacidad para el equipo médico de IA es que el conjunto de datos no solo puede usarse para entrenamiento, sino que también puede convertirse en una herramienta estable para medir la mejora del modelo. Los expertos médicos pueden ver muestras de evidencia y registros de disputas, los equipos de algoritmos pueden asignar defectos a tareas de capacitación o evaluación, y los compradores pueden verificar que cada lote de entregas cumpla con las reglas establecidas. Al recomprar, ambas partes ajustan las instrucciones de la etiqueta y las estrategias de muestreo en función de la distribución de defectos del lote anterior, formando gradualmente una línea de base de evaluación médica reutilizable.
Preguntas frecuentes
Hay diferencias en las calificaciones de los médicos, ¿eso significa que la anotación no es válida? No es suficiente. incierto. Los desacuerdos pueden surgir de reglas poco claras, datos incompletos o la existencia de múltiples opciones clínicamente razonables. Se debe medir el acuerdo, clasificar las razones del desacuerdo y manejarlo mediante la complementación de directrices o el arbitraje de expertos en lugar de eliminar directamente los desacuerdos.
¿La prueba ciega tiene que ocultar completamente la identidad del modelo? Para las evaluaciones que comparan los resultados del modelo, ocultar la identidad del modelo y aleatorizar el orden a menudo reduce el sesgo de expectativas. Si la tarea en sí debe conocer la información de la herramienta, esta limitación debe documentarse y utilizarse otros medios para reducir el sesgo, como revisión independiente, indicadores preestablecidos y presentación anónima.
¿Cómo se deben seleccionar muestras de POC representativas? Además de los resultados de las anotaciones, también se deben entregar definiciones de tareas, especificaciones de etiquetas, registros de versiones, estadísticas de muestreo y consistencia, registros de arbitraje, clasificación de defectos e instrucciones de procesamiento de cumplimiento. Sólo entonces se podrán revisar, volver a capacitar y utilizar los resultados para evaluaciones posteriores.
Referencias
[1] Tam et al. Un marco para la evaluación humana de grandes modelos de lenguaje en atención médica derivado de la revisión de la literatura. npj Medicina digital, 2024. https://doi.org/10.1038/s41746-024-01258-7
[2] Colaboración entre médicos y modelos de lenguaje visual en la generación de informes de radiología. Medicina natural, 2025. https://www.nature.com/articles/s41591-024-03302-1
[3] Rieff et al. SMMILE: Un punto de referencia impulsado por expertos para el aprendizaje médico multimodal en contexto. Seguimiento de conjuntos de datos y puntos de referencia de NeurIPS 2025. https://doi.org/10.52202/085713-2180
[4] Vasilev et al. MTBBench: un punto de referencia de toma de decisiones clínicas secuenciales multimodales en oncología. Seguimiento de conjuntos de datos y puntos de referencia de NeurIPS 2025. https://doi.org/10.52202/085713-0368
[5] Grupo directivo STARD-AI. La guía de informes STARD-AI para estudios de precisión diagnóstica que utilizan inteligencia artificial. Medicina natural, 2025. https://doi.org/10.1038/s41591-025-03953-8