सबसे पहले लेबलिंग ऑब्जेक्ट और निर्णय सीमा को परिभाषित करें
"मेडिकल एनोटेशन" एक समान कार्य नहीं है। यह निर्धारित करना कि उत्तर सटीक हैं या नहीं, मेडिकल रिकॉर्ड से संस्थाओं को निकालना, छवियों में घावों की पहचान करना, यह निर्धारित करना कि क्या रिपोर्ट छवियों से मेल खाती है, और डॉक्टर-रोगी की बातचीत को इरादे की श्रेणियों में चिह्नित करना, प्रत्येक के लिए अलग-अलग लेबल परिभाषाओं और संदर्भ आधारों की आवश्यकता होती है। शुरू करने से पहले, कार्य को एक समस्या में विभाजित किया जाना चाहिए जिसे स्वतंत्र रूप से आंका जा सके: एनोटेटर कौन सा इनपुट देखता है, कौन से लेबल या संशोधन आउटपुट होते हैं, किस डेटा पर भरोसा करने की अनुमति है, किन स्थितियों को अनिश्चित के रूप में चिह्नित किया जाना चाहिए, और लापता या विरोधाभासी जानकारी से कैसे निपटना है। यदि ये सीमाएँ स्पष्ट रूप से नहीं लिखी गई हैं, तो एनोटेटर व्यक्तिगत अनुभव के आधार पर परिभाषाएँ भर देगा, और टीमों के बीच मतभेदों को प्रशिक्षण लेबल में मिला दिया जाएगा।
एक प्रभावी मेडिकल एनोटेशन गाइड में कम से कम कार्य का उद्देश्य, समावेशन और बहिष्करण मानदंड, लेबल परिभाषा, सकारात्मक और नकारात्मक उदाहरणों के सिद्धांत, सीमा मामले, साक्ष्य प्राथमिकता, लापता मूल्य प्रसंस्करण और उन्नयन नियम शामिल होने चाहिए। गाइड को केवल लेबल नामों की एक सूची नहीं देनी चाहिए, बल्कि यह भी बताना चाहिए कि क्या लेबल परस्पर अनन्य हैं, क्या उन्हें एकाधिक-चयनित किया जा सकता है, क्या लेबल वाक्यों या संपूर्ण मेडिकल रिकॉर्ड पर लागू होता है, और नकारात्मक और ऐतिहासिक जानकारी को कैसे संभालना है। मेडिकल प्रश्नोत्तर के लिए, "गलत तथ्य", "अपर्याप्त साक्ष्य", "उत्तर जो प्रश्न का समाधान नहीं करते", "अपठनीय संरचना" और "लागू शर्तों की कमी वाले सुझाव" को अलग किया जाना चाहिए; मेडिकल रिकॉर्ड निकालने के लिए, यह भी बताया जाना चाहिए कि रोगी की मुख्य शिकायत, पिछला इतिहास, वर्तमान निदान, लंबित निदान और पारिवारिक इतिहास को एक रोग इकाई में नहीं मिलाया जा सकता है।
चिकित्सा परिदृश्यों में, एनोटेटर की पेशेवर पृष्ठभूमि और कार्य मिलान भी महत्वपूर्ण हैं। मेडिकल शब्दावली प्रूफरीडिंग, दिशानिर्देश साक्ष्य मूल्यांकन, नैदानिक निर्णय लेने में सहायता स्कोरिंग, और छवि घाव स्थानीयकरण जैसे कार्य डिफ़ॉल्ट रूप से समान योग्यता वाले एनोटेटर्स द्वारा पूरे नहीं किए जाने चाहिए। परियोजना को डॉक्टरों की पेशेवर दिशा, कार्य वर्ष या योग्यता आवश्यकताओं और कार्यों के बीच संबंधों की व्याख्या करनी चाहिए, आवश्यक प्रशिक्षण प्रदान करना चाहिए, और यह पुष्टि करने के लिए कार्य मूल्यांकन का उपयोग करना चाहिए कि एनोटेटर विनिर्देशों को समझते हैं। ऐसी सामग्री के लिए जिसमें उच्च जोखिम वाले निदान या उपचार की सिफारिशें शामिल हो सकती हैं, गैर-पेशेवर व्याख्याकारों को स्वतंत्र रूप से चिकित्सा सुरक्षा का मूल्यांकन करने की अनुमति देने से बचने के लिए एक नैदानिक विशेषज्ञ समीक्षा और विवाद वृद्धि तंत्र स्थापित किया जाना चाहिए।
व्यक्तिपरक निर्णय को कई अवलोकन योग्य आयामों में विभाजित करें
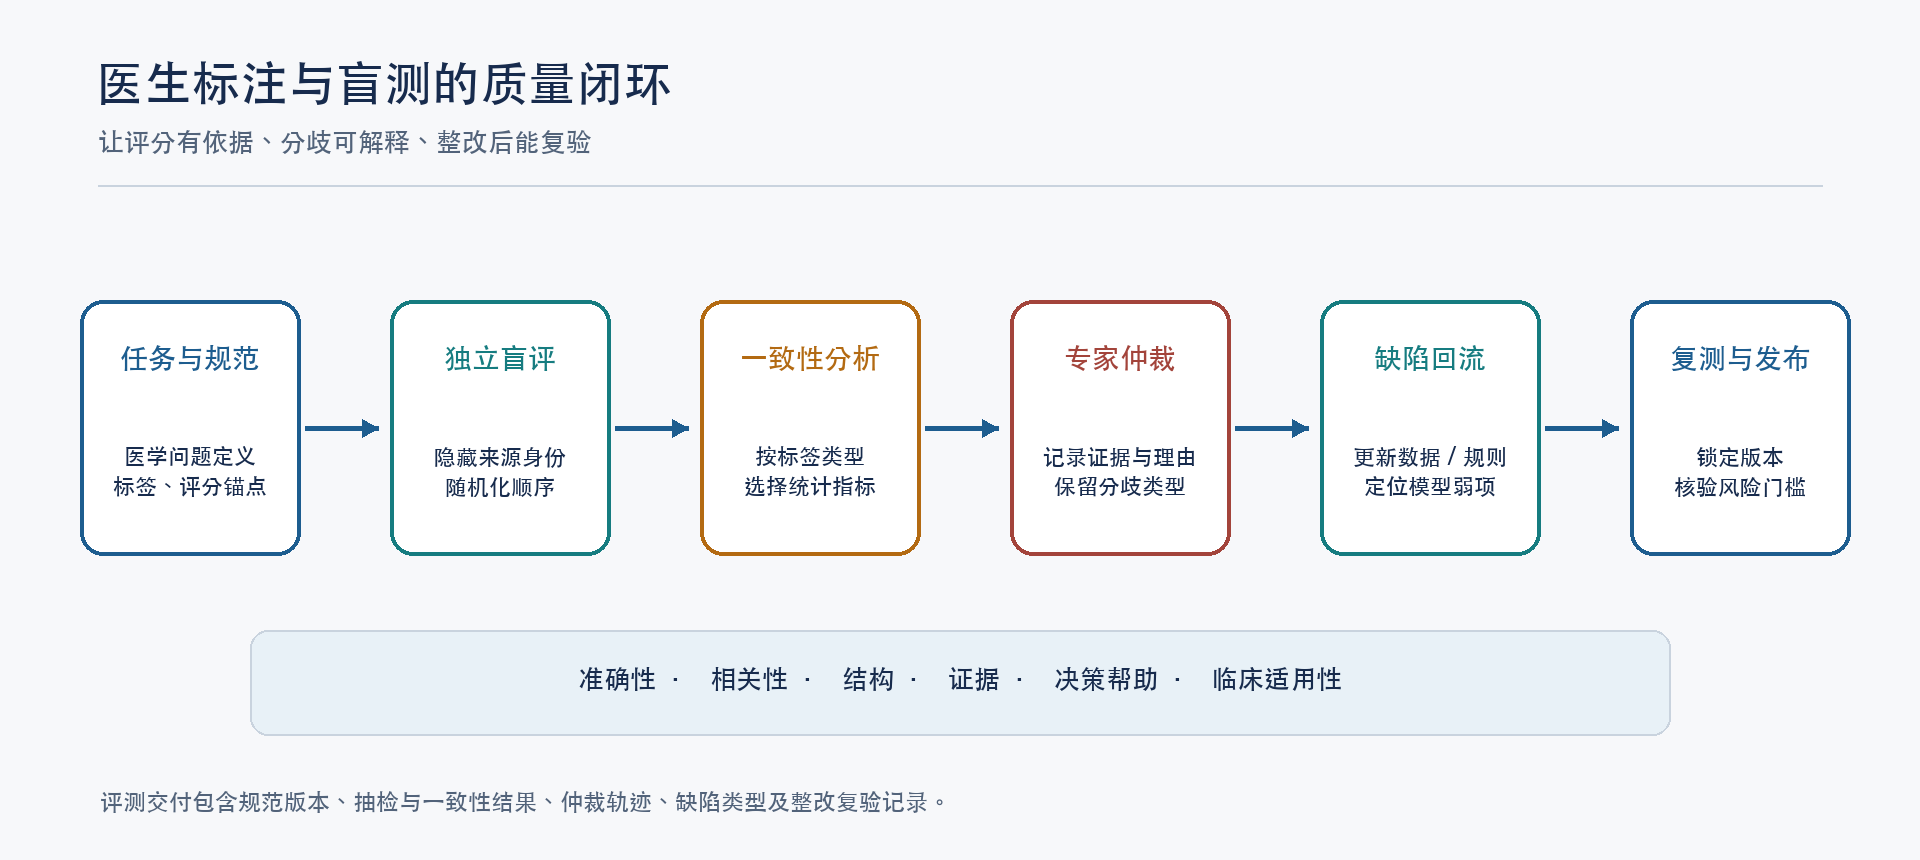
मेडिकल एआई उत्तरों की गुणवत्ता अक्सर बहुआयामी होती है। अनुलग्नक में एनोटेशन प्रक्रिया अलग-अलग उत्तर सटीकता, सामग्री प्रासंगिकता, संरचनात्मक स्पष्टता, साक्ष्य समर्थन, निर्णय लेने में सहायता और नैदानिक गोद लेने की दर को स्कोर करती है, और एनोटेटर्स को कटौती के कारणों को समझाने और चिकित्सा तर्क में सुधार के लिए सुझाव देने की आवश्यकता होती है। इस डिज़ाइन का महत्वपूर्ण महत्व है: एक उत्तर तथ्यात्मक रूप से सही हो सकता है लेकिन रोगी के वास्तविक प्रश्न का उत्तर नहीं दे सकता; इसकी पूरी संरचना हो सकती है लेकिन साक्ष्य का अभाव है; या हो सकता है कि इसमें एक सही उद्धरण हो लेकिन एक मुख्य विरोधाभास छूट गया हो। एकल "अच्छा/बुरा" लेबल दोषों का पता लगाने में मॉडल टीमों का समर्थन नहीं कर सकता है।
प्रत्येक आयाम के लिए एक एंकर विवरण प्रदान किया जाना चाहिए। उदाहरण के लिए, सटीकता इस बात पर ध्यान केंद्रित करती है कि क्या चिकित्सा तथ्य सही हैं और क्या कोई महत्वपूर्ण चूक या विरोधाभास हैं; प्रासंगिकता इस बात पर केंद्रित है कि क्या उत्तर इनपुट प्रश्न और रोगी के संदर्भ का जवाब देता है; साक्ष्य समर्थन इस पर केंद्रित है कि क्या मुख्य निष्कर्षों में सत्यापन योग्य स्रोत या उचित तर्क हैं; निर्णय लेने में सहायता इस बात पर केंद्रित है कि क्या जानकारी पेशेवरों को वर्तमान कार्य पूरा करने में मदद करती है; संरचनात्मक स्पष्टता इस बात पर केंद्रित है कि क्या सामग्री को पढ़ना और समीक्षा करना आसान है; नैदानिक गोद लेने से संबंधित आयामों को निर्णय की वस्तुओं और सबूतों को सीमित करना चाहिए, और व्याख्याकारों को हवा में अनुमान लगाने की अनुमति नहीं देनी चाहिए "क्या डॉक्टर इसे अपनाएंगे।"स्कोरिंग स्केल को आसन्न स्कोर के बीच अंतर को समझाने की जरूरत है, साथ ही पूर्ण स्कोर, कम स्कोर और अनिर्णीत स्कोर को कैसे संभालना है।
इससे भी महत्वपूर्ण बात यह है कि स्कोर में दोष लेबल और औचित्य होना चाहिए। तथ्यात्मक त्रुटियां, चूक, अति-अनुमान, साक्ष्य बेमेल, रोगी की स्थितियों की चूक, अपर्याप्त जोखिम चेतावनी, कालानुक्रमिक भ्रम, असंगत ग्राफिक्स और पाठ, स्वरूपण या पठनीयता मुद्दे आदि जैसे त्रुटि प्रकार सेट करने की अनुशंसा की जाती है। प्रत्येक टिप्पणी में यह पहचानना चाहिए कि समस्या कहां हुई, समझाएं कि यह क्यों महत्वपूर्ण है, और यदि संभव हो तो सुधार के लिए निर्देश दें। एनोटेटर केवल उत्तरों की नकल नहीं कर सकते हैं, न ही वे चिकित्सा निर्णय को विराम चिह्न और प्रारूपण जैसी कम-मूल्य वाली राय से बदल सकते हैं। त्रुटि लेबल विशिष्ट खंडों से जुड़े होने के बाद, मॉडल प्रशिक्षण का उपयोग वरीयता जोड़े, सुधार नमूने या सुरक्षित परीक्षण सेट बनाने के लिए किया जा सकता है।
निर्णय विचलन को नियंत्रित करने के लिए दोहरी समीक्षा, अंधा परीक्षण और मध्यस्थता का उपयोग करें
ब्लाइंड परीक्षण का मूल मॉडल पहचान, आपूर्तिकर्ता, संस्करण या अपेक्षित परिणामों के बारे में एनोटेटर्स की पूर्व धारणाओं को कम करना है। दो या दो से अधिक प्रतिक्रियाओं की तुलना करते समय, प्रस्तुति के क्रम को यादृच्छिक किया जाना चाहिए, स्रोत जानकारी को छिपाया जाना चाहिए, एक ही प्रश्न और रोगी संदर्भ का उपयोग किया जाना चाहिए, और तुलना से पहले एनोटेटर्स को समान आयामों पर अलग से रेट किया जाना चाहिए। यदि एआई और मानव उत्तरों का मूल्यांकन किया जा रहा है, तो संकेत और डेटा स्थितियां यथासंभव सुसंगत होनी चाहिए। केवल दो प्रतिक्रियाओं को एक साथ दिखाना, लेकिन न्यायाधीशों को यह बता देना कि कौन सा मॉडल से आता है, पर्याप्त अंधापन नहीं कहा जा सकता।
परियोजना जोखिम और बजट के आधार पर स्तरीकृत दोहरे मानकों को अपना सकती है: सभी उच्च जोखिम वाले प्रश्न, कठिन प्रश्न और सुरक्षा से संबंधित प्रश्नों को दो योग्य समीक्षकों द्वारा स्वतंत्र रूप से चिह्नित किया जाएगा; निरंतरता की निरंतर निगरानी के लिए सामान्य प्रश्नों के एक हिस्से को दोहरे मानकों के लिए चुना जाएगा; उच्च अंतर वाले नमूनों की मध्यस्थता किसी तीसरे पक्ष या वरिष्ठ डॉक्टर द्वारा की जाएगी। प्रत्येक एनोटेटर के पास एक स्थिर अनाम कोड, रिकॉर्डिंग कार्य संस्करण, गाइड संस्करण, समीक्षक, मध्यस्थता निष्कर्ष और परिवर्तन का कारण होना चाहिए। अल्पसंख्यक राय को खत्म करने के लिए केवल बहुमत के वोट का उपयोग करने के बजाय, मध्यस्थता को असहमति की श्रेणियों को बनाए रखना चाहिए: चाहे परिभाषा अस्पष्ट हो, साक्ष्य के परस्पर विरोधी स्रोत हों, अधूरा संदर्भ हो, या वैध नैदानिक मतभेद हों।
संगतता सूचकांक टैग प्रकार से मेल खाना चाहिए। वर्गीकरण लेबल कोहेन के कप्पा या फ्लेस के कप्पा जैसे मौका सुधार संकेतकों का उपयोग कर सकते हैं; निरंतर स्कोरिंग अंतर-समूह सहसंबंध गुणांक या सहसंबंध विश्लेषण पर विचार कर सकती है, जो विचलन श्रेणियों के साथ संयुक्त है; इकाई निष्कर्षण सटीक, रिकॉल, F1 और सीमा मिलान नियमों की रिपोर्ट कर सकता है। नमूना आकार, श्रेणी वितरण, और एनोटेटर्स की संख्या सूचकांक की व्याख्या को प्रभावित करेगी, और आप यह दावा नहीं कर सकते कि एनोटेशन केवल एक स्थिरता स्कोर पोस्ट करके विश्वसनीय है। कम स्थिरता कभी-कभी इंगित करती है कि कार्य की परिभाषा अस्पष्ट है, कभी-कभी यह इंगित करता है कि मामला स्वयं चिकित्सकीय रूप से अस्पष्ट है, और यह अपर्याप्त समीक्षा प्रशिक्षण को भी प्रतिबिंबित कर सकता है, और विशिष्ट असहमति नमूनों का विश्लेषण वापस किया जाना चाहिए। स्थिरता की व्याख्या करते समय, मूल स्थिरता दर, प्रत्येक टैग की आवृत्ति, समीक्षकों की संख्या, दोहरे मानक नमूना निष्कर्षण विधि और आत्मविश्वास अंतराल को भी एक साथ रिपोर्ट किया जाना चाहिए। जब श्रेणियां अत्यधिक असंतुलित होती हैं, तो संयोग-सुधारित मेट्रिक्स सहज सहमति के साथ असंगत हो सकते हैं; इसलिए, सांख्यिकीय तरीकों को लेबल प्रकार और अध्ययन के उद्देश्य के आधार पर चुना जाना चाहिए, और स्तरीकृत परिणामों और असहमति के मामलों का उपयोग करके संख्याओं की व्याख्या की जानी चाहिए। यदि नमूना कई विशिष्टताओं या जोखिम स्तरों से लिया गया है, तो समग्र सूचकांक एक उपश्रेणी के भीतर स्थिरता की कमी को छुपा सकता है, और प्रमुख उपसमूहों को अलग से रिपोर्ट किया जाना चाहिए। प्राथमिक समापन बिंदु, द्वितीयक समापन बिंदु और विश्लेषण योजना परियोजना शुरू होने से पहले ही लिखी जानी चाहिए ताकि बाद में अनुकूल संकेतकों के चयन के लिए जगह कम हो सके। मध्यस्थता के बाद अंतिम लेबल मध्यस्थता से पहले स्थिरता परिणाम को प्रतिस्थापित नहीं कर सकता है: पूर्व अंतिम वितरण का वर्णन करता है, और बाद वाला दर्शाता है कि क्या नियमों को स्वतंत्र रूप से और स्थिर रूप से लागू किया जा सकता है।
2024 में "एनपीजे डिजिटल मेडिसिन" में प्रकाशित मेडिकल एलएलएम मैनुअल मूल्यांकन ढांचा मूल्यांकन प्रक्रिया को योजना, निष्पादन और मध्यस्थता, स्कोरिंग और समीक्षा जैसे चरणों में विभाजित करता है, और इस बात पर जोर देता है कि लक्ष्य, समीक्षक, नमूना चयन, मूल्यांकन संकेतक और सांख्यिकीय तरीकों को पहले से डिजाइन करने की आवश्यकता है।[1] रेडियोलॉजी में दृश्य भाषा मॉडल के एक अन्य अध्ययन में एक अंध प्राथमिकता तुलना और त्रुटि संशोधन कार्य को नियोजित किया गया और समीक्षकों के बीच महत्वपूर्ण असहमति की सूचना दी गई, जिससे पता चलता है कि विशेषज्ञ राय स्वचालित रूप से एक भी सत्य मान नहीं बनाती है।[2] इसलिए, एनोटेशन प्रोजेक्ट का लक्ष्य असहमतियों को छिपाना नहीं है, बल्कि उन्हें मापने योग्य, पता लगाने योग्य और समाधान योग्य बनाना है।
मूल्यांकन सेट को डेटा रिसाव और प्रश्न संदूषण को रोकना चाहिए
क्लिनिकल एआई मूल्यांकन सेट को प्रशिक्षण और विकास से पहले प्रबंधन सीमाएं निर्धारित करनी चाहिए। प्रशिक्षण और परीक्षण के बीच रोगी-स्तर के नमूने दोहराए नहीं जा सकते; लीक एक ही मेडिकल रिकॉर्ड के अनुमानित पुनर्लेखन, एक ही छवि के विभिन्न स्लाइस, या एक ही बातचीत के विभाजित खंडों से भी हो सकते हैं। अनुदैर्ध्य डेटा के लिए, यह जांचना भी आवश्यक है कि भविष्य की जानकारी वर्तमान प्रश्न इनपुट में प्रवेश करती है या नहीं; चिकित्सा ज्ञान प्रश्न और उत्तर के लिए, मॉडल प्रशिक्षण कोष द्वारा सार्वजनिक प्रश्नों को अवशोषित किए जाने की संभावना पर नजर रखी जानी चाहिए। मूल्यांकन के प्रभारी व्यक्ति को पहुंच अधिकार, संस्करण, निष्कर्षण रिकॉर्ड और प्रश्न प्रदर्शन का प्रबंधन करने की आवश्यकता होती है। प्रमुख संशोधनों के बाद, उसे यह निर्णय लेना चाहिए कि मूल परीक्षण सेट का उपयोग जारी रखना है या नहीं।
हाल के वर्षों में, मल्टीमॉडल मेडिकल बेंचमार्क एकल-दौर के प्रश्न और उत्तर से वास्तविक कार्य संरचनाओं की ओर स्थानांतरित होने लगे हैं। NeurIPS 2025 का SMMILE चिकित्सा विशेषज्ञों द्वारा निर्मित एक बहु-मोडल प्रासंगिक शिक्षण मूल्यांकन है। अध्ययन में पाया गया कि खुले मल्टी-मोडल कार्यों में अधिकांश परीक्षण किए गए मॉडलों की क्षमताएं अभी भी सीमित हैं, और अप्रासंगिक उदाहरण प्रदर्शन को कम कर सकते हैं।[3] उसी सत्र के MTBBench ने मल्टी-मोडल और अनुदैर्ध्य ट्यूमर निर्णय लेने की समस्याओं पर ध्यान केंद्रित किया, यह बताते हुए कि समय परिवर्तन, परस्पर विरोधी साक्ष्य और क्रॉस-मोडल जानकारी से निपटने के दौरान मॉडल अभी भी अविश्वसनीय प्रदर्शन प्रदर्शित करता है।[4] ये अध्ययन एक व्यावहारिक निर्णय का समर्थन करते हैं: मूल्यांकन प्रश्नों को पर्याप्त नैदानिक संदर्भ बनाए रखना चाहिए और संघर्षों, विलोपन और समय परिवर्तनों को संभालने के लिए मॉडल की क्षमता का व्यवस्थित रूप से परीक्षण करना चाहिए, और नैदानिक क्षमताओं का अनुमान केवल छोटे प्रश्नों और बहुविकल्पीय प्रश्नों से नहीं लगाया जा सकता है।
परीक्षण सेट कार्य कवरेज और कठिनाई को भी परिभाषित करता है। इसमें सामान्य समस्याएं, दुर्लभ स्थितियां, गंभीर और गंभीर जोखिम, विशेष समूह, अधूरा डेटा, साक्ष्य संघर्ष, क्रॉस-मोडल सहसंबंध और परतों में दीर्घकालिक परिवर्तन शामिल हो सकते हैं। प्रत्येक स्तर के लिए नमूनों की संख्या और स्रोत वितरण की सूचना दी जाती है। औसत स्कोर के अलावा, उच्च जोखिम वाली त्रुटि दर, गंभीर दोष रिकॉल दर, उपसमूह प्रदर्शन, आत्मविश्वास अंतराल और मॉडल आउटपुट में अनिश्चितता की भी जांच की जानी चाहिए।"पता नहीं" या "अपर्याप्त जानकारी" परिदृश्यों के लिए, उत्तर देने से उचित इनकार या अतिरिक्त जानकारी के अनुरोध को मूल्यांकन योग्य व्यवहार माना जाना चाहिए, और प्रत्येक प्रश्न को चिकित्सीय निष्कर्ष पर ले जाने के लिए बाध्य नहीं किया जा सकता है।
एनोटेशन प्रक्रिया को समीक्षक बहाव को प्रबंधित करने की आवश्यकता है
जैसे-जैसे परियोजना आगे बढ़ेगी विशेषज्ञ निर्णय के पैमाने को भी बदल देंगे। लंबी परियोजनाओं में, दिशानिर्देश अपडेट, स्टाफ टर्नओवर, थकान, या सामान्य त्रुटियों की पुनरावृत्ति के कारण एक ही लेबल का अर्थ महीने-दर-महीने भटक सकता है। एंकर प्रश्नों का एक सेट जो पहले से अधिसूचित नहीं किया गया है, उसे बनाए रखा जा सकता है, और पुरानी और नई समीक्षाओं की स्थिरता की तुलना करने के लिए एनोटेशन कार्यों को समय-समय पर डाला जा सकता है; जो व्याख्याकार मानदंडों से भटकना जारी रखते हैं, उन्हें पुनः प्रशिक्षित किया जा सकता है और उनके हाल के परिणामों की समीक्षा की जा सकती है। एंकर प्रश्नों को भी नियमित रूप से अद्यतन किया जाना चाहिए ताकि समीक्षकों को निर्णय के सिद्धांतों को समझने के बजाय केवल उत्तर याद रखने से रोका जा सके। प्रत्येक दिशानिर्देश परिवर्तन के लिए प्रभाव का दायरा दर्ज किया जाना चाहिए, और यह निर्धारित किया जाना चाहिए कि पुराने बैचों को फिर से लेबल करने की आवश्यकता है या केवल संस्करण की आवश्यकता है।
मेडिकल एनोटेशन के डेटा ऑडिटिंग को नमूनों और समीक्षकों दोनों पर ध्यान केंद्रित करना चाहिए। नमूना पक्ष स्रोत, डिसेन्सिटाइजेशन स्थिति, संदर्भ अखंडता, कार्य संस्करण और साक्ष्य स्थान को रिकॉर्ड करता है; कार्मिक पक्ष केवल गुणवत्ता लेखापरीक्षा को पूरा करने के लिए आवश्यक अनाम कोडिंग, योग्यता प्रकार, प्रशिक्षण स्थिति और समीक्षा परिणामों को बरकरार रखता है। मूल्यांकनकर्ताओं को रोगी की जानकारी के अनावश्यक प्रदर्शन को कम करना चाहिए, कार्य इंटरफ़ेस पर निर्णय को पूरा करने के लिए आवश्यक सामग्री प्रस्तुत करनी चाहिए, और निर्यात, डाउनलोड और एक्सेस अनुमतियों को नियंत्रित करना चाहिए। यदि नमूने में भाषण, चित्र या मुक्त पाठ शामिल है, तो केवल नाम फ़ील्ड खोजने के बजाय, प्रत्यक्ष पहचान जानकारी और संयोजन योग्य पहचान सुराग को डिसेन्सिटाइजेशन जांच में शामिल किया जाना चाहिए।
"सही उत्तर" और "सुरक्षित उत्तर" के बीच भी अंतर करें। मॉडल लागू शर्तों, मतभेदों या आपातकालीन चिकित्सा सलाह को निर्दिष्ट किए बिना तथ्यात्मक रूप से सही सामग्री दे सकता है; यह जोखिम भरा और गलत सुझाव भी दे सकता है, लेकिन पाठ बहुत धाराप्रवाह है। सुरक्षा एनोटेशन के लिए स्वतंत्र गंभीरता स्तरीकरण और वास्तविक उपयोग परिदृश्यों के आसपास स्पष्ट नुकसान पथ, त्रुटि खोज क्षमता और मैन्युअल अवरोधन क्षमताओं की आवश्यकता होती है। ऐसी स्थितियों के लिए जो निदान और उपचार में देरी या अनुचित उपचार का कारण बन सकती हैं, पारित होने की स्थिति केवल सीमा तक पहुंचने वाली औसत सटीकता पर आधारित नहीं हो सकती है। एक अलग विफलता सीमा और वृद्धि कार्रवाई निर्धारित की जानी चाहिए।
ब्लाइंड परीक्षण परिणामों को निष्पादन योग्य गुणवत्ता वाले बंद लूप में बदलें
एक ब्लाइंड परीक्षण परियोजना का अंत नहीं है। परिणामों को डेटा, विनिर्देशों, मॉडलों और उत्पाद प्रक्रियाओं में वापस करने की आवश्यकता है: यदि त्रुटि लापता फ़ील्ड से आती है, तो डेटा शब्दकोश या इनपुट जानकारी को पूरा करें; यदि त्रुटि चिकित्सा अवधारणा भ्रम से आती है, तो लेबलिंग प्रणाली को संशोधित करें और नियंत्रण नमूने जोड़ें; यदि त्रुटि साक्ष्य उद्धरण से आती है, तो खोज स्रोत और संदर्भ पत्राचार की जाँच करें; यदि त्रुटि मल्टी-मोडल बेमेल से आती है, तो फ़ाइल मैपिंग और रोगी एसोसिएशन की समीक्षा करें; यदि विभिन्न विशेषज्ञ असहमत रहना जारी रखते हैं, तो सीमा परिभाषा को पूरक करें या स्थिति को नैदानिक निर्णय की आवश्यकता के रूप में चिह्नित करें। अनुकूलन के प्रत्येक दौर में प्रगति वक्र में अतुलनीय स्कोर को सीधे जोड़ने से बचने के लिए कार्य संस्करण, नमूना संस्करण, मॉडल संस्करण, समीक्षा की स्थिति और परिणाम अंतर को बनाए रखना चाहिए।
परियोजना प्रबंधन तीन चरण निर्धारित कर सकता है: स्टार्टअप सीमा, प्रक्रिया गुणवत्ता और वितरण स्वीकृति। स्टार्टअप थ्रेशोल्ड जांचता है कि क्या गाइड परीक्षण बोली पास करता है, क्या चिकित्सा विशेषज्ञ नियमों की पुष्टि करते हैं, और क्या मूल्यांकन नमूने स्वतंत्र रूप से रखे गए हैं; प्रक्रिया की गुणवत्ता नमूनाकरण त्रुटि दर, एनोटेटर बहाव और मध्यस्थता अनुपात की निगरानी करती है; डिलीवरी स्वीकृति फ़ील्ड की पूर्णता, चिकित्सा सटीकता, साक्ष्य पता लगाने की क्षमता, गोपनीयता अनुपालन और फ़ाइल संस्करणों की जाँच करती है। त्रुटि वर्गीकरण के लिए अलग-अलग गंभीरता स्तर निर्धारित करें: प्रमुख नैदानिक त्रुटियों या गोपनीयता लीक से जुड़े दोषों को निलंबन और व्यापक जांच को ट्रिगर करना चाहिए; सामान्य प्रारूप त्रुटियों को सुधारने के लिए निर्देशित किया जा सकता है। अलग-अलग बैचों के लिए अलग-अलग स्कोरिंग कैलिबर का उपयोग करने से बचने के लिए निपटान और पुनर्खरीद की शर्तें नियम संस्करण के अनुरूप होनी चाहिए।
मेडिकल लेबलिंग को उच्च गुणवत्ता के प्रमाण के रूप में "कई राय" का उपयोग नहीं करना चाहिए। उच्च-गुणवत्ता वाला एनोटेशन मॉडल टीम को बता सकता है: उत्तर कहां गलत है, त्रुटि क्यों महत्वपूर्ण है, सबूत किस संदर्भ से आते हैं, क्या डॉक्टरों के बीच उचित असहमति है, और प्रशिक्षण या उत्पाद परिवर्तन के अगले दौर में इसे कैसे सत्यापित किया जाए। नैदानिक अनुप्रयोगों के लिए, यह भी स्पष्ट किया जाना चाहिए कि एआई आउटपुट सहायक जानकारी है, जिसकी वास्तविक रोगी स्थिति, नवीनतम साक्ष्य और संस्थागत प्रक्रियाओं के आधार पर पेशेवरों द्वारा समीक्षा की जानी चाहिए। एनोटेशन समीक्षाएँ सिस्टम सीमाओं का पता लगाने में मदद कर सकती हैं लेकिन नैदानिक जवाबदेही या वास्तविक दुनिया सुरक्षा मूल्यांकन का विकल्प नहीं हैं।
लैंगहुई की मेडिकल लेबलिंग क्षमताओं को ट्रैसेबिलिटी प्रक्रिया में प्रतिबिंबित किया जाना चाहिए
लैंगहुई की चिकित्सा डेटा सेवाओं को बाहरी दुनिया से परिचित कराता है और अकेले आउटपुट पर जोर देने के बजाय लेबलिंग विनिर्देश डिजाइन, चिकित्सा विशेषज्ञ सहयोग, अंधा मूल्यांकन, गुणवत्ता मध्यस्थता और दोष बंद लूप पर ध्यान केंद्रित करने की सिफारिश करता है। परियोजना को लागू करते समय, ग्राहक लक्ष्यों को पहले कार्य विवरण और स्कोरिंग मानकों में परिवर्तित किया जाता है, और फिर विभिन्न समीक्षाओं की समझ को परीक्षण मानकों के छोटे बैचों के माध्यम से कैलिब्रेट किया जाता है; औपचारिक कार्य में प्रवेश करने के बाद, उच्च जोखिम वाले नमूनों के लिए समीक्षा स्थापित की जाती है, और समीक्षा असहमति के कारणों और मध्यस्थता ट्रैक को बरकरार रखा जाता है; डिलीवरी के दौरान संस्करण, यादृच्छिक निरीक्षण आँकड़े और समस्या मरम्मत रिकॉर्ड प्रदान किए जाते हैं। विशिष्ट अंकन प्रकार, विशेषज्ञ योग्यता, नमूना अनुपात और स्वीकृति प्रतिबद्धता परियोजना के दायरे और अनुबंध समझौते के अधीन होगी।
मेडिकल एआई टीम के लिए इस क्षमता का वास्तविक मूल्य यह है कि डेटा सेट का उपयोग न केवल प्रशिक्षण के लिए किया जा सकता है, बल्कि मॉडल सुधार को मापने के लिए एक स्थिर उपकरण भी बन सकता है। चिकित्सा विशेषज्ञ नमूना साक्ष्य और विवाद रिकॉर्ड देख सकते हैं, एल्गोरिदम टीमें प्रशिक्षण या मूल्यांकन कार्यों में दोषों को मैप कर सकती हैं, और खरीदार यह सत्यापित कर सकते हैं कि डिलीवरी का प्रत्येक बैच स्थापित नियमों को पूरा करता है। पुनर्खरीद करते समय, दोनों पक्ष पिछले बैच के दोष वितरण के आधार पर लेबल निर्देशों और नमूनाकरण रणनीतियों को समायोजित करते हैं, जिससे धीरे-धीरे एक पुन: प्रयोज्य चिकित्सा मूल्यांकन आधार रेखा बनती है।
अक्सर पूछे जाने वाले प्रश्न
डॉक्टर रेटिंग में अंतर है, क्या इसका मतलब यह है कि एनोटेशन अमान्य है? अनिश्चित. असहमति अस्पष्ट नियमों, अपूर्ण डेटा, या कई चिकित्सकीय रूप से उचित विकल्पों के अस्तित्व से उत्पन्न हो सकती है। समझौते को मापा जाना चाहिए, असहमति के कारणों को वर्गीकृत किया जाना चाहिए, और असहमति को सीधे हटाने के बजाय दिशानिर्देश अनुपूरण या विशेषज्ञ मध्यस्थता के माध्यम से नियंत्रित किया जाना चाहिए।
क्या ब्लाइंड टेस्ट में मॉडल की पहचान को पूरी तरह छिपाना पड़ता है? मूल्यांकन के लिए मॉडल आउटपुट की तुलना करना, मॉडल की पहचान छिपाना और ऑर्डर को यादृच्छिक बनाना अक्सर अपेक्षा पूर्वाग्रह को कम करता है। यदि कार्य में स्वयं उपकरण की जानकारी होनी चाहिए, तो इस सीमा को प्रलेखित किया जाना चाहिए और पूर्वाग्रह को कम करने के लिए अन्य साधनों का उपयोग किया जाना चाहिए, जैसे स्वतंत्र समीक्षा, पूर्व निर्धारित संकेतक और अज्ञात प्रस्तुति।
प्रतिनिधि POC नमूने कैसे चुने जाने चाहिए? एनोटेशन परिणामों के अलावा, कार्य परिभाषाएँ, लेबल विनिर्देश, संस्करण रिकॉर्ड, नमूनाकरण और स्थिरता आँकड़े, मध्यस्थता रिकॉर्ड, दोष वर्गीकरण और अनुपालन प्रसंस्करण निर्देश भी वितरित किए जाने चाहिए। केवल तभी परिणामों की समीक्षा की जा सकती है, पुनः प्रशिक्षित किया जा सकता है और बाद के मूल्यांकन के लिए उपयोग किया जा सकता है।
संदर्भ
[1] टैम एट अल। साहित्य समीक्षा से प्राप्त स्वास्थ्य देखभाल में बड़े भाषा मॉडल के मानव मूल्यांकन के लिए एक रूपरेखा। एनपीजे डिजिटल मेडिसिन, 2024. https://doi.org/10.1038/s41746-024-01258-7
[2] रेडियोलॉजी रिपोर्ट निर्माण में चिकित्सकों और दृष्टि-भाषा मॉडल के बीच सहयोग। प्राकृतिक चिकित्सा, 2025. https://www.nature.com/articles/s41591-024-03302-1
[3] रिफ़ एट अल। स्माइल: मल्टीमॉडल मेडिकल इन-संदर्भ सीखने के लिए एक विशेषज्ञ-संचालित बेंचमार्क। NeurIPS 2025 डेटासेट और बेंचमार्क ट्रैक. https://doi.org/10.52202/085713-2180
[4] वासिलिव एट अल। एमटीबीबेंच: ऑन्कोलॉजी में एक मल्टीमॉडल अनुक्रमिक नैदानिक निर्णय लेने वाला बेंचमार्क। NeurIPS 2025 डेटासेट और बेंचमार्क ट्रैक. https://doi.org/10.52202/085713-0368
[5] STARD-AI स्टीयरिंग ग्रुप। कृत्रिम बुद्धिमत्ता का उपयोग करके नैदानिक सटीकता अध्ययन के लिए STARD-AI रिपोर्टिंग दिशानिर्देश। प्राकृतिक चिकित्सा, 2025. https://doi.org/10.1038/s41591-025-03953-8