প্রথমে লেবেলিং অবজেক্ট এবং বিচারের সীমানা নির্ধারণ করুন
"মেডিকেল টীকা" একটি অভিন্ন কাজ নয়। উত্তরগুলি সঠিক কিনা তা নির্ধারণ করা, মেডিকেল রেকর্ড থেকে সত্তা বের করা, চিত্রগুলিতে ক্ষত সনাক্ত করা, প্রতিবেদনগুলি চিত্রের সাথে মেলে কিনা তা নির্ধারণ করা এবং ডাক্তার-রোগীর কথোপকথনগুলিকে উদ্দেশ্য বিভাগে চিহ্নিত করা প্রতিটির জন্য আলাদা লেবেল সংজ্ঞা এবং রেফারেন্স বেস প্রয়োজন৷শুরু করার আগে, কাজটিকে একটি সমস্যায় ভেঙে ফেলা উচিত যা স্বাধীনভাবে বিচার করা যেতে পারে: টীকাকার কী ইনপুট দেখে, কোন লেবেল বা পরিবর্তনগুলি আউটপুট, কোন ডেটার উপর নির্ভর করার অনুমতি দেওয়া হয়, কোন পরিস্থিতিতে অনিশ্চিত হিসাবে চিহ্নিত করা উচিত এবং কীভাবে অনুপস্থিত বা বিপরীত তথ্যের সাথে মোকাবিলা করা যায়। যদি এই সীমানাগুলি স্পষ্টভাবে লেখা না থাকে, তাহলে টীকাকার ব্যক্তিগত অভিজ্ঞতার উপর ভিত্তি করে সংজ্ঞাগুলি পূরণ করবে এবং দলের মধ্যে পার্থক্যগুলি প্রশিক্ষণের লেবেলে মিশ্রিত হবে।
একটি কার্যকর মেডিকেল টীকা নির্দেশিকাতে অন্তত টাস্কের উদ্দেশ্য, অন্তর্ভুক্তি এবং বর্জনের মানদণ্ড, লেবেল সংজ্ঞা, ইতিবাচক এবং নেতিবাচক উদাহরণের নীতি, সীমানা মামলা, প্রমাণ অগ্রাধিকার, অনুপস্থিত মূল্য প্রক্রিয়াকরণ এবং আপগ্রেড করার নিয়মগুলি অন্তর্ভুক্ত থাকতে হবে। গাইডের শুধু লেবেলের নামের তালিকা দেওয়া উচিত নয়, তবে লেবেলগুলি পারস্পরিকভাবে একচেটিয়া কিনা, সেগুলি একাধিক-নির্বাচিত হতে পারে কিনা, লেবেলটি বাক্য বা সম্পূর্ণ মেডিকেল রেকর্ডে প্রযোজ্য কিনা এবং নেতিবাচক এবং ঐতিহাসিক তথ্য কীভাবে পরিচালনা করতে হয় তাও ব্যাখ্যা করা উচিত। মেডিকেল প্রশ্নোত্তরগুলির জন্য, "অসঠিক তথ্য", "অপ্রতুল প্রমাণ", "উত্তর যা প্রশ্নের সমাধান করে না", "অপাঠ্য কাঠামো" এবং "প্রযোজ্য শর্তের অভাবের পরামর্শ" আলাদা করতে হবে; মেডিকেল রেকর্ড নিষ্কাশনের জন্য, এটাও বলা উচিত যে রোগীর প্রধান অভিযোগ, অতীত ইতিহাস, বর্তমান রোগ নির্ণয়, মুলতুবি নির্ণয় এবং পারিবারিক ইতিহাস একটি রোগের সত্তায় মিশ্রিত করা যাবে না।
মেডিকেল পরিস্থিতিতে, টীকাকারের পেশাদার ব্যাকগ্রাউন্ড এবং টাস্ক ম্যাচিংও গুরুত্বপূর্ণ। মেডিকেল টার্মিনোলজি প্রুফরিডিং, নির্দেশিকা প্রমাণ মূল্যায়ন, ক্লিনিকাল সিদ্ধান্ত গ্রহণের সহায়কতা স্কোরিং, এবং চিত্র ক্ষত স্থানীয়করণের মতো কাজগুলি ডিফল্টরূপে একই যোগ্যতা সহ টীকাকারদের দ্বারা সম্পূর্ণ করা উচিত নয়। প্রকল্পটি ডাক্তারদের পেশাদার দিকনির্দেশনা, কাজের বছর বা যোগ্যতার প্রয়োজনীয়তা এবং কাজের মধ্যে সম্পর্ক ব্যাখ্যা করবে, প্রয়োজনীয় প্রশিক্ষণ প্রদান করবে এবং টীকাকাররা যে স্পেসিফিকেশনগুলি বোঝে তা নিশ্চিত করার জন্য টাস্ক অ্যাসেসমেন্ট ব্যবহার করুন। উচ্চ-ঝুঁকির রোগ নির্ণয় বা চিকিত্সার সুপারিশ জড়িত থাকতে পারে এমন সামগ্রীর জন্য, একটি ক্লিনিকাল বিশেষজ্ঞ পর্যালোচনা এবং বিরোধ বাড়ানোর ব্যবস্থা স্থাপন করা উচিত যাতে অ-পেশাদার টীকাকারদের স্বাধীনভাবে চিকিৎসা সুরক্ষা বিচার করার অনুমতি না দেওয়া যায়।
বিষয়গত বিচারকে একাধিক পর্যবেক্ষণযোগ্য মাত্রায় বিভক্ত করুন
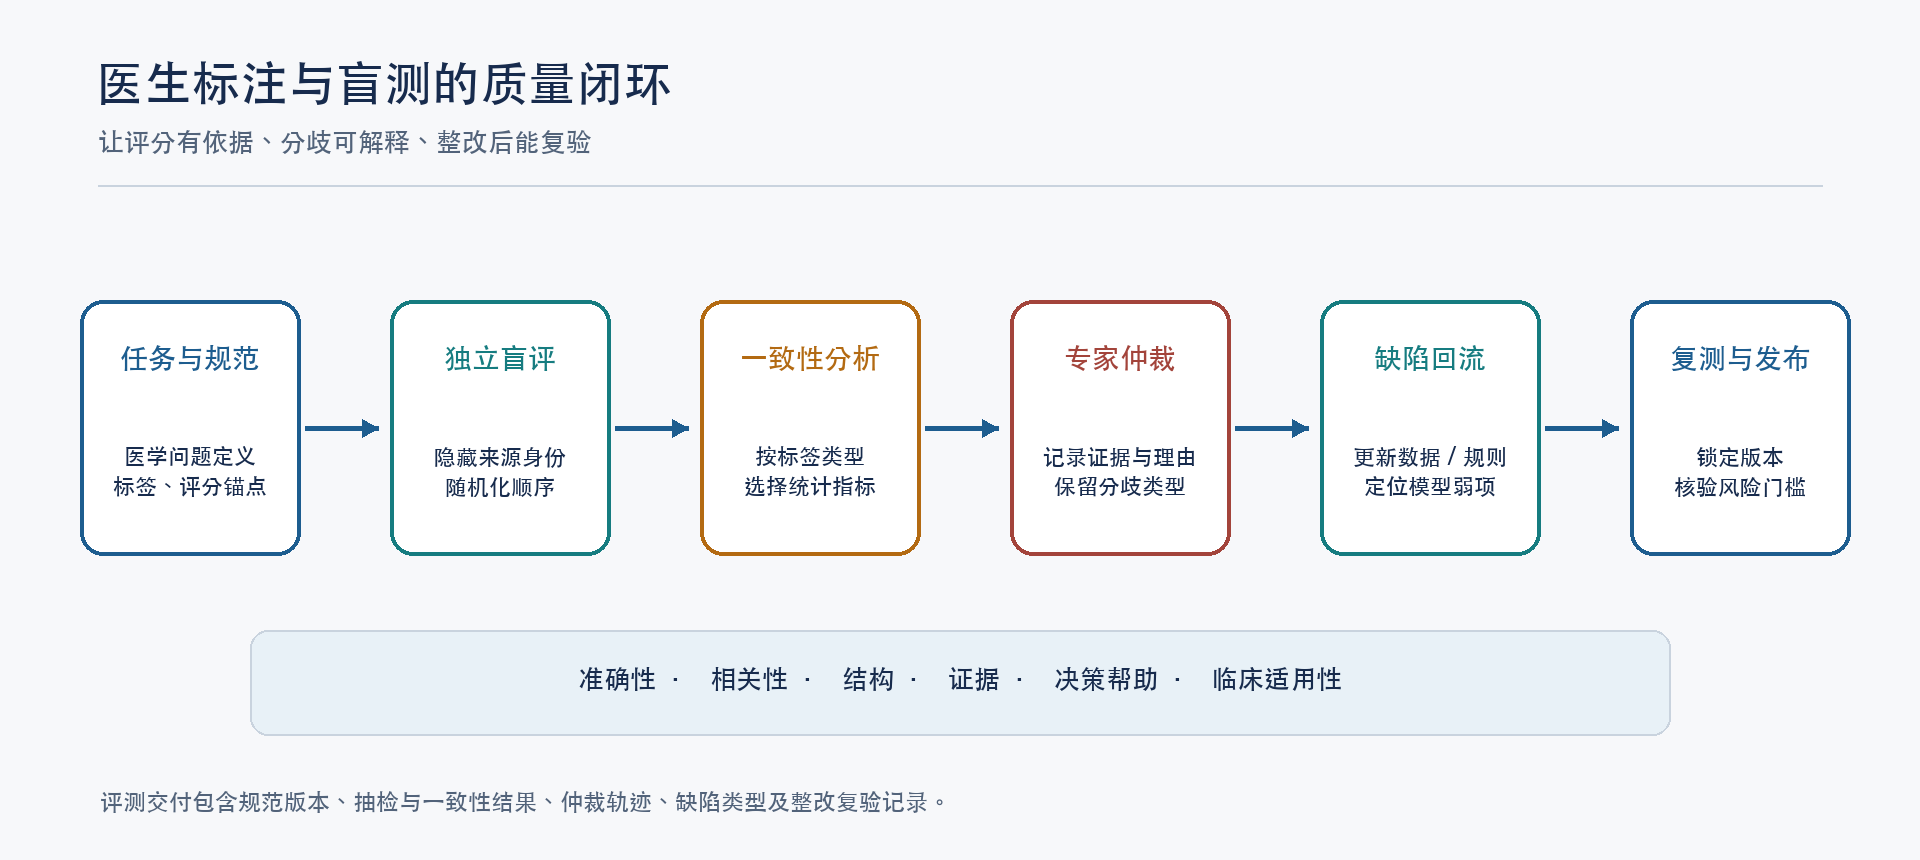
মেডিকেল এআই উত্তরের গুণমান প্রায়ই বহুমাত্রিক হয়। সংযুক্তিতে টীকা প্রক্রিয়াটি পৃথকভাবে উত্তরের নির্ভুলতা, বিষয়বস্তুর প্রাসঙ্গিকতা, কাঠামোগত স্পষ্টতা, প্রমাণ সমর্থন, সিদ্ধান্ত গ্রহণের সহায়কতা এবং ক্লিনিকাল গ্রহণের হারকে স্কোর করে এবং টীকাকারদের প্রয়োজন কাটানোর কারণ ব্যাখ্যা করতে এবং চিকিৎসা যুক্তির উন্নতির জন্য পরামর্শ প্রদান করতে। এই নকশার গুরুত্বপূর্ণ মূল্য রয়েছে: একটি উত্তর বাস্তবসম্মতভাবে সঠিক হতে পারে কিন্তু রোগীর প্রকৃত প্রশ্নের উত্তর দেয় না; এটির একটি সম্পূর্ণ কাঠামো থাকতে পারে তবে প্রমাণের অভাব রয়েছে; অথবা এটি একটি সঠিক উদ্ধৃতি থাকতে পারে কিন্তু একটি মূল contraindication মিস. একটি একক "ভাল/খারাপ" লেবেল ত্রুটিগুলি সনাক্ত করতে মডেল দলগুলিকে সমর্থন করতে পারে না।
প্রতিটি মাত্রার জন্য একটি অ্যাঙ্কর বিবরণ প্রদান করা আবশ্যক। উদাহরণ স্বরূপ, নির্ভুলতা চিকিৎসা বিষয়ক তথ্য সঠিক কিনা এবং মূল বাদ বা দ্বন্দ্ব আছে কিনা তার উপর দৃষ্টি নিবদ্ধ করে; প্রাসঙ্গিকতা উত্তরটি ইনপুট প্রশ্ন এবং রোগীর প্রসঙ্গে সাড়া দেয় কিনা তার উপর ফোকাস করে; প্রমাণ সমর্থন মূল উপসংহার যাচাইযোগ্য উত্স বা যুক্তিসঙ্গত যুক্তি আছে কিনা উপর ফোকাস করে; সিদ্ধান্ত নেওয়ার সহায়তা তথ্য পেশাদারদের বর্তমান কাজটি সম্পূর্ণ করতে সহায়তা করে কিনা তার উপর দৃষ্টি নিবদ্ধ করে; কাঠামোগত স্বচ্ছতা বিষয়বস্তু পড়া এবং পর্যালোচনা করা সহজ কিনা তা ফোকাস করে; ক্লিনিকাল দত্তক-সম্পর্কিত মাত্রা অবশ্যই বিচারের বস্তু এবং প্রমাণকে সীমিত করতে হবে এবং টীকাকারদেরকে "ডাক্তার এটি গ্রহণ করবে কিনা" পাতলা বাতাসের বাইরে অনুমান করার অনুমতি দিতে পারে না। স্কোরিং স্কেলকে সন্নিহিত স্কোরের মধ্যে পার্থক্য ব্যাখ্যা করতে হবে, সেইসাথে কীভাবে সম্পূর্ণ স্কোর, কম স্কোর এবং সিদ্ধান্তহীন স্কোরগুলি পরিচালনা করতে হবে।
আরও গুরুত্বপূর্ণ, স্কোরগুলি অবশ্যই ত্রুটিযুক্ত লেবেল এবং ন্যায্যতা বহন করবে৷ত্রুটির ধরন সেট করার সুপারিশ করা হয় যেমন বাস্তবিক ত্রুটি, বাদ দেওয়া, অতিরিক্ত অনুমান, প্রমাণের অমিল, রোগীর অবস্থার বাদ দেওয়া, অপর্যাপ্ত ঝুঁকি সতর্কতা, কালানুক্রমিক বিভ্রান্তি, অসামঞ্জস্যপূর্ণ গ্রাফিক্স এবং পাঠ্য, বিন্যাস বা পঠনযোগ্যতার সমস্যা ইত্যাদি। প্রতিটি মন্তব্যে সমস্যাটি কোথায় ঘটেছে তা চিহ্নিত করা উচিত, কেন এটি গুরুত্বপূর্ণ তা ব্যাখ্যা করা উচিত এবং যদি সম্ভব হয় উন্নতির জন্য নির্দেশনা দেওয়া। টীকাকাররা কেবল উত্তরগুলি অনুলিপি করতে পারে না, বা তারা বিরাম চিহ্ন এবং বিন্যাসের মতো কম-মূল্যের মতামত দিয়ে চিকিত্সার রায় প্রতিস্থাপন করতে পারে না। ত্রুটি লেবেলগুলি নির্দিষ্ট অংশগুলির সাথে যুক্ত হওয়ার পরে, মডেল প্রশিক্ষণটি পছন্দ জোড়া, সংশোধন নমুনা বা নিরাপদ পরীক্ষার সেট তৈরি করতে ব্যবহার করা যেতে পারে।
রায়ের বিচ্যুতি নিয়ন্ত্রণ করতে ডবল পর্যালোচনা, অন্ধ পরীক্ষা এবং সালিশ ব্যবহার করুন
অন্ধ পরীক্ষার মূল হল মডেল পরিচয়, সরবরাহকারী, সংস্করণ বা প্রত্যাশিত ফলাফল সম্পর্কে টীকাকারদের পূর্ব ধারণাগুলি হ্রাস করা। দুই বা ততোধিক প্রতিক্রিয়া তুলনা করার সময়, উপস্থাপনার ক্রম র্যান্ডমাইজ করা উচিত, উত্স তথ্য লুকানো উচিত, একই প্রশ্ন এবং রোগীর প্রসঙ্গ ব্যবহার করা উচিত, এবং তুলনা করার আগে টীকাকে একই মাত্রায় আলাদাভাবে রেট করা উচিত। যদি AI এবং মানুষের উত্তরগুলি মূল্যায়ন করা হয়, প্রম্পট এবং ডেটা শর্তগুলি যথাসম্ভব সামঞ্জস্যপূর্ণ হওয়া উচিত। শুধু দুটি প্রতিক্রিয়া পাশাপাশি দেখানো, কিন্তু বিচারকদের জানাতে দেওয়া যে কোনটি মডেল থেকে এসেছে, তাকে যথেষ্ট অন্ধত্ব বলা যাবে না।
প্রকল্প ঝুঁকি এবং বাজেটের উপর ভিত্তি করে স্তরীভূত দ্বৈত মান গ্রহণ করতে পারে: সমস্ত উচ্চ-ঝুঁকির প্রশ্ন, কঠিন প্রশ্ন, এবং নিরাপত্তা-সম্পর্কিত প্রশ্ন দুটি যোগ্য পর্যালোচক দ্বারা স্বাধীনভাবে চিহ্নিত করা হবে; ক্রমাগত সামঞ্জস্য নিরীক্ষণের জন্য সাধারণ প্রশ্নের একটি অংশ দ্বিগুণ মানের জন্য নির্বাচন করা হবে; উচ্চ পার্থক্য সহ নমুনাগুলি তৃতীয় পক্ষ বা একজন সিনিয়র ডাক্তার দ্বারা সালিশ করা হবে। প্রতিটি টীকাকারের একটি স্থিতিশীল বেনামী কোড, রেকর্ডিং টাস্ক সংস্করণ, গাইড সংস্করণ, পর্যালোচক, সালিসি উপসংহার এবং পরিবর্তনের কারণ থাকা উচিত। সংখ্যালঘুদের মতামতকে অগ্রাহ্য করার জন্য কেবল সংখ্যাগরিষ্ঠ ভোট ব্যবহার করার পরিবর্তে, সালিশে মতবিরোধের বিভাগগুলি বজায় রাখা উচিত: সংজ্ঞাটি অস্পষ্ট কিনা, প্রমাণের বিরোধপূর্ণ উত্স, অসম্পূর্ণ প্রসঙ্গ, বা বৈধ ক্লিনিকাল পার্থক্য।
সামঞ্জস্য সূচকটি ট্যাগের প্রকারের সাথে মেলে। শ্রেণীবিভাগ লেবেল সুযোগ সংশোধন সূচক ব্যবহার করতে পারে যেমন Cohen’s kappa বা Fleiss’ kappa; অবিচ্ছিন্ন স্কোরিং আন্তঃ-গ্রুপ পারস্পরিক সম্পর্ক সহগ বা পারস্পরিক সম্পর্ক বিশ্লেষণ বিবেচনা করতে পারে, বিচ্যুতি পরিসীমার সাথে মিলিত; সত্তা নিষ্কাশন নির্ভুলতা রিপোর্ট করতে পারে, প্রত্যাহার, F1, এবং সীমানা ম্যাচিং নিয়ম. নমুনা আকার, বিভাগ বন্টন, এবং টীকাকার সংখ্যা সূচকের ব্যাখ্যাকে প্রভাবিত করবে এবং আপনি দাবি করতে পারবেন না যে টীকাটি শুধুমাত্র একটি সামঞ্জস্যপূর্ণ স্কোর পোস্ট করে নির্ভরযোগ্য। কম সামঞ্জস্যতা কখনও কখনও নির্দেশ করে যে টাস্ক সংজ্ঞাটি অস্পষ্ট, কখনও কখনও এটি ইঙ্গিত করে যে কেসটি নিজেই ক্লিনিক্যালি অস্পষ্ট, এবং এটি অপর্যাপ্ত পর্যালোচনা প্রশিক্ষণকেও প্রতিফলিত করতে পারে, এবং নির্দিষ্ট মতবিরোধের নমুনাগুলির বিশ্লেষণ ফিরিয়ে দেওয়া উচিত। ধারাবাহিকতা ব্যাখ্যা করার সময়, মূল ধারাবাহিকতার হার, প্রতিটি ট্যাগের ফ্রিকোয়েন্সি, পর্যালোচকের সংখ্যা, ডবল-স্ট্যান্ডার্ড নমুনা নিষ্কাশন পদ্ধতি এবং আত্মবিশ্বাসের ব্যবধান একই সাথে রিপোর্ট করা উচিত। যখন বিভাগগুলি অত্যন্ত ভারসাম্যহীন হয়, তখন সুযোগ-সংশোধিত মেট্রিকগুলি স্বজ্ঞাত চুক্তির সাথে অসামঞ্জস্যপূর্ণ হতে পারে; অতএব, লেবেলের ধরন এবং অধ্যয়নের উদ্দেশ্যের উপর ভিত্তি করে পরিসংখ্যানগত পদ্ধতিগুলি বেছে নেওয়া উচিত এবং স্তরীভূত ফলাফল এবং মতবিরোধের ক্ষেত্রে সংখ্যাগুলিকে ব্যাখ্যা করা উচিত। যদি নমুনাটি একাধিক বিশেষত্ব বা ঝুঁকি স্তর থেকে নেওয়া হয়, তাহলে সামগ্রিক সূচক একটি উপশ্রেণীর মধ্যে সামঞ্জস্যের অভাবকে মুখোশ করতে পারে এবং মূল উপগোষ্ঠীগুলিকে আলাদাভাবে রিপোর্ট করা উচিত। প্রাথমিক এন্ডপয়েন্ট, সেকেন্ডারি এন্ডপয়েন্ট এবং অ্যানালাইসিস প্ল্যানটি প্রজেক্ট চালু করার আগে আগে থেকে লিখতে হবে যাতে পরবর্তীতে অনুকূল সূচক নির্বাচন করার জন্য জায়গা কমানো যায়। সালিসের পরে চূড়ান্ত লেবেল সালিসের আগে ধারাবাহিকতার ফলাফলকে প্রতিস্থাপন করতে পারে না: পূর্ববর্তীটি চূড়ান্ত বিতরণের বর্ণনা করে এবং পরবর্তীটি প্রতিফলিত করে যে নিয়মগুলি স্বাধীনভাবে এবং স্থিরভাবে প্রয়োগ করা যেতে পারে কিনা।
2024 সালে "npj ডিজিটাল মেডিসিন"-এ প্রকাশিত মেডিকেল LLM ম্যানুয়াল মূল্যায়ন কাঠামো মূল্যায়ন প্রক্রিয়াকে পরিকল্পনা, নির্বাহ এবং সালিশ, স্কোরিং এবং পর্যালোচনার মতো ধাপে বিভক্ত করে এবং জোর দেয় যে লক্ষ্য, পর্যালোচক, নমুনা নির্বাচন, মূল্যায়নের জন্য অগ্রিম নকশাগত সূচক এবং পরিসংখ্যানগত পদ্ধতির প্রয়োজন।[1] রেডিওলজিতে ভিজ্যুয়াল ল্যাঙ্গুয়েজ মডেলের আরেকটি অধ্যয়ন একটি অন্ধ পছন্দ তুলনা এবং ত্রুটি সংশোধন কাজ নিযুক্ত করেছে এবং পর্যালোচকদের মধ্যে উল্লেখযোগ্য মতবিরোধের প্রতিবেদন করেছে, পরামর্শ দিয়েছে যে বিশেষজ্ঞের মতামত স্বয়ংক্রিয়ভাবে একটি একক সত্য মান গঠন করে না।[2] অতএব, টীকা প্রকল্পের লক্ষ্য মতবিরোধকে ঢেকে রাখা নয়, বরং সেগুলিকে পরিমাপযোগ্য, সন্ধানযোগ্য এবং সমাধানযোগ্য করে তোলা।
মূল্যায়ন সেট ডেটা ফাঁস এবং প্রশ্ন দূষণ প্রতিরোধ করবে
ক্লিনিকাল এআই মূল্যায়ন সেটগুলিকে প্রশিক্ষণ এবং বিকাশের আগে পরিচালনার সীমানা নির্ধারণ করা উচিত। রোগীর স্তরের নমুনা প্রশিক্ষণ এবং পরীক্ষার মধ্যে পুনরাবৃত্তি করা যাবে না; একই মেডিকেল রেকর্ডের আনুমানিক পুনর্লিখন, একই চিত্রের বিভিন্ন স্লাইস বা একই কথোপকথনের বিভক্ত অংশ থেকেও ফাঁস হতে পারে। অনুদৈর্ঘ্য ডেটার জন্য, ভবিষ্যতের তথ্য বর্তমান প্রশ্ন ইনপুটে প্রবেশ করে কিনা তা পরীক্ষা করাও প্রয়োজন; মেডিকেল জ্ঞান প্রশ্নোত্তরের জন্য, মডেল ট্রেনিং কর্পাস দ্বারা জনসাধারণের প্রশ্নের শোষিত হওয়ার সম্ভাবনা পর্যবেক্ষণ করা উচিত। মূল্যায়নের দায়িত্বে থাকা ব্যক্তিকে অ্যাক্সেসের অধিকার, সংস্করণ, নিষ্কাশন রেকর্ড এবং প্রশ্ন এক্সপোজার পরিচালনা করতে হবে। বড় পরিমার্জন করার পর, তার সিদ্ধান্ত নেওয়া উচিত যে আসল টেস্ট সেট ব্যবহার করা চালিয়ে যাবেন কিনা।
সাম্প্রতিক বছরগুলিতে, মাল্টিমোডাল মেডিকেল বেঞ্চমার্কগুলি একক রাউন্ড প্রশ্ন এবং উত্তর থেকে বাস্তব টাস্ক কাঠামোতে স্থানান্তরিত হতে শুরু করেছে। NeurIPS 2025 এর SMMILE হল একটি মাল্টি-মডেল প্রাসঙ্গিক শিক্ষার মূল্যায়ন যা চিকিৎসা বিশেষজ্ঞদের দ্বারা নির্মিত। সমীক্ষায় দেখা গেছে যে ওপেন মাল্টি-মোডাল টাস্কে বেশিরভাগ পরীক্ষিত মডেলের ক্ষমতা এখনও সীমিত, এবং অপ্রাসঙ্গিক উদাহরণগুলি কর্মক্ষমতা কমিয়ে দিতে পারে।[3] একই সেশনের MTBBench মাল্টি-মডেল এবং অনুদৈর্ঘ্য টিউমার সিদ্ধান্ত গ্রহণের সমস্যাগুলির উপর দৃষ্টি নিবদ্ধ করে, নির্দেশ করে যে মডেলটি এখনও সময়ের পরিবর্তন, বিরোধপূর্ণ প্রমাণ এবং ক্রস-মডেল তথ্যের সাথে মোকাবিলা করার সময় অবিশ্বস্ত কর্মক্ষমতা প্রদর্শন করে।[4] এই অধ্যয়নগুলি একটি ব্যবহারিক রায়কে সমর্থন করে: মূল্যায়নের প্রশ্নগুলি অবশ্যই যথেষ্ট ক্লিনিকাল প্রেক্ষাপট বজায় রাখতে হবে এবং দ্বন্দ্ব, মুছে ফেলা এবং সময়ের পরিবর্তনগুলি পরিচালনা করার জন্য মডেলের ক্ষমতা পদ্ধতিগতভাবে পরীক্ষা করতে হবে এবং ক্লিনিকাল ক্ষমতাগুলি শুধুমাত্র সংক্ষিপ্ত প্রশ্ন এবং বহু-পছন্দের প্রশ্নের দ্বারা অনুমান করা যায় না।
পরীক্ষার সেট টাস্ক কভারেজ এবং অসুবিধাও সংজ্ঞায়িত করে। এটি সাধারণ সমস্যা, বিরল পরিস্থিতি, গুরুতর এবং গুরুতর ঝুঁকি, বিশেষ গোষ্ঠী, অসম্পূর্ণ তথ্য, প্রমাণ দ্বন্দ্ব, ক্রস-মডেল পারস্পরিক সম্পর্ক এবং স্তরগুলিতে দীর্ঘমেয়াদী পরিবর্তনগুলি কভার করতে পারে। প্রতিটি স্তরের জন্য নমুনা এবং উত্স বিতরণের সংখ্যা রিপোর্ট করা হয়। গড় স্কোর ছাড়াও, উচ্চ-ঝুঁকির ত্রুটির হার, সমালোচনামূলক ত্রুটি প্রত্যাহার হার, উপগোষ্ঠী কর্মক্ষমতা, আত্মবিশ্বাসের ব্যবধান এবং মডেল আউটপুটগুলিতে অনিশ্চয়তাও পরীক্ষা করা উচিত।"জানি না" বা "অপর্যাপ্ত তথ্য" পরিস্থিতিগুলির জন্য, উত্তর দিতে উপযুক্ত প্রত্যাখ্যান বা অতিরিক্ত তথ্যের জন্য অনুরোধ অবশ্যই মূল্যায়নযোগ্য আচরণ হিসাবে বিবেচিত হবে এবং প্রতিটি প্রশ্নকে একটি মেডিকেল উপসংহারে ম্যাপ করতে বাধ্য করা যাবে না।
টীকা প্রক্রিয়াটির জন্য পর্যালোচকদের ড্রিফট পরিচালনা করতে হবে
বিশেষজ্ঞরা প্রকল্পের অগ্রগতির সাথে সাথে বিচারের স্কেলও পরিবর্তন করবেন। দীর্ঘ প্রকল্পে, নির্দেশিকা আপডেট, কর্মীদের টার্নওভার, ক্লান্তি, বা সাধারণ ত্রুটির পুনরাবৃত্তি একই লেবেলের অর্থ মাসে মাসে প্রবাহিত হতে পারে। অ্যাঙ্কর প্রশ্নগুলির একটি সেট যা আগে থেকে অবহিত করা হয়নি তা ধরে রাখা যেতে পারে এবং পুরানো এবং নতুন পর্যালোচনাগুলির সামঞ্জস্যের তুলনা করার জন্য পর্যায়ক্রমে টীকা কাজগুলি সন্নিবেশ করা যেতে পারে; নোটেটর যারা নিয়ম থেকে বিচ্যুত হতে থাকে তাদের পুনরায় প্রশিক্ষণ দেওয়া যেতে পারে এবং তাদের সাম্প্রতিক ফলাফল পর্যালোচনা করা যেতে পারে। বিচারের নীতিগুলি বোঝার পরিবর্তে পর্যালোচকদের উত্তর মুখস্ত করা থেকে বিরত রাখতে অ্যাঙ্কর প্রশ্নগুলিও নিয়মিত আপডেট করা উচিত। প্রতিটি নির্দেশিকা পরিবর্তনের জন্য প্রভাবের সুযোগ রেকর্ড করা উচিত, এবং এটি নির্ধারণ করা উচিত যে পুরানো ব্যাচগুলি পুনরায় লেবেল করা বা শুধুমাত্র সংস্করণ করা দরকার।
মেডিকেল টীকাগুলির ডেটা অডিটিং নমুনা এবং পর্যালোচক উভয়ের উপর ফোকাস করা উচিত। নমুনা দিকটি উৎস, সংবেদনশীলতার অবস্থা, প্রসঙ্গ অখণ্ডতা, টাস্ক সংস্করণ এবং প্রমাণের অবস্থান রেকর্ড করে; কর্মীদের পক্ষ শুধুমাত্র বেনামী কোডিং, যোগ্যতার ধরন, প্রশিক্ষণের অবস্থা এবং গুণমানের অডিট সম্পূর্ণ করার জন্য প্রয়োজনীয় ফলাফল পর্যালোচনা করে রাখে। মূল্যায়নকারীদের উচিত রোগীর তথ্যের অপ্রয়োজনীয় এক্সপোজার কমানো, টাস্ক ইন্টারফেসে রায় সম্পূর্ণ করার জন্য প্রয়োজনীয় বিষয়বস্তু উপস্থাপন করা এবং এক্সপোর্ট, ডাউনলোড এবং অ্যাক্সেসের অনুমতি নিয়ন্ত্রণ করা। যদি নমুনায় বক্তৃতা, ছবি বা বিনামূল্যের পাঠ্য জড়িত থাকে, সরাসরি সনাক্তকরণের তথ্য এবং সম্মিলিত শনাক্তকরণ ক্লুগুলি শুধুমাত্র নামের ক্ষেত্রে অনুসন্ধান না করে সংবেদনশীলতা পরীক্ষায় অন্তর্ভুক্ত করা উচিত।
এছাড়াও "সঠিক উত্তর" এবং "নিরাপদ উত্তর" এর মধ্যে পার্থক্য করুন। মডেল প্রযোজ্য শর্ত, contraindications, বা জরুরী চিকিৎসা পরামর্শ নির্দিষ্ট না করে বাস্তবসম্মতভাবে সঠিক বিষয়বস্তু দিতে পারে; এটি ঝুঁকিপূর্ণ এবং ভুল পরামর্শও দিতে পারে, তবে পাঠ্যটি খুব সাবলীল। নিরাপত্তা টীকাগুলির জন্য স্বাধীন তীব্রতা স্তরবিন্যাস এবং স্পষ্ট ক্ষতির পথ, ত্রুটি আবিষ্কারযোগ্যতা, এবং বাস্তব ব্যবহারের পরিস্থিতিগুলির আশেপাশে ম্যানুয়াল ইন্টারসেপশন ক্ষমতা প্রয়োজন। যে পরিস্থিতিতে রোগ নির্ণয় এবং চিকিৎসায় বিলম্ব হতে পারে বা অনুপযুক্ত চিকিৎসার কারণ হতে পারে, সেই অবস্থার সীমারেখায় পৌঁছানো গড় নির্ভুলতার উপর ভিত্তি করে করা যাবে না। একটি পৃথক ব্যর্থতা থ্রেশহোল্ড এবং বৃদ্ধি কর্ম সেট করা উচিত।
অন্ধ পরীক্ষার ফলাফলকে এক্সিকিউটেবল কোয়ালিটি ক্লোজড লুপে পরিণত করুন
একটি অন্ধ পরীক্ষা প্রকল্পের শেষ নয়। ফলাফলগুলি ডেটা, স্পেসিফিকেশন, মডেল এবং পণ্য প্রক্রিয়াগুলিতে ফেরত দিতে হবে: যদি ত্রুটিটি অনুপস্থিত ক্ষেত্রগুলি থেকে আসে তবে ডেটা অভিধান বা ইনপুট তথ্য সম্পূর্ণ করুন; যদি ত্রুটি চিকিৎসা ধারণা বিভ্রান্তি থেকে আসে, লেবেলিং সিস্টেম সংশোধন করুন এবং নিয়ন্ত্রণ নমুনা যোগ করুন; যদি ত্রুটি প্রমাণের উদ্ধৃতি থেকে আসে, অনুসন্ধান উত্স এবং রেফারেন্স চিঠিপত্র পরীক্ষা করুন; যদি ত্রুটিটি মাল্টি-মডেল অমিল থেকে আসে, ফাইল ম্যাপিং এবং রোগীর সমিতি পর্যালোচনা করুন; যদি বিভিন্ন বিশেষজ্ঞরা একমত না হন, সীমানা সংজ্ঞার পরিপূরক বা পরিস্থিতিটিকে ক্লিনিকাল রায়ের প্রয়োজন হিসাবে চিহ্নিত করেন। অপ্টিমাইজেশানের প্রতিটি রাউন্ডে টাস্ক সংস্করণ, নমুনা সংস্করণ, মডেল সংস্করণ, পর্যালোচনা শর্ত এবং ফলাফলের পার্থক্যগুলিকে একটি অগ্রগতি বক্ররেখায় অতুলনীয় স্কোরগুলিকে সরাসরি বিভক্ত করা এড়াতে হবে।
প্রকল্প ব্যবস্থাপনা তিনটি পর্যায় সেট করতে পারে: স্টার্টআপ থ্রেশহোল্ড, প্রক্রিয়ার গুণমান এবং ডেলিভারি গ্রহণযোগ্যতা। স্টার্টআপ থ্রেশহোল্ড পরীক্ষা করে যে গাইডটি ট্রায়াল বিড পাস করেছে কিনা, চিকিৎসা বিশেষজ্ঞরা নিয়মগুলি নিশ্চিত করেছেন কিনা এবং মূল্যায়নের নমুনাগুলি স্বাধীনভাবে রাখা হয়েছে কিনা; প্রক্রিয়া গুণমান নমুনা ত্রুটি হার, টীকা ড্রিফট এবং সালিসি অনুপাত নিরীক্ষণ করে; ডেলিভারি গ্রহণযোগ্যতা ক্ষেত্রগুলির সম্পূর্ণতা, চিকিৎসা নির্ভুলতা, প্রমাণ ট্রেসেবিলিটি, গোপনীয়তা সম্মতি এবং ফাইল সংস্করণগুলি পরীক্ষা করে। ত্রুটি শ্রেণীবিভাগের জন্য বিভিন্ন তীব্রতা স্তর সেট করুন: প্রধান ডায়গনিস্টিক ত্রুটি বা গোপনীয়তা ফাঁস জড়িত ত্রুটিগুলি সাসপেনশন এবং ব্যাপক তদন্ত ট্রিগার করা উচিত; সাধারণ বিন্যাসের ত্রুটিগুলি মেরামত করার জন্য নির্দেশিত হতে পারে। সেটেলমেন্ট এবং পুনঃক্রয় শর্তাদি অবশ্যই নিয়ম সংস্করণের সাথে সামঞ্জস্যপূর্ণ হতে হবে যাতে বিভিন্ন ব্যাচের জন্য বিভিন্ন স্কোরিং ক্যালিবার ব্যবহার না করা যায়।
মেডিকেল লেবেলিং উচ্চ মানের প্রমাণ হিসাবে "অনেক মতামত" ব্যবহার করা উচিত নয়। উচ্চ-মানের টীকা মডেল দলকে বলতে পারে: যেখানে উত্তরটি ভুল, কেন ত্রুটিটি গুরুত্বপূর্ণ, প্রমাণটি কোন প্রেক্ষাপট থেকে এসেছে, ডাক্তারদের মধ্যে যুক্তিসঙ্গত মতবিরোধ আছে কিনা এবং প্রশিক্ষণ বা পণ্য পরিবর্তনের পরবর্তী রাউন্ডে এটি কীভাবে যাচাই করা যায়। ক্লিনিকাল অ্যাপ্লিকেশানগুলির জন্য, এটিও স্পষ্ট করা আবশ্যক যে AI আউটপুট হল সহায়ক তথ্য, যা প্রকৃত রোগীর পরিস্থিতি, সর্বশেষ প্রমাণ এবং প্রাতিষ্ঠানিক প্রক্রিয়াগুলির উপর ভিত্তি করে পেশাদারদের দ্বারা পর্যালোচনা করা প্রয়োজন। টীকা পর্যালোচনাগুলি সিস্টেমের সীমানা আবিষ্কার করতে সাহায্য করতে পারে কিন্তু ক্লিনিকাল জবাবদিহিতা বা বাস্তব-বিশ্ব নিরাপত্তা মূল্যায়নের বিকল্প নয়।
ল্যাংগুইয়ের মেডিকেল লেবেলিং ক্ষমতাগুলি ট্রেসেবিলিটি প্রক্রিয়ায় প্রতিফলিত হওয়া উচিত
বাইরের বিশ্বের সাথে Langhui-এর মেডিকেল ডেটা পরিষেবাগুলিকে পরিচয় করিয়ে দেয় এবং শুধুমাত্র আউটপুটকে জোর দেওয়ার পরিবর্তে লেবেলিং স্পেসিফিকেশন ডিজাইন, চিকিৎসা বিশেষজ্ঞের সহযোগিতা, অন্ধ মূল্যায়ন, গুণমানের সালিসি এবং ত্রুটি বন্ধ লুপের উপর ফোকাস করার সুপারিশ করে। প্রকল্পটি বাস্তবায়ন করার সময়, গ্রাহকের লক্ষ্যগুলি প্রথমে টাস্ক বর্ণনা এবং স্কোরিং স্ট্যান্ডার্ডে রূপান্তরিত হয়, এবং তারপর বিভিন্ন পর্যালোচনার বোঝার পরীক্ষা মানগুলির ছোট ব্যাচের মাধ্যমে ক্রমাঙ্কিত হয়; আনুষ্ঠানিক কাজে প্রবেশ করার পরে, উচ্চ-ঝুঁকির নমুনার জন্য পর্যালোচনা সেট আপ করা হয়, এবং পর্যালোচনা মতবিরোধের কারণ এবং সালিসি ট্র্যাকগুলি বজায় রাখা হয়; সংস্করণ, র্যান্ডম পরিদর্শন পরিসংখ্যান, এবং সমস্যা মেরামতের রেকর্ড বিতরণের সময় প্রদান করা হয়। নির্দিষ্ট চিহ্নিতকরণের ধরন, বিশেষজ্ঞের যোগ্যতা, নমুনা অনুপাত এবং গ্রহণযোগ্যতা প্রতিশ্রুতি প্রকল্পের সুযোগ এবং চুক্তি চুক্তির সাপেক্ষে।
মেডিকেল এআই দলের কাছে এই ক্ষমতার প্রকৃত মূল্য হল যে ডেটা সেটটি শুধুমাত্র প্রশিক্ষণের জন্যই ব্যবহার করা যাবে না, মডেলের উন্নতি পরিমাপের জন্য একটি স্থিতিশীল হাতিয়ারও হয়ে উঠবে। চিকিৎসা বিশেষজ্ঞরা নমুনা প্রমাণ এবং বিরোধের রেকর্ড দেখতে পারেন, অ্যালগরিদম দলগুলি প্রশিক্ষণ বা মূল্যায়নের কাজগুলিতে ত্রুটিগুলি ম্যাপ করতে পারে এবং ক্রেতারা যাচাই করতে পারে যে ডেলিভারির প্রতিটি ব্যাচ প্রতিষ্ঠিত নিয়মগুলি পূরণ করে। পুনঃক্রয় করার সময়, উভয় পক্ষই পূর্ববর্তী ব্যাচের ত্রুটি বিতরণের উপর ভিত্তি করে লেবেল নির্দেশাবলী এবং নমুনা কৌশলগুলি সামঞ্জস্য করে, ধীরে ধীরে একটি পুনর্ব্যবহারযোগ্য চিকিৎসা মূল্যায়ন বেসলাইন তৈরি করে।
FAQ
ডাক্তারের রেটিংয়ে পার্থক্য আছে, তার মানে কি টীকাটি অবৈধ? অনিশ্চিত অস্পষ্ট নিয়ম, অসম্পূর্ণ ডেটা, বা একাধিক ক্লিনিক্যালি যুক্তিসঙ্গত বিকল্পের অস্তিত্ব থেকে মতবিরোধ দেখা দিতে পারে। চুক্তিটি পরিমাপ করা উচিত, মতবিরোধের কারণগুলিকে শ্রেণীবদ্ধ করা উচিত, এবং সরাসরি মতানৈক্যগুলি মুছে ফেলার পরিবর্তে নির্দেশিকা পরিপূরক বা বিশেষজ্ঞ সালিশের মাধ্যমে পরিচালনা করা উচিত।
অন্ধ পরীক্ষা কি সম্পূর্ণরূপে মডেলের পরিচয় গোপন করতে হবে? মডেল আউটপুটগুলির তুলনামূলক মূল্যায়নের জন্য, মডেলের পরিচয় লুকিয়ে রাখা এবং অর্ডারটি র্যান্ডমাইজ করা প্রায়শই প্রত্যাশার পক্ষপাত কমিয়ে দেয়। যদি কাজটি নিজেই টুলের তথ্য জানতে পারে, তাহলে এই সীমাবদ্ধতাটি নথিভুক্ত করা উচিত এবং পক্ষপাত কমাতে অন্যান্য উপায়গুলি ব্যবহার করা উচিত, যেমন স্বাধীন পর্যালোচনা, প্রিসেট সূচক এবং বেনামী উপস্থাপনা।
প্রতিনিধিত্বমূলক POC নমুনা কীভাবে নির্বাচন করা উচিত? টীকা ফলাফল ছাড়াও, টাস্ক সংজ্ঞা, লেবেল স্পেসিফিকেশন, সংস্করণ রেকর্ড, নমুনা এবং সামঞ্জস্যপূর্ণ পরিসংখ্যান, সালিসি রেকর্ড, ত্রুটি শ্রেণীবিভাগ এবং সম্মতি প্রক্রিয়াকরণ নির্দেশাবলী প্রদান করা উচিত। শুধুমাত্র তারপর ফলাফল পর্যালোচনা করা যেতে পারে, পুনরায় প্রশিক্ষিত, এবং পরবর্তী মূল্যায়নের জন্য ব্যবহার করা হয়.
রেফারেন্স
[1] Tam et al. সাহিত্য পর্যালোচনা থেকে প্রাপ্ত স্বাস্থ্যসেবায় বৃহৎ ভাষার মডেলের মানব মূল্যায়নের জন্য একটি কাঠামো। npj ডিজিটাল মেডিসিন, 2024. https://doi.org/10.1038/s41746-024-01258-7
[2] রেডিওলজি রিপোর্ট তৈরিতে চিকিত্সক এবং দৃষ্টি-ভাষা মডেলের মধ্যে সহযোগিতা। প্রকৃতির ঔষধ, 2025. https://www.nature.com/articles/s41591-024-03302-1
[3] রিফ এট আল। SMMILE: মাল্টিমোডাল মেডিকেল ইন-প্রসঙ্গ শিক্ষার জন্য একটি বিশেষজ্ঞ-চালিত বেঞ্চমার্ক। NeurIPS 2025 ডেটাসেট এবং বেঞ্চমার্ক ট্র্যাক. https://doi.org/10.52202/085713-2180
[4] ভাসিলেভ এট আল। MTBBench: অনকোলজিতে একটি মাল্টিমোডাল সিকোয়েন্সিয়াল ক্লিনিকাল ডিসিশন মেকিং বেঞ্চমার্ক। NeurIPS 2025 ডেটাসেট এবং বেঞ্চমার্ক ট্র্যাক. https://doi.org/10.52202/085713-0368
[5] STARD-AI স্টিয়ারিং গ্রুপ। কৃত্রিম বুদ্ধিমত্তা ব্যবহার করে ডায়াগনস্টিক নির্ভুলতা অধ্যয়নের জন্য STARD-AI রিপোর্টিং নির্দেশিকা। প্রকৃতির ঔষধ, 2025. https://doi.org/10.1038/s41591-025-03953-8