Primeiro defina o objeto de rotulagem e o limite de julgamento
“Anotação médica” não é uma tarefa uniforme. Determinar se as respostas são precisas, extrair entidades de registros médicos, identificar lesões em imagens, determinar se os relatórios correspondem às imagens e marcar as conversas médico-paciente em categorias de intenção exigem diferentes definições de rótulos e bases de referência. Antes de começar, a tarefa deve ser dividida em um problema que possa ser julgado de forma independente: quais entradas o anotador vê, quais rótulos ou modificações são produzidas, quais dados podem ser considerados confiáveis, quais situações devem ser marcadas como incertas e como lidar com informações faltantes ou contraditórias. Se esses limites não estiverem claramente escritos, o anotador preencherá as definições com base na experiência pessoal e as diferenças entre as equipes serão misturadas nos rótulos de treinamento.
Um guia de anotação médica eficaz deve incluir pelo menos o propósito da tarefa, critérios de inclusão e exclusão, definição de rótulo, princípios de exemplos positivos e negativos, casos limite, prioridade de evidências, processamento de valores faltantes e regras de atualização. O guia não deve apenas fornecer uma lista de nomes de rótulos, mas também explicar se os rótulos são mutuamente exclusivos, se podem ser selecionados múltiplas, se o rótulo se aplica a sentenças ou a todo o prontuário médico, e como lidar com informações negativas e históricas. Para perguntas e respostas médicas, devem ser distinguidos “fatos imprecisos”, “evidências insuficientes”, “respostas que não abordam a questão”, “estrutura ilegível” e “sugestões sem condições aplicáveis”; para a extração de prontuários, deve-se afirmar também que a queixa principal do paciente, a história pregressa, o diagnóstico atual, os diagnósticos pendentes e a história familiar não podem ser misturados em uma única entidade patológica.
Em cenários médicos, a experiência profissional do anotador e a correspondência de tarefas também são importantes. Tarefas como revisão de terminologia médica, avaliação de evidências de diretrizes, pontuação de utilidade para tomada de decisão clínica e localização de lesões de imagem não devem ser realizadas por anotadores com as mesmas qualificações por padrão. O projecto deve explicar a relação entre a orientação profissional dos médicos, os anos de trabalho ou os requisitos de qualificação e as tarefas, fornecer a formação necessária e utilizar a avaliação das tarefas para confirmar que os anotadores compreendem as especificações. Para conteúdos que possam envolver diagnósticos de alto risco ou recomendações de tratamento, deve ser criado um mecanismo de revisão de peritos clínicos e de escalonamento de disputas para evitar permitir que anotadores não profissionais julguem de forma independente a segurança médica.
Divida o julgamento subjetivo em múltiplas dimensões observáveis
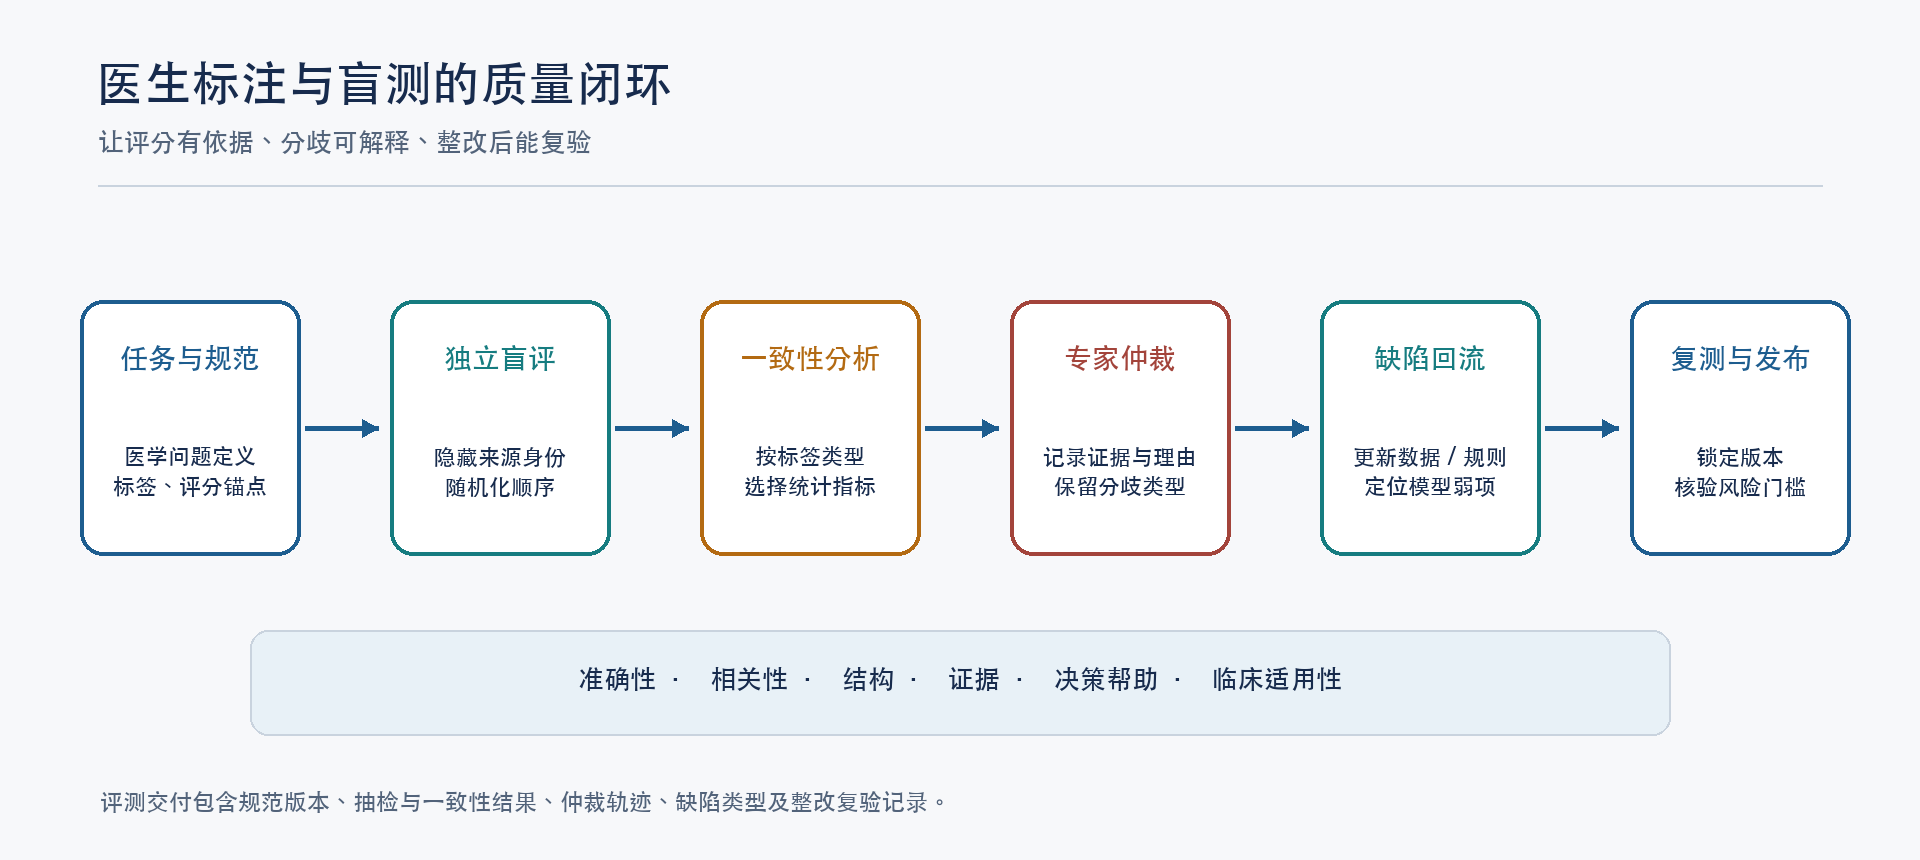
A qualidade das respostas médicas de IA costuma ser multidimensional. O processo de anotação no anexo pontua separadamente a precisão das respostas, relevância do conteúdo, clareza estrutural, suporte de evidências, utilidade na tomada de decisões e taxa de adoção clínica, e exige que os anotadores expliquem os motivos das deduções e forneçam sugestões para melhorar a lógica médica. Este desenho tem um valor importante: uma resposta pode ser factualmente correta, mas não responder à pergunta real do paciente; pode ter uma estrutura completa mas carecer de evidências; ou pode ter uma citação correta, mas perder uma contraindicação importante. Um único rótulo “bom/ruim” não pode ajudar as equipes modelo na localização de defeitos.
Uma descrição da âncora deve ser fornecida para cada dimensão. Por exemplo, a precisão centra-se em saber se os factos médicos estão corretos e se existem omissões ou contradições importantes; a relevância concentra-se em saber se a resposta responde à pergunta de entrada e ao contexto do paciente; o suporte de evidências centra-se em saber se as principais conclusões têm fontes verificáveis ou fundamentação razoável; a assistência na tomada de decisões concentra-se em saber se a informação ajuda os profissionais a completar a tarefa atual; a clareza estrutural concentra-se em saber se o conteúdo é fácil de ler e revisar; as dimensões relacionadas à adoção clínica devem limitar os objetos de julgamento e as evidências, e não podem permitir que os anotadores especulem do nada "se o médico irá adotá-la". A escala de pontuação precisa explicar a diferença entre pontuações adjacentes, bem como como lidar com pontuações completas, pontuações baixas e pontuações indecidíveis.
Mais importante ainda, as pontuações devem conter rótulos e justificativas de defeitos. Recomenda-se definir tipos de erros, como erros factuais, omissões, inferência excessiva, incompatibilidade de evidências, omissão de condições do paciente, aviso de risco insuficiente, confusão cronológica, gráficos e textos inconsistentes, problemas de formatação ou legibilidade, etc. Os anotadores não podem simplesmente copiar as respostas, nem podem substituir o julgamento médico por opiniões de baixo valor, como pontuação e formatação. Depois que os rótulos de erro são associados a segmentos específicos, o treinamento do modelo pode ser usado para construir pares de preferências, amostras de correção ou conjuntos de testes seguros.
Use revisão dupla, teste cego e arbitragem para controlar desvios de julgamento
O núcleo do teste cego é reduzir os preconceitos dos anotadores sobre a identidade do modelo, fornecedor, versão ou resultados esperados. Ao comparar duas ou mais respostas, a ordem de apresentação deve ser aleatória, a informação de origem deve ser ocultada, a mesma pergunta e o contexto do paciente devem ser usados, e os anotadores devem ser classificados separadamente nas mesmas dimensões antes da comparação. Se a IA e as respostas humanas estiverem sendo avaliadas, os prompts e as condições dos dados devem ser tão consistentes quanto possível. Apenas mostrar duas respostas lado a lado, mas deixar os juízes saberem qual delas vem do modelo, não pode ser considerado cegueira suficiente. O projeto
pode adotar padrões duplos estratificados com base no risco e no orçamento: todas as questões de alto risco, questões difíceis e questões relacionadas à segurança serão avaliadas de forma independente por dois revisores qualificados; uma parte das perguntas comuns será selecionada para padrões duplos para monitorar continuamente a consistência; amostras com grandes diferenças serão arbitradas por terceiros ou por um médico sênior. Cada anotador deve ter um código anônimo estável, registrando a versão da tarefa, a versão do guia, o revisor, a conclusão da arbitragem e o motivo da alteração. Em vez de simplesmente utilizar o voto da maioria para anular uma opinião minoritária, a arbitragem deve reter categorias de desacordo: se a definição não é clara, fontes de evidência conflitantes, contexto incompleto ou diferenças clínicas legítimas.
O índice de consistência deve corresponder ao tipo de tag. Os rótulos de classificação podem usar indicadores de correção de acaso, como o kappa de Cohen ou o kappa de Fleiss; a pontuação contínua pode considerar coeficientes de correlação intragrupo ou análise de correlação, combinada com faixas de divergência; a extração de entidade pode relatar regras de precisão, recall, F1 e correspondência de limites. O tamanho da amostra, a distribuição das categorias e o número de anotadores afetarão a interpretação do índice, e você não pode afirmar que a anotação é confiável apenas postando uma pontuação de consistência. A baixa consistência às vezes indica que a definição da tarefa é vaga, às vezes indica que o caso em si é clinicamente ambíguo e também pode refletir treinamento de revisão insuficiente, e a análise de amostras específicas de discordância deve ser devolvida. Ao interpretar a consistência, a taxa de consistência original, a frequência de cada tag, o número de revisores, o método de extração de amostra de padrão duplo e o intervalo de confiança também devem ser relatados simultaneamente. Quando as categorias são extremamente desequilibradas, as métricas corrigidas pelo acaso podem ser inconsistentes com a concordância intuitiva; portanto, os métodos estatísticos devem ser escolhidos com base no tipo de rótulo e no objetivo do estudo, e os números devem ser interpretados usando resultados estratificados e casos de discordância. Se a amostra for retirada de múltiplas especialidades ou estratos de risco, o índice global pode mascarar uma falta de consistência dentro de uma subcategoria, e os principais subgrupos devem ser reportados separadamente. O parâmetro de avaliação primário, o parâmetro de avaliação secundário e o plano de análise devem ser escritos antecipadamente antes do lançamento do projeto, para reduzir o espaço para a seleção posterior de indicadores favoráveis. O rótulo final após a arbitragem não pode substituir o resultado de consistência antes da arbitragem: o primeiro descreve a entrega final, e o último reflete se as regras podem ser implementadas de forma independente e estável.
A estrutura de avaliação do manual médico LLM publicada em "npj Digital Medicine" em 2024 divide o processo de avaliação em etapas como planejamento, execução e arbitragem, pontuação e revisão, e enfatiza que metas, revisores, seleção de amostras, indicadores de avaliação e métodos estatísticos precisam ser projetados com antecedência.[1] Outro estudo de modelos de linguagem visual em radiologia empregou uma comparação cega de preferências e tarefa de revisão de erros e relatou divergências significativas entre revisores, sugerindo que as opiniões de especialistas não formam automaticamente um único valor de verdade.[2] Portanto, o objetivo do projeto de anotação não é encobrir divergências, mas torná-las mensuráveis, rastreáveis e resolvíveis. O conjunto de avaliação
deve evitar vazamento de dados e questionar a contaminação Os conjuntos de avaliação clínica de IA
devem definir limites de gerenciamento antes do treinamento e desenvolvimento. As amostras ao nível do paciente não podem ser repetidas entre o treino e o teste; vazamentos também podem ocorrer a partir de reescritas aproximadas do mesmo prontuário médico, diferentes fatias da mesma imagem ou segmentos divididos da mesma conversa. Para dados longitudinais, também é necessário verificar se informações futuras entram na entrada da pergunta atual; para perguntas e respostas sobre conhecimento médico, deve-se monitorar a possibilidade de questões públicas serem absorvidas pelo corpus de treinamento modelo. O responsável pela avaliação precisa gerenciar direitos de acesso, versões, registros de extração e exposição de perguntas. Após grandes revisões, ele deverá decidir se continuará a usar o conjunto de testes original.
Nos últimos anos, os benchmarks médicos multimodais começaram a mudar de perguntas e respostas de rodada única para estruturas de tarefas reais. O SMMILE do NeurIPS 2025 é uma avaliação de aprendizagem contextual multimodal construída por especialistas médicos. O estudo descobriu que as capacidades da maioria dos modelos testados em tarefas multimodais abertas ainda são limitadas e exemplos irrelevantes podem diminuir o desempenho.[3] O MTBBench da mesma sessão focou em problemas de tomada de decisão multimodais e longitudinais sobre tumores, apontando que o modelo ainda apresenta desempenho não confiável ao lidar com mudanças de tempo, evidências conflitantes e informações intermodais.[4] Esses estudos apoiam um julgamento prático: as questões de avaliação devem reter contexto clínico suficiente e testar sistematicamente a capacidade do modelo de lidar com conflitos, exclusões e mudanças de horário, e as capacidades clínicas não podem ser inferidas apenas por perguntas curtas e questões de múltipla escolha.
também define a cobertura e a dificuldade da tarefa. Pode abranger problemas comuns, situações raras, riscos críticos e graves, grupos especiais, dados incompletos, conflitos de evidências, correlações intermodais e mudanças de longo prazo nas camadas. O número de amostras e a distribuição da fonte são relatados para cada estrato. Além da pontuação média, também devem ser examinadas taxas de erro de alto risco, taxas de recuperação de defeitos críticos, desempenho de subgrupos, intervalos de confiança e incerteza nos resultados do modelo. Para cenários de “não sei” ou “informação insuficiente”, a recusa apropriada em responder ou solicitar informações adicionais deve ser considerada um comportamento avaliável, e cada pergunta não pode ser forçada a ser mapeada para uma conclusão médica.
O processo de anotação precisa gerenciar o desvio do revisor Os especialistas
também alterarão a escala de julgamento à medida que o projeto avança. Em projetos longos, as atualizações das diretrizes, a rotatividade de pessoal, o cansaço ou a recorrência de erros comuns podem fazer com que o significado do mesmo rótulo mude de mês para mês. Um conjunto de perguntas âncora que não são notificadas antecipadamente pode ser retido e tarefas de anotação podem ser inseridas periodicamente para comparar a consistência das revisões antigas e novas; os anotadores que continuam a desviar-se das normas podem ser treinados novamente e seus resultados recentes podem ser revisados. As perguntas âncora também devem ser atualizadas regularmente para evitar que os revisores apenas memorizem as respostas em vez de compreenderem os princípios de julgamento. O escopo do impacto deve ser registrado para cada alteração nas diretrizes e deve ser determinado se os lotes antigos precisam ser reetiquetados ou apenas versionados.
A auditoria de dados de anotações médicas deve se concentrar tanto nas amostras quanto nos revisores. O lado da amostra registra a fonte, o status de dessensibilização, a integridade do contexto, a versão da tarefa e a localização da evidência; o lado pessoal retém apenas a codificação anônima, o tipo de qualificação, o status do treinamento e os resultados da revisão necessários para concluir a auditoria de qualidade. Os avaliadores devem reduzir a exposição desnecessária de informações do paciente, apresentar o conteúdo necessário para completar o julgamento na interface da tarefa e controlar as permissões de exportação, download e acesso. Se a amostra envolver fala, imagens ou texto livre, informações de identificação direta e pistas de identificação combináveis devem ser incluídas na verificação de dessensibilização, em vez de apenas pesquisar no campo do nome.
Distinga também entre "resposta correta" e "resposta segura". O modelo pode fornecer conteúdo factualmente correto sem especificar condições aplicáveis, contraindicações ou aconselhamento médico de emergência; também pode fazer sugestões arriscadas e incorretas, mas o texto é muito fluente. As anotações de segurança exigem estratificação de gravidade independente e caminhos de danos claros, capacidade de descoberta de erros e recursos de interceptação manual em cenários reais de uso. Para situações que podem levar a atrasos no diagnóstico e tratamento ou tratamento inadequado, a condição de aprovação não pode ser baseada apenas na precisão média que atinge o limite. Um limite de falha e uma ação de escalonamento separados devem ser definidos.
Transforme resultados de testes cegos em circuito fechado de qualidade executável
Um teste cego não é o fim do projeto. Os resultados precisam ser retornados aos dados, especificações, modelos e processos do produto: se o erro vier de campos faltantes, preencha o dicionário de dados ou insira informações; se o erro for proveniente de confusão de conceito médico, revisar o sistema de rotulagem e adicionar amostras de controle; se o erro for de citação de evidência, verificar a fonte da pesquisa e a correspondência de referência; se o erro for proveniente de incompatibilidade multimodal, revise o mapeamento do arquivo e a associação do paciente; se diferentes especialistas continuarem a discordar, complemente a definição dos limites ou marque a situação como exigindo julgamento clínico. Cada rodada de otimização deve reter a versão da tarefa, a versão da amostra, a versão do modelo, as condições de revisão e as diferenças de resultados para evitar unir diretamente pontuações incomparáveis em uma curva de progresso.
O gerenciamento de projetos pode definir três estágios: limite de inicialização, qualidade do processo e aceitação da entrega. O limite inicial verifica se o guia passa na licitação do teste, se os especialistas médicos confirmam as regras e se as amostras de avaliação são mantidas de forma independente; a qualidade do processo monitora a taxa de erro de amostragem, o desvio do anotador e a taxa de arbitragem; a aceitação da entrega verifica a integridade dos campos, a precisão médica, a rastreabilidade das evidências, a conformidade com a privacidade e as versões dos arquivos. Definir diferentes níveis de gravidade para classificação de erros: defeitos que envolvam erros graves de diagnóstico ou vazamentos de privacidade devem desencadear suspensão e investigação abrangente; erros gerais de formato podem ser direcionados para reparo. Os termos de liquidação e recompra devem ser consistentes com a versão da regra para evitar o uso de diferentes calibres de pontuação para lotes diferentes.
A rotulagem médica não deve usar “muitas opiniões” como evidência de alta qualidade. A anotação de alta qualidade pode dizer à equipe modelo: onde a resposta está errada, por que o erro é importante, de que contexto vem a evidência, se há um desacordo razoável entre os médicos e como verificá-lo na próxima rodada de treinamento ou alterações de produto. Para aplicações clínicas, também deve ficar claro que os resultados da IA são informações auxiliares, que precisam ser revisadas pelos profissionais com base na situação real do paciente, nas evidências mais recentes e nos processos institucionais. As revisões de anotações podem ajudar a descobrir os limites do sistema, mas não substituem a responsabilidade clínica ou a avaliação de segurança no mundo real. As capacidades de rotulagem médica de
Langhui devem ser refletidas no processo de rastreabilidade
apresenta os serviços de dados médicos da Langhui para o mundo exterior e recomenda focar no design de especificações de rotulagem, colaboração de especialistas médicos, avaliação cega, arbitragem de qualidade e circuito fechado de defeitos, em vez de enfatizar apenas a produção. Ao implementar o projeto, os objetivos do cliente são primeiro convertidos em descrições de tarefas e padrões de pontuação e, em seguida, a compreensão das diferentes revisões é calibrada através de pequenos lotes de padrões de teste; após a entrada no trabalho formal, é estabelecida a revisão para amostras de alto risco, sendo mantidas as razões e vias de arbitragem para divergências de revisão; versões, estatísticas de inspeção aleatórias e registros de reparos de problemas são fornecidos durante a entrega. O tipo específico de marcação, as qualificações dos especialistas, a taxa de amostragem e o compromisso de aceitação estarão sujeitos ao escopo do projeto e ao acordo contratual.
O valor real desse recurso para a equipe de IA médica é que o conjunto de dados pode não apenas ser usado para treinamento, mas também se tornar uma ferramenta estável para medir a melhoria do modelo. Os especialistas médicos podem ver amostras de evidências e registros de disputas, as equipes de algoritmos podem mapear defeitos para tarefas de treinamento ou avaliação e os compradores podem verificar se cada lote de entregas atende às regras estabelecidas. Ao recomprar, ambas as partes ajustam as instruções do rótulo e as estratégias de amostragem com base na distribuição de defeitos do lote anterior, formando gradualmente uma linha de base de avaliação médica reutilizável.
Perguntas frequentes
Existem diferenças nas avaliações dos médicos. Isso significa que a anotação é inválida? Incerto. As divergências podem surgir de regras pouco claras, dados incompletos ou da existência de múltiplas opções clinicamente razoáveis. O acordo deve ser medido, as razões para o desacordo classificadas e tratadas através da complementação das diretrizes ou da arbitragem especializada, em vez da eliminação direta dos desacordos.
O teste cego precisa ocultar completamente a identidade do modelo? Para avaliações que comparam resultados de modelos, ocultar a identidade do modelo e aleatorizar a ordem muitas vezes reduz o viés de expectativa. Se a tarefa em si precisar conhecer as informações da ferramenta, essa limitação deverá ser documentada e outros meios usados para reduzir preconceitos, como revisão independente, indicadores predefinidos e apresentação anônima.
Como selecionar amostras de POC representativas? Além dos resultados da anotação, também devem ser entregues definições de tarefas, especificações de rótulos, registros de versão, estatísticas de amostragem e consistência, registros de arbitragem, classificação de defeitos e instruções de processamento de conformidade. Só então os resultados podem ser revisados, retreinados e usados para avaliação posterior.
Referências
[1] Tam et al. Uma estrutura para avaliação humana de grandes modelos de linguagem em saúde derivada de revisão de literatura. npj Medicina Digital, 2024. https://doi.org/10.1038/s41746-024-01258-7
[2] Colaboração entre médicos e modelos de linguagem de visão na geração de relatórios radiológicos. Medicina Natural, 2025. https://www.nature.com/articles/s41591-024-03302-1
[3] Rieff et al. SMMILE: Uma referência orientada por especialistas para aprendizagem médica multimodal em contexto. Rastreamento de conjuntos de dados e benchmarks NeurIPS 2025. https://doi.org/10.52202/085713-2180
[4] Vasilev et al. MTBBench: uma referência multimodal sequencial para tomada de decisões clínicas em oncologia. Rastreamento de conjuntos de dados e benchmarks NeurIPS 2025. https://doi.org/10.52202/085713-0368
[5] Grupo de direção STARD-AI. A diretriz de relatórios STARD-AI para estudos de precisão de diagnóstico usando inteligência artificial. Medicina Natural, 2025. https://doi.org/10.1038/s41591-025-03953-8