Résumé : des classements d’IA médicale au service de décisions fondées sur des preuves
Les listes dans le domaine de l'intelligence artificielle médicale sont souvent compressées dans un tableau trié par score total. Cependant, dans un scénario médical, ce n’est pas parce qu’un modèle est en avance sur les questions d’examen qu’il peut collecter de manière stable les antécédents médicaux, identifier les informations manquantes, sélectionner raisonnablement les examens, suivre les directives et exprimer l’incertitude quant au diagnostic et au traitement réels, ni qu’il est adapté pour être intégré aux services aux patients ou aux flux de travail des médecins. La véritable valeur de la liste n’est pas de créer un champion unique, mais de rendre les capacités du modèle, les limites des tâches, les risques, les coûts et les niveaux de preuves observables, comparables et révisables. Les références de questions et réponses médicales
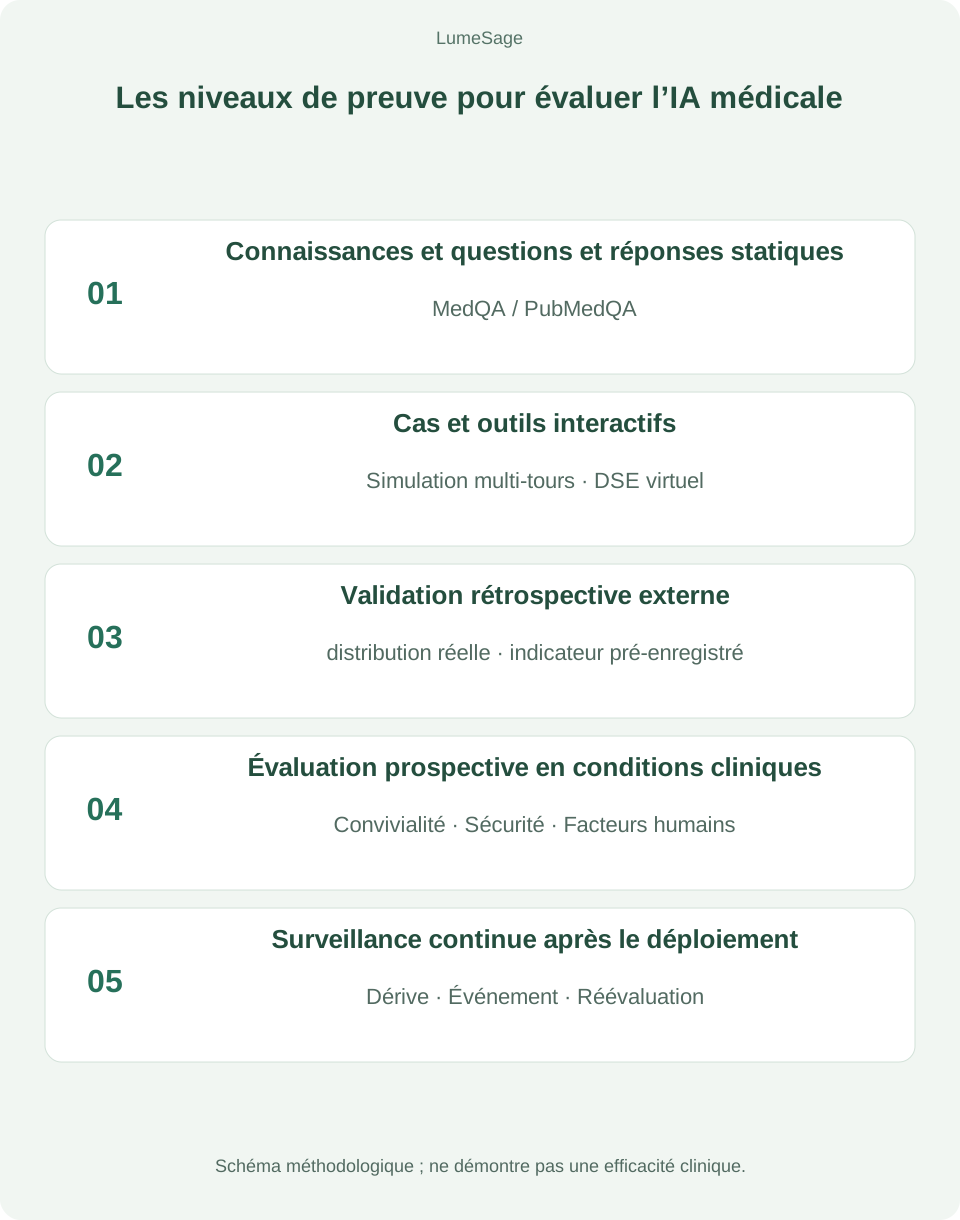
restent pertinentes. MedQA convertit les questions de l'examen de médecin américain en tâches de questions et réponses médicales. PubMedQA exige que le modèle combine le résumé de l'article pour déterminer si la conclusion de la recherche soutient le problème ; ils fournissent un point de départ reproductible pour la couverture des connaissances médicales et la capacité de lecture de recherches [1–2]. Mais la pratique clinique ne passe pas directement de la question à la réponse. Les patients ne présentent pas les informations dans l'ordre des manuels, tous les tests ne sont pas connus, plusieurs diagnostics peuvent être raisonnables simultanément et les décisions sont influencées par le temps, les ressources, les préférences des patients et leur tolérance au risque.
Les travaux d'évaluation de ces dernières années ont élargi les critères médicaux à des tâches plus proches du travail réel : HealthBench utilise des rubriques rédigées par des médecins pour évaluer des conversations ouvertes et à plusieurs tours sur la santé ; AgentClinic place les consultations, l'utilisation des outils et les informations incomplètes dans des environnements cliniques simulés ; MedAgentBench permet aux agents d'effectuer des tâches via un environnement de dossier médical électronique virtuel conforme au FHIR ; MedHELM organise plusieurs référentiels médicaux basés sur un système de classification des tâches [3–6]. La revue clinique de l’IA de 2026 a en outre souligné que les questions standards, les cas simulés, la validation rétrospective et l’évaluation clinique prospective se situent à différents niveaux de preuve et ne peuvent se remplacer [7].
Cet article est basé sur un plan de construction d'une liste d'IA médicale, axé sur l'analyse des multiples cycles de consultation, la simulation du retour d'examen, le codage CIM, la base des lignes directrices, la comptabilité analytique, l'évaluation experte en double aveugle et la conception collaborative homme-machine. La solution a une valeur technique évidente, mais il existe également des problèmes scientifiques qui doivent être corrigés en premier : les scores des modèles internes ne peuvent pas être directement utilisés comme classements publics lorsque la taille de l'échantillon, la version, les mots d'invite, les règles de notation et les intervalles de confiance sont incomplets ; les résultats d'examen manquants ne peuvent pas être discrètement complétés comme « négatifs » par le simulateur ; la véritable liste des dossiers médicaux ne doit pas être utilisée par défaut comme référence en matière de diagnostic et de traitement.
Cet article propose un chemin de construction plus robuste : définir d'abord les usages et les risques, puis organiser des cas sourcés, autorisés et représentatifs ; établir une échelle de preuves entre les questions statiques, les simulations interactives, la vérification externe rétrospective et les projets pilotes potentiels ; rendre compte en même temps de l'exactitude, de la sécurité, de l'étalonnage, de l'utilisation des ressources, de la convivialité et des performances de la collaboration homme-machine ; et enfin maintenir la liste avec des données versionnées, une notation vérifiable et des tests continus de l'équipe rouge. Pour LumeSage, cette orientation peut relier l'ingénierie des données, l'annotation médicale, l'examen par des experts, la gestion de la qualité et l'évaluation privée dans un processus de service vérifiable, plutôt que de regrouper « avoir des données » ou « être sur la liste » comme résultats cliniques.
1. Pourquoi les scores aux examens ne démontrent pas la compétence clinique
1. Les questions sur les connaissances médicales mesurent les tranches de capacité Le test de questions médicales à choix multiples
convient pour tester l'extraction de connaissances, l'analyse de concepts et les processus de raisonnement limités sous des questions claires. Leur avantage est que les formats de questions et réponses sont relativement stables, faciles à reproduire, faciles à établir des références et adaptés à l'observation des changements de modèle avec les mises à jour de version. Le problème est que la structure des questions du test condense la tâche clinique en « informations données – choisissez une réponse ». Le modèle n'a pas besoin de poser de questions, de décider s'il faut tester ou d'indiquer quelles informations sont insuffisantes pour étayer une conclusion. Les questions et réponses basées sur la recherche
ont également leurs propres limites de tâches. PubMedQA organise les questions, le contexte abstrait et les conclusions en jugements oui/non/peut-être, ce qui convient pour tester la lecture et l'induction des preuves, mais on ne peut pas en déduire que le modèle est capable de gérer des informations contradictoires dans les dossiers médicaux ou dans la communication médecin-patient réelle. Se référer directement aux résultats des tests comme « compétence clinique » revient à extrapoler les résultats d'une tâche étroite à une autre tâche systémique complexe.
2. La prise de décision clinique est un processus séquentiel
Le diagnostic et le traitement réels impliquent une série de choix interactifs : que demander en premier, quand effectuer un suivi, s'il faut tester, comment interpréter les nouveaux résultats, s'il faut réviser le diagnostic différentiel, quand arrêter le test et quand demander une révision. Les recherches d'AgentClinic ont transformé les questions MedQA statiques en plusieurs séries d'interactions et ont révélé que la difficulté de la prise de décision séquentielle augmenterait considérablement ; MedAgentBench a placé un ensemble de tâches dans un environnement de dossier médical électronique virtuel, exigeant que le modèle lise ou exploite des dossiers médicaux structurés via des appels d'outils [4–5]. Ces travaux rappellent que la capacité d’un modèle à répondre à des questions et la capacité d’un modèle à mener à bien un processus sont deux types de capacités différents.
3. Le coût des erreurs médicales est asymétrique
Manquer un signe critique, fabriquer un résultat d'inspection qui n'a pas été fait et proposer des mesures inutiles à haut risque ne peuvent être déduits selon les mêmes normes qu'une mauvaise formulation. La précision globale peut masquer des manquements à la sécurité à faible fréquence mais aux conséquences importantes. Les critères de sécurité tels que NOHARM prennent « la fréquence et la gravité des dommages potentiels » comme objet d'évaluation spécial ; ses recherches doivent toujours être interprétées en fonction des cas et de la plage d'annotations de l'article lui-même, mais elles illustrent clairement que la sécurité n'est pas synonyme de scores de connaissances médicales [8].
4. Les normes médicales vieilliront et pourraient devenir « cuites »
Lorsque la banque de questions publiques est utilisée à plusieurs reprises pour la formation, l'optimisation des mots rapides et la sélection du modèle, le score de la liste peut refléter davantage la familiarité du modèle avec la distribution des questions plutôt que sa capacité de généralisation face à de nouveaux cas. Les ensembles de tests statiques peuvent également rapidement perdre leur distinction en raison d'une itération trop rapide du modèle. Dynamic Red Teaming Research 2025 et ses travaux de revue 2026 démontrent la valeur des invites de mutation continues, des scénarios contradictoires et des tests de résistance de sécurité en plus des tests statiques [9]. Les tests dynamiques ne sont pas une solution universelle : si les règles d’attaque de chaque tour ne sont pas transparentes ou reproductibles, les scores seront difficiles à comparer. Par conséquent, il est prudent d’utiliser des ensembles publics fixes pour des lignes de base reproductibles, des ensembles cachés contrôlés, une validation hors délai et une équipe rouge dynamique pour les contrôles de nouveauté et de robustesse, et de divulguer clairement les questions auxquelles répond chaque score.
2. Des benchmarks statiques à l’évaluation des processus cliniques
1. Des réponses à une question unique aux conversations réelles Les informations originales du projet
HealthBench montrent que le benchmark comprend 5 000 dialogues sur la santé, qui ont été construits par 262 médecins ayant exercé dans 60 pays, et qu'une grille de notation élément par élément est conçue pour les réponses modèles ; les informations officielles indiquent clairement que le dialogue peut être multitours, multilingue, et couvrent également des scénarios entre utilisateurs ordinaires et professionnels de la santé [3]. Par conséquent, la description de HealthBench comme « toutes les conversations à tour de rôle » dans les documents du programme doit être corrigée. La clé ici n'est pas de savoir si un certain benchmark est « le plus avancé », mais que l'introduction du benchmark doit revenir au document original et vérifier la description officielle des données, et ne peut pas s'appuyer sur des tableaux de seconde main.
Les médecins rédigent des rubriques élément par élément pour éviter d'évaluer des réponses médicales ouvertes avec la seule correspondance de mots clés. Mais la couverture des rubriques, les pondérations, les limites de décision et les évaluateurs automatiques doivent encore être vérifiés. Le travail original sur HealthBench utilisait également des modèles d'évaluation et demandait aux médecins de les examiner pour vérifier leur cohérence avec les jugements humains ; ces méthodes peuvent être étendues à plus grande échelle, mais ne doivent pas être interprétées comme « les juges LLM sont naturellement objectifs ».
2. Des cas statiques à l'environnement interactif
AgentClinic définit des rôles tels que les médecins, les patients et les outils de mesure dans un environnement simulé pour prendre en charge des informations incomplètes, plusieurs cycles d'interaction et l'utilisation d'outils [4]. MedAgentBench fournit en outre 300 tâches cliniques, 100 dossiers de patients et un environnement DSE virtuel conforme au FHIR [5]. Ils élargissent l'objet d'évaluation à partir d'une réponse textuelle jusqu'à « si le modèle peut effectuer l'action spécifiée dans un certain environnement ».
La valeur de l'environnement de simulation réside dans sa contrôlabilité, sa répétabilité et sa possibilité d'enregistrement ; sa limite réside dans l’écart entre le simulateur de patient, le simulateur d’examen, la structure des données du dossier médical et le système médical réel. Le document de MedAgentBench mentionne également clairement que l'environnement virtuel ne peut pas être directement utilisé comme système de production et souligne qu'il existe des limites en termes de sources de données et de couverture des tâches. Pour les benchmarks auto-construits, l'environnement de l'agent doit non seulement demander « si la tâche est terminée », mais également enregistrer les appels d'outils, les changements d'état, les opérations non autorisées, les demandes invalides, les vérifications répétées et les points de terminaison.
3. D’une « grande liste » au pedigree des tâches
MedHELM organise de grandes évaluations de modèles médicaux en 5 catégories principales, 22 sous-catégories et 121 tâches, et rassemble plusieurs références existantes et nouvelles [6]. Cette structure illustre mieux ce à quoi le modèle est adapté et ce à quoi il ne convient pas plutôt que de regrouper le diagnostic, la génération de dossiers médicaux, la communication avec les patients, la recherche médicale et les processus administratifs en un seul score. L'inspiration est la suivante : le premier niveau de la liste devrait être la classification des utilisations, et le deuxième niveau devrait être la comparaison de modèles.
Par exemple, les résumés de dossiers cliniques et l'éducation des patients appartiennent à différents scénarios de risque ; L'extraction des rapports de test, les recommandations de diagnostic et la planification des ressources médicales ne doivent pas partager le même ensemble de poids d'évaluation. Pour une liste orientée vers un objectif spécifique, les utilisateurs cibles, les informations saisies, les outils autorisés, les résultats du système, les responsabilités de révision manuelle et les coûts d'échec doivent être fixés en premier, puis les dimensions de notation doivent être déterminées.
4. Du classement ponctuel à la surveillance continue
Les systèmes d'IA clinique peuvent s'appuyer sur des API modèles, des mots d'invite, des bibliothèques de recherche, des chaînes d'outils et des stratégies d'interaction homme-machine. Le simple fait de signaler « nom du modèle + score » n'est pas suffisant pour reproduire un système. TRIPOD-LLM en 2025 rappelle aux chercheurs de rapporter des informations telles que les scénarios d'utilisation, les modèles et les versions, l'ingénierie rapide, le traitement des données, les qualifications de l'examen humain et le contrôle qualité ; TRIPOD+AI, DECIDE-AI et CONSORT-AI fournissent respectivement des cadres de reporting correspondants pour les rapports de modèles prédictifs, l'évaluation précoce de scénarios réels et les essais cliniques d'intervention en matière d'IA [10–13]. Ces lignes directrices ne constituent pas une approbation clinique ou une certification de qualité, mais elles illustrent que la transparence des rapports est la base de la comparabilité et de la reproductibilité académiques.
3. Analyse de la proposition : faisabilité, limites et améliorations
1. Dossiers médicaux réels et informations complexes : la direction est correcte et la source et la représentativité de l'échantillon doivent être claires Le programme
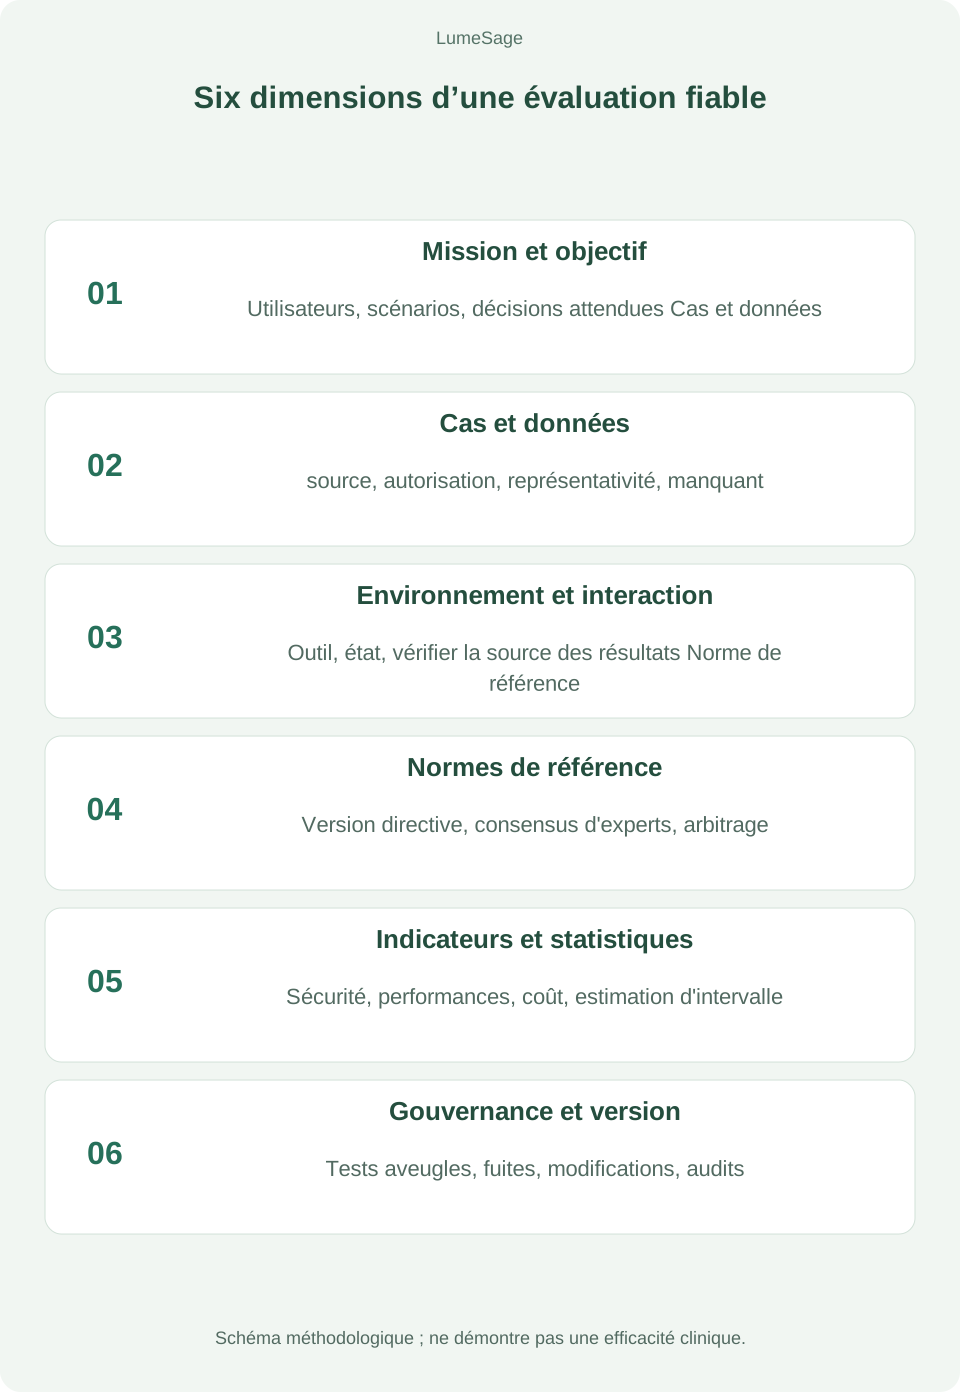
recommande d'utiliser des dossiers médicaux réels structurés, des tests et des informations sur les examens pour améliorer l'abondance des informations cliniques, ce qui constitue une orientation nécessaire. Les textes cliniques contiennent des abréviations, des omissions, des fautes de frappe, des périodes et des contradictions entre les documents, ce qui rend difficile pour les cas synthétiques de couvrir toute la véritable complexité. L'utilisation de données réelles doit également expliquer : les sources de données et la portée de l'autorisation, la déduplication au niveau du patient, la protection de la vie privée, les critères d'inclusion et d'exclusion, la répartition des établissements et de la population, les ratios de maladie et de gravité, les mécanismes manquants et s'il existe des problèmes avec le même patient dans les ensembles de formation/test.
« Réel » ne signifie pas « représentatif ». Les données provenant de grands hôpitaux ou de départements uniques ne peuvent pas être naturellement extrapolées aux communautés, aux différentes régions et aux différents groupes linguistiques. Les mesures doivent rendre compte des performances par milieu clinique, établissement, groupe d'âge, sexe, sous-type de maladie et groupe à risque clé ; lorsque les échantillons disponibles sont insuffisants, l’incertitude doit être explicitée plutôt que de traiter les scores des groupes d’échantillons faibles comme des classements fiables.
2. Simulation des résultats de l'inspection : des recherches peuvent être effectuées, mais les inconnues ne peuvent pas être déguisées en négatives Le plan
propose que lorsque le cas d'origine ne fournit pas l'examen demandé par le modèle, « l'agent d'examen » prédira le résultat. Cela peut aider à construire des scènes interactives, mais c’est aussi le maillon le plus risqué de toute la conception technique. Dans les données du monde réel, « aucune inspection » signifie que le résultat est inconnu, ce qui ne signifie pas que le résultat est normal ; si le simulateur génère un résultat apparemment raisonnable et le renvoie directement au modèle testé, le test passera de « prise de décision avec des informations incomplètes » à « prise de décision avec des informations écrites manuellement », ce qui peut induire des conclusions erronées et faire dépendre les résultats du test de la déviation du simulateur lui-même.
recommande que l'état des informations soit strictement distingué entre : résultats observés, clairement non réalisés, impossibles à obtenir et génération de simulation. Les résultats de simulation sont renvoyés uniquement dans une tâche d'étude de simulateur distincte, et leur source de génération, leur niveau de confiance, leur applicabilité et leur véritable vérification de distribution sont conservés en arrière-plan. La liste principale peut être constituée de deux pistes : l'une évalue uniquement les informations déterministes des cas ; l'autre utilise un simulateur environnemental vérifié en externe avec des données réelles pour évaluer la gestion par le modèle des résultats incertains. Les simulateurs ne doivent pas être utilisés comme générateurs invisibles de faits cliniques.
3. CIM-10 et notation standardisée : C'est utile pour normaliser les dossiers, mais cela ne signifie pas établir une référence en matière de diagnostic.
Le mappage des diagnostics avec des codes tels que la CIM-10 est utile pour les statistiques hiérarchiques, l'agrégation de catégories et l'examen inter-équipes, mais la correspondance de codes ne peut répondre que « où le système code-t-il la conclusion ? et ne peut pas répondre de manière indépendante « si le jugement clinique est correct ». Les niveaux de codage peuvent être trop grossiers, de multiples conclusions peuvent être justifiées et les diagnostics peuvent changer avec le temps et avec de nouveaux tests. L’approche correcte consiste à utiliser le codage comme champ auxiliaire calculable, tout en conservant les enregistrements des concepts cliniques, des preuves, des diagnostics alternatifs acceptables, de la hiérarchie diagnostique et du jugement d’expert.
La norme de référence doit être établie par des médecins possédant une expérience spécialisée correspondante, sur la base des données de cas et des directives applicables ; si nécessaire, deux personnes doivent le noter de manière indépendante, l'arbitrer par un tiers et enregistrer les différences. Dans les cas où il existe plusieurs voies cliniquement raisonnables, la notation devrait reconnaître un ensemble prédéfini de réponses acceptables plutôt que de traiter un seul code de sortie comme la seule bonne réponse.
4. Cohérence des lignes directrices : chemin d'évaluation, mais verrouillez la version et le groupe applicable
Intègre des lignes directrices, des parcours cliniques et un consensus d'experts pour justifier le choix de ce test ou de ce traitement. Le protocole d'évaluation doit fixer le nom de la ligne directrice, sa version, sa date de publication, la population applicable et la force de la recommandation ; sinon, le modèle peut être noté avec une recommandation obsolète ou inappropriée pour le patient. Les lignes directrices ne peuvent pas non plus épuiser les préférences, les contre-indications, la disponibilité des ressources et les incertitudes cliniques de chaque patient.
suggère de diviser la cohérence des lignes directrices en trois questions vérifiables : si des étapes clés nécessaires ont été omises ; si les étapes effectuées ont des indications correspondantes ; si le modèle exprime une incertitude et propose une voie de mise à niveau raisonnable lorsque les preuves sont insuffisantes ou non couvertes par la ligne directrice.« Mentionner des mots clés dans la ligne directrice » ne peut pas être considéré comme « suivre la ligne directrice », et la fluidité du processus de raisonnement ne doit pas non plus être directement assimilée à l'exactitude clinique.
5. Évaluation des coûts : L'inclusion des aspects économiques dans la liste constitue un progrès, mais un prix unique ne peut pas remplacer la valeur clinique.
propose de calculer la consommation de ressources sur la base des prix des inspections et peut identifier la stratégie déraisonnable des « inspections illimitées afin d'augmenter l'information ». Ceci est conforme à l’orientation du Sequential Diagnosis Benchmark visant à placer les coûts de diagnostic séquentiel et d’examen dans le même environnement d’évaluation [14]. Cependant, le prix des services médicaux dépend de la région, de l'hôpital, du système de paiement, de l'assurance des patients et des combinaisons d'examens spécifiques ; la liste de prix ne peut être qu’une approximation pour un moment et un scénario donnés, et non une véritable valeur de coût universelle.
Une approche de reporting plus robuste consisterait à présenter simultanément les performances diagnostiques, le risque de diagnostic manqué, le surexamen, le nombre d'examens, la fourchette de coûts, le temps d'attente, la charge médicale supplémentaire et l'incertitude. Tracez la frontière « risque-effet-coût » pour différents modèles afin d'expliquer sous quels usages, seuils et environnements de paiement une certaine solution est la plus adaptée, plutôt que de déclarer directement qu'un modèle est « le plus rentable ». S’il n’existe aucune base pour une pondération de l’utilité clinique ou une analyse décisionnelle, plusieurs indicateurs ne doivent pas être convertis de force en un seul retour sur investissement.
6. Stabilité et pass@k : doivent être définis avec précision, sans échantillonnage répété pour remplacer la fiabilité unique
Les systèmes médicaux sont généralement confrontés à une demande réelle lorsqu'ils sont déployés, donc pass@1 indique si une seule exécution peut accomplir la tâche ; pass@k met généralement l'accent sur la probabilité d'au moins un succès parmi plusieurs tentatives, et la probabilité de « k tous les succès » ou la variance des scores entre les tentatives est un autre indicateur de stabilité. Pass@k et pass^k dans le schéma doivent être clairement définis un par un dans le protocole papier, et le nombre de répétitions, les graines aléatoires, la température, la stratégie d'échantillonnage et l'algorithme récapitulatif de chaque cas doivent être notés.
Si le modèle peut être réessayé dans des scénarios réels, le système peut afficher la meilleure réponse à l'utilisateur, mais cette approche modifiera le délai, le coût et le risque et doit être évaluée séparément. La qualité post-formation ou la stabilité clinique ne peuvent pas être directement déduites de la seule différence entre pass@k et pass@1 ; les différences statistiques prennent également en compte la taille de l'échantillon, les intervalles de confiance, le regroupement des cas et les plans d'analyse prédéterminés. Tous les classements doivent donner des intervalles d’incertitude et éviter d’interpréter les échanges de classement sur de petits échantillons comme des différences générationnelles de capacités.
7. LLM-as-a-Judge : développez les capacités d'annotation, conservez l'étalonnage et l'audit d'experts
L'arbitre LLM convient à la vérification du format, à la vérification partielle des faits, à la sélection préliminaire des rubriques et à la notation auxiliaire de grands échantillons. Cependant, il peut préférer des réponses plus longues, plus sûres et formulées davantage comme ses propres résultats, ou il peut partager les mêmes angles morts de connaissances avec le modèle testé. Des études telles que HealthBench et MedHELM ont démontré la pratique des marqueurs de rubriques et de modèles, et ont également illustré la nécessité de comparer la cohérence entre les marqueurs et les jugements des experts cliniques [3,6].
recommande l'utilisation d'une notation hiérarchique : des règles déterministes sont utilisées pour les éléments vérifiables programmables ; les faits médicaux et les points clés de sécurité sont examinés à l'aide de sources citées, de règles et d'experts cliniques ; l'expérience de communication et l'adéquation du programme sont examinées à l'aide d'examens cliniques aveugles formés. Une certaine proportion de chaque lot d'échantillons est sélectionnée pour une notation indépendante par deux personnes, et l'indice de cohérence, le taux de désaccord et le statut d'arbitrage sont rapportés. Le nom et la version du modèle d'arbitre, les mots d'invite, la température de notation, la version de la rubrique et les échantillons d'étalonnage sont également gelés et archivés.
8. Plateforme experte en double aveugle : nécessité de prévenir l'aveuglement, les effets d'ordre et la fatigue de notation Les plates-formes de comparaison de cas, de questions et réponses à double modèle et de tests aléatoires à l'aveugle conçues dans le plan
sont opérationnelles. Pour rendre les résultats fiables, l'aveuglement ne peut pas reposer uniquement sur le masquage des noms de modèles : le format de sortie doit être unifié, les balises de style de fournisseur et de modèle supprimées et l'ordre des réponses randomisé ; les évaluateurs ne doivent pas connaître la source des réponses ni leur position sur la liste ; deux réponses modèles pour le même cas ne doivent pas révéler des indices appariés dans l’interface. Une formation de révision, un contrôle de la fatigue, une détection des questions en double, un délai de notation, un questionnaire de devinette aveugle et un examen des objections doivent être mis en place.
Les évaluations des experts cliniques ne sont pas non plus « naturellement impartiales ». Les jugements sur les risques acceptables peuvent différer selon les spécialités, les années d’expérience et les contextes de pratique. Les études doivent rendre compte des qualifications des évaluateurs, de la répartition des spécialités, des méthodes d'appariement des tâches, des processus de cohérence et d'arbitrage entre évaluateurs, et de mettre en place des mécanismes de participation pour répondre aux préoccupations des patients et du public. DECIDE-AI met l'accent sur l'aspect pratique clinique, la sécurité, les facteurs humains et la préparation à d'autres essais lors de l'évaluation clinique précoce ; cela nous rappelle que la véritable évaluation clinique doit se concentrer sur les utilisateurs, le flux de travail et l'itération du système, et pas seulement sur les scores de réponse du modèle [12].
4. Une méthodologie fiable pour évaluer l’IA médicale
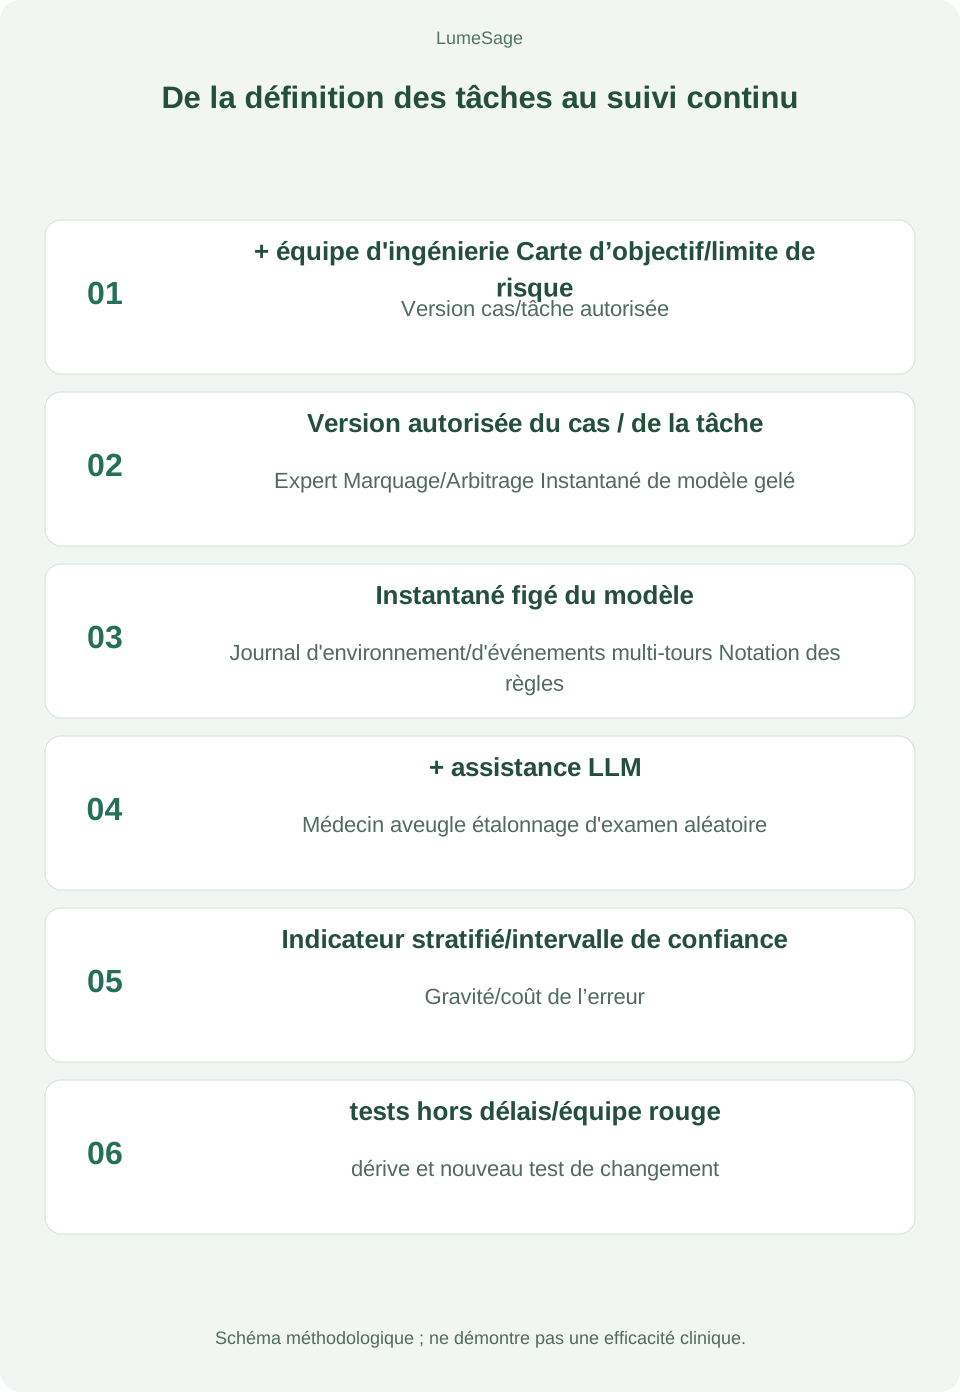
1. Créez d'abord la « Carte d'objectif », puis rédigez les questions.
Pour chaque sous-élément de la liste, remplissez d'abord la fiche objectif : qui est l'utilisateur cible ; quels types de patients et de problèmes cliniques sont servis ; quel rôle joue le modèle ; quelles données peuvent être incluses dans l'entrée ; si le résultat affecte les décisions médicales réelles ; si la récupération, les outils ou les dossiers médicaux électroniques peuvent être appelés ; qui effectuera l'examen final ; quel mal sera causé par un échec. Les cartes d'objectif déterminent les tâches, les niveaux de risque, les mesures et le libellé de la divulgation. En l’absence d’une définition d’objectif, la liste ne peut pas expliquer ce que le score signifie pour l’approvisionnement ou le déploiement clinique.
2. Établir le pedigree du cas et la carte de données
Chaque cas enregistre au moins l'identification anonymisée du patient/de la visite, le type de tâche, la maladie et la gravité, la source d'informations, le moment, les champs structurés, l'association entre les documents et les examens, la base d'étiquetage, la version des lignes directrices applicables, le statut manquant, les règles d'inclusion/exclusion de cas et un ensemble de réponses acceptables. La répartition au niveau des cas doit éviter le même patient, la même visite ou des documents presque en double couvrant la formation, l'ajustement des paramètres et les ensembles de tests. L'ensemble de test doit conserver la version et le lignage des données ; des audits de pollution réguliers doivent être menés sur le plateau public, et un contrôle d'accès et des journaux d'audit doivent être mis en place sur le plateau caché.
3. Carte de tâche de conception et état de l'environnement
décrit chaque tâche comme : informations initiales, questions que le modèle peut poser, outils disponibles, règles de retour d'environnement, conditions de fin, opérations autorisées, opérations interdites et risques prédéfinis. Les tâches séquentielles doivent conserver des traces complètes de dialogue et d'outils, en distinguant les modèles sans requêtes, les environnements sans données, les vérifications non effectuées et les résultats inconnus. Si des patients simulés ou des agents d'inspection participent au test, leur processus de vérification et leur mode de défaillance doivent être divulgués ; l'environnement de simulation ne peut pas divulguer d'étiquettes au modèle testé, et de nouveaux faits non conformes aux règles de transition d'état ne peuvent pas non plus être générés simplement parce que le modèle testé doit effectuer quelques tours supplémentaires.
4. Utiliser le tableau de bord des indicateurs au lieu d'un score total unique Il est recommandé de diviser
en au moins six groupes d'indicateurs : Performance des tâches
1. Précision du diagnostic ou de la décision, couverture des étapes clés, exhaustivité de l'extraction structurée, taux d'achèvement des tâches.2. Sécurité des patients Erreur grave, omission dangereuse, manipulation excessive, faux confort, négligence taboue, examen ou citation fictif.3. Qualité du processus Efficacité de la collecte d'informations, sélection des inspections, opérations répétées, exactitude de l'appel de l'outil et s'il faut s'arrêter au moment approprié.4. Incertitude Erreur d'étalonnage, stratification du risque, pertinence du travail de rejet/mise à niveau, relation entre la prévision sélective et la couverture.5. Utilisation des ressources Avantages cliniques en termes de coût, de retard, de nombre d'examens, de temps d'examen manuel et de contraintes de ressources.6. Généralisabilité Performance dans le temps, hors institution, sous-groupes, différentes qualités d'entrée, variantes linguistiques et perturbations contradictoires.
Il devrait y avoir un seuil minimum pour les performances en matière de sécurité ; les modèles présentant de graves défauts de sécurité ne doivent pas être « compensés » par la note globale globale en raison de notes élevées sur des tâches à faible risque. La liste peut fournir une vue pondérée pertinente par rapport à l'objectif, mais les pondérations, les seuils et l'analyse de sensibilité doivent être divulgués, et chaque indicateur original doit être conservé pour que les lecteurs puissent l'examiner.
5. Plan statistique de pré-enregistrement et rapport de version
Avant d'exécuter le modèle, notez d'abord le critère d'évaluation principal, le critère d'évaluation secondaire, la base de la taille de l'échantillon, l'objet de comparaison, l'intervalle de confiance, le traitement des données manquantes, l'analyse stratifiée, le traitement des comparaisons multiples et les règles d'arrêt. Les résultats des tâches peuvent être regroupés en fonction des cas, des patients et des établissements pour calculer les intervalles ; les comparaisons multimodèles pour le même cas doivent utiliser une analyse par paires appropriée pour éviter de traiter les tests de chaque modèle comme indépendants les uns des autres. Les versions du modèle et des mots d'invite, la température, les autorisations des outils, les sources de recherche, les dates d'API, les configurations logicielles et matérielles et les sources de prix doivent être conservés dans les dossiers. Une fois le fournisseur modèle mis à jour, n'utilisez pas directement l'ancien classement. Vous devez marquer l'instantané et réévaluer.
6. Le benchmark public adopte la structure parallèle de « ensemble de développement-ensemble de validation-ensemble caché-ensemble dynamique » L'ensemble de développement
est utilisé pour le débogage de la communauté, l'ensemble de vérification prend en charge l'étalonnage des paramètres et des règles de notation, l'ensemble caché réduit le surajustement de la cible de test et l'ensemble dynamique de l'équipe rouge teste les nouvelles attaques et les modifications de distribution. Les quatre types de données ont chacun leur propre utilisation et ne doivent pas être combinés dans un mystérieux « ensemble de tests total ». Si des échantillons de cas sont rendus publics, le risque qu’ils soient inclus dans les moteurs de recherche et dans les corpus de formation ultérieurs devrait être évalué ; Les étiquettes clés, les rubriques complètes ou les cas cachés ne doivent pas nécessairement être rendus publics, mais les protocoles d'évaluation, les résumés statistiques, les codes ou les interfaces vérifiables doivent être rendus publics et les procédures d'accès des chercheurs doivent être établies.
5. Quatre étapes du prototype aux preuves cliniques
Phase 0 : Définition des limites et de la gouvernance, ~ 4 à 6 semaines
Choisissez d'abord une tâche d'entrée spécifique, vérifiable et à faible risque, telle que « vérification de l'intégrité des informations sur les documents cliniques » ou « extraction de champs de rapports d'imagerie spécifiques », plutôt que de commencer par « évaluer toute l'IA médicale ». Mettre en place une équipe avec participation clinique, algorithmique, statistiques, protection des données et produits ; former une fiche d'objectif, une analyse des risques, une liste d'autorisation des données, des spécifications d'étiquetage des cas, un manuel de notation et un plan statistique de pré-enregistrement. Les seuils d'étape sont les suivants : la source du cas est claire, les utilisations autorisées sont claires et les normes d'évaluation peuvent effectivement être utilisées par deux experts indépendants.
Phase 1 : ligne de base statique et annotation aveugle, environ 6 à 10 semaines
Créer un ensemble d'ensembles de développement et d'ensembles de vérification indépendants pour l'itération ; sélectionnez des instantanés de modèle public et des interfaces de modèle privé, et gelez les mots d'invite et les configurations. Nous évaluons d'abord la performance des tâches, les types d'erreurs, les performances hiérarchiques et la cohérence entre les arbitres automatiques et les scores des experts, et ne cherchons pas à publier une seule fois un « classement national ». Les seuils d'étape sont les suivants : les principaux indicateurs peuvent être répétés, il existe un processus d'arbitrage pour noter les litiges et les erreurs graves de sécurité peuvent être rattachées aux cas et aux preuves.
Phase 2 : Environnement interactif et validation externe, ~8 à 14 semaines
Placez les tâches de consultation, de prise de décision en matière d'examen ou d'exploitation de dossiers médicaux dans un environnement de simulation isolé. Le statut du patient, les résultats des examens, les interfaces des outils, les délais et les coûts des ressources sont tous sauvegardés ; les données simulées sont strictement séparées des données d’observation réelles. Au minimum, la validation est répétée sur des cas mis de côté provenant de différentes sources ou périodes, et le cadre et l'étiquetage sont examinés par une équipe clinique indépendante. Les seuils d'étape sont les suivants : le simulateur dispose de rapports de validation, les écarts de performances entre sources sont quantifiés et aucune information synthétique non étiquetée n'est mélangée aux faits cliniques.
Phase 3 : Pilote de flux de travail réel à petite échelle et surveillance continue
Si la tâche doit affecter les décisions médicales réelles, elle doit faire l'objet d'une évaluation prospective à petite échelle soutenue par l'éthique, la confidentialité et la gouvernance institutionnelle, et être positionnée comme une « exécution assistée » plutôt qu'une « exécution automatisée ». Enregistrez si les médecins ont consulté et suivi les recommandations, la durée d'utilisation, le comportement de modification, la fréquence des escalades manuelles, les événements indésirables potentiels, la charge de travail et les performances dans différents sous-groupes. Faites rapport de manière transparente conformément aux directives applicables telles que DECIDE-AI et sélectionnez les spécifications appropriées en fonction du type d'étude spécifique. Les études cliniques ou les voies de production à plus grande échelle ne sont discutées qu'une fois que les seuils de sécurité et d'efficacité prédéfinis sont atteints. Le projet de cycle de vie du logiciel de dispositif médical d'IA publié par la FDA en 2025 fournit des suggestions de gestion des risques et de dépôt de documents pour les produits associés, mais le document est marqué comme un projet et non contraignant, et ne doit pas être décrit comme une approbation complète ou une conclusion réglementaire généralement applicable [15].
La période de temps pour les phases 0 à 3 n'est qu'un intervalle de planification de projet et ne constitue pas un engagement de livraison garanti ; la période réelle dépend de la coopération institutionnelle, de l'examen éthique, de l'autorisation des données, du volume de cas, des ressources d'examen et des utilisations spécifiques. Le budget doit être réparti entre la gouvernance des données, les experts cliniques, l'ingénierie, les statistiques, la plateforme, les audits de sécurité et la maintenance continue, plutôt que de simplement estimer le volume d'appels d'un modèle.
6. La contribution des benchmarks aux soins de santé
1. Permettre aux établissements médicaux de choisir des modèles davantage basés sur
Les établissements de santé peuvent visualiser les marges de sécurité, les coûts et les types d'erreurs d'un modèle par tâches spécifiques plutôt que de parier sur un classement global. Pour l'approvisionnement, la liste peut transformer « les performances de démonstration du modèle sont bonnes » en termes d'acceptation vérifiables : étendue de l'échantillon et de la tâche, seuil d'erreur grave, délai de réponse, enregistrements d'audit, tests de régression après la mise à jour de la version et mécanisme de mise à niveau lorsqu'il ne peut pas être traité.
2. Aidez l'équipe modèle à localiser la véritable direction de l'amélioration
Une précision insuffisante peut résulter des connaissances, de la collecte d'informations, de la lecture d'images, de l'appel d'outils, de l'intégration contextuelle, de l'étalonnage ou de la présentation. La classification des erreurs et les traces de processus peuvent relier l'enrichissement des données, la post-formation, l'amélioration de la récupération, la conception d'outils et les politiques de sécurité. Pour les services de données, cela permet de passer du « combien d’échantillons à fournir » à « quels échantillons peuvent combler quelle lacune de capacité observable ».
3. Réduire les risques invisibles supportés par les patients et les équipes cliniques Si la liste
enregistre les omissions, les opérations trompeuses, les vérifications excessives, les opérations ultra-autorisées et les comportements incertains, elle peut aider les organisations à définir des points de révision manuels avant le déploiement. Cela ne garantit pas un risque zéro, mais cela peut rendre les risques connus plus faciles à identifier, à communiquer et à gérer.
4. Établir une base de comparaison reproductible pour la recherche
Les tâches standard, les configurations figées, les rapports publics et les audits de versions peuvent réduire l'incomparabilité provoquée par « chacun testant le sien » entre différentes organisations. Les chercheurs peuvent également observer la dérive des performances du modèle dans différentes tâches, langages, institutions et versions, fournissant ainsi un point de départ traçable pour la validation externe et la recherche prospective.
5. Laissez les services de données et l'évaluation clinique former une boucle fermée
Lorsque la spécification des données et l'évaluation du modèle sont cartographiées, l'équipe peut suivre « les attributs du cas – les preuves étiquetées – l'échec du modèle – les échantillons supplémentaires – les résultats des nouveaux tests ». Cette boucle fermée permet de faire la distinction entre la qualité des données, la qualité des annotations et les capacités du modèle : l'échec du modèle n'est pas nécessairement un manque de données, et l'abondance des données ne produit pas automatiquement une valeur clinique. La conclusion de l'évaluation doit revenir sur des tâches et des fiches de données spécifiques, plutôt que de simplement dresser une liste publicitaire.
7. LumeSage : des processus d’évaluation vérifiables
La construction de la liste d'IA médicale nécessite plus que la simple capacité d'ingénierie pour appeler le modèle. Il doit également traduire les objectifs cliniques en spécifications de tâches, intégrer les sources de cas, l'autorisation, la désensibilisation et la gestion des versions dans les processus de données ; établir des associations traçables pour les images, les documents, les tests et les échantillons multimodaux ; précipiter l'annotation de la spécialité, l'examen, l'arbitrage des désaccords et la notation des rubriques dans des dossiers vérifiables ; puis utilisez la plate-forme d'ingénierie pour effectuer l'exécution automatisée, la lecture des journaux, la comptabilité analytique et la génération de rapports.
LumeSage peut organiser des services autour de ces liens : tri des exigences et des utilisations, conception des ensembles de tests, spécifications des échantillons et cartes de données, annotation médicale et inspection de la qualité, évaluation aveugle par des experts, environnement d'évaluation privé, rapport de référence et régression de version. La valeur des services d'évaluation privés tels que Medical Gate doit s'expliquer par les limites réelles des tâches, l'autorisation des données, la participation d'experts, les protocoles de notation et les preuves de réplication ; les déclarations concernant la sécurité des patients ou les effets cliniques doivent être étayées par des recherches correspondantes et des preuves de scénarios applicables.
La simulation multi-agents, l'analyse des coûts, la plateforme experte et la notation orientée diagnostic présentées dans cette solution peuvent être utilisées comme voie de recherche et développement et de vérification interne d'hypothèses. Avant de publier publiquement les résultats du modèle, le nombre et la source des cas, la répartition des données, les instantanés du modèle, les mots d'invite, la température, les outils, le nombre de répétitions par cas, la grille de notation, la composition des experts, la cohérence des arbitres, l'intervalle de confiance, la zone de coût et la méthode de calcul, ainsi que les informations de pré-enregistrement ou de récurrence du code doivent être complétées. En l’absence de ces éléments, il n’est pas approprié de qualifier le classement interne de classement public vérifié de manière indépendante ; ce livre blanc ne divulgue pas le classement spécifique des modèles ni les coûts de chaque cas dans le plan.
Quant à la question « La liste médicale peut-elle prouver que le modèle peut diagnostiquer et traiter de manière indépendante », la réponse doit être claire : non. L'analyse comparative fournit des preuves hors ligne pour des tâches spécifiques ; la véritable utilisabilité clinique dépend également de la validation externe, du flux de travail clinique, des facteurs humains, des limites réglementaires et des études prospectives de sécurité et d'efficacité. La crédibilité de la marque de l’IA médicale doit être établie par des limites claires, des méthodes révisables et la capacité de remettre en question les résultats.
Conclusion : une cartographie des preuves au-delà d’un classement unique
L'avenir de l'IA médicale Benchmark ne devrait pas être une médaille qui reste inchangée à vie, mais une carte élargie en fonction de l'objectif, de la population de patients, du type de données, du risque, du coût et du niveau de preuve. Cela permet non seulement aux modèles de démontrer les progrès réalisés dans des tâches claires, mais présente également des problèmes non résolus ; cela encourage non seulement l’itération des algorithmes, mais laisse également une marge de jugement aux experts cliniques, aux patients et aux institutions.
Pour les établissements médicaux, la liste doit proposer des choix limités ; pour les équipes d’algorithmes, cela doit servir à des améliorations localisables ; pour les fournisseurs de services de données, cela devrait servir une boucle fermée de tâches, de preuves et de qualité ; pour les patients, cela devrait réduire le risque de confondre des réponses fluides avec des conclusions sûres. La compétition en matière d’IA médicale ne doit pas seulement porter sur celui qui obtient le meilleur score dans la banque de questions, mais aussi sur celui qui peut fournir une aide stable, transparente et responsable dans un objectif clair, et savoir quand s’arrêter lorsque les preuves sont insuffisantes.
*Cet article traite des méthodes d’évaluation et de recherche de l’IA médicale. Il ne constitue pas un diagnostic clinique et des recommandations de traitement, des conclusions sur l’enregistrement d’un dispositif médical ou une certification de l’efficacité clinique d’un modèle.*
Questions fréquentes
Références
[1] Jin D, Pan E, Oufattole N et al. De quelle maladie est atteint ce patient ? Un ensemble de données de réponses à des questions de domaine ouvert à grande échelle provenant d'examens médicaux. *Sciences appliquées*. 2021;11(14):6421. DOI : 10.3390/app11146421
[2] Jin Q, Dhingra B, Liu Z, Cohen WW, Lu X. PubMedQA : Un ensemble de données pour la réponse aux questions de recherche biomédicale. *EMNLP-IJCNLP*. 2019 : 2567-2577. Anthologie ACL ACL Anthology
[3] Arora RK, Wei J, Hicks RS et al. HealthBench : Évaluation de grands modèles linguistiques pour une meilleure santé humaine. 2025. Article · Description et données du projet
[4] Schmidgall S, Ziaei R, Harris C et al. AgentClinic : une référence d'agents multimodaux pour évaluer l'IA dans des environnements cliniques simulés. 2024. arXiv:2405.07960
[5] Jiang Y, Black KC, Geng G et al. MedAgentBench : un environnement DSE virtuel pour comparer les agents médicaux LLM. *NEJM IA*. 2025 ;2(9). DOI : 10.1056/AIdbp2500144
[6] Bedi S, Liu Y, Orr-Ewing L et al. MedHELM : évaluation holistique des grands modèles de langage pour les tâches médicales. 2025. arXiv:2505.23802 Classement · Stanford HELM
[7] Worth JE, Perez A, Wu DJH et al. État de l’IA clinique en 2026. *BMJ Digital Health & AI*. 2026;2(1):e000113. Texte intégral du journal Texte intégral
[8] Wu D, Nateghi Haredasht F, Kumar Maharaj S et al. Tout d’abord, faites NOHARM : vers des modèles de langage étendus cliniquement sûrs. 2025. arXiv :2512.01241, préimpression
[9] Pan J, Jian B, Hager P et al. Combler les lacunes en matière d'analyse comparative dans les grands modèles linguistiques pour la santé et la médecine grâce au Dynamic Red-Teaming. *Nature Santé*. 2026. DOI : 10.1038/s44360-026-00152-8
[10] Gallifant J, Afshar M, Ameen S et al. La ligne directrice de rapport TRIPOD-LLM pour les études utilisant de grands modèles de langage. *Médecine naturelle*. 2025 ; 31 : 60-69. DOI : 10.1038/s41591-024-03425-5
[11] Collins GS, Moons KGM, Dhiman P et al. Déclaration TRIPOD+AI : Conseils mis à jour pour la déclaration des modèles de prédiction clinique qui utilisent des méthodes de régression ou d'apprentissage automatique. *BMJ*. 2024;385 :e078378. DOI : 10.1136/bmj-2023-078378
[12] Vasey B, Nagendran M, Campbell B et al. Lignes directrices en matière de rapport pour l'évaluation clinique précoce des systèmes d'aide à la décision pilotés par l'intelligence artificielle : DECIDE-AI. *BMJ*. 2022;377 :e070904. DOI : 10.1136/bmj-2022-070904
[13] Liu X, Cruz Rivera S, Moher D et al. Lignes directrices pour les rapports d'essais cliniques sur les interventions impliquant l'intelligence artificielle : extension CONSORT-AI. *BMJ*. 2020;370 : m3164. DOI : 10.1136/bmj.m3164
[14] Nori H, Daswani M, Kelly C et al. Diagnostic séquentiel avec des modèles de langage. 2025. arXiv :2506.22405, préimpression
[15] Food and Drug Administration des États-Unis. Fonctions logicielles des appareils compatibles avec l'intelligence artificielle : recommandations en matière de gestion du cycle de vie et de soumission marketing. Projet de lignes directrices, janvier 2025. Page officielle de la FDA
