Resumo: rankings de IA médica para decisões baseadas em evidências
As listas no campo da inteligência artificial médica são frequentemente compactadas em uma tabela classificada por pontuação total. No entanto, num cenário médico, só porque um modelo está à frente nas questões do exame não significa que possa recolher de forma estável o histórico médico, identificar informações em falta, selecionar exames de forma razoável, seguir orientações e expressar incerteza no diagnóstico e tratamento reais, nem significa que seja adequado para ser colocado em serviços de pacientes ou fluxos de trabalho médicos. O verdadeiro valor da lista não é criar um único defensor, mas tornar as capacidades do modelo, os limites das tarefas, os riscos, os custos e os níveis de evidência observáveis, comparáveis e revisáveis. Os benchmarks de perguntas e respostas médicas
permanecem relevantes. MedQA converte perguntas do exame médico americano em tarefas médicas de perguntas e respostas. PubMedQA exige que o modelo combine o resumo do artigo para determinar se a conclusão da pesquisa apóia o problema; eles fornecem um ponto de partida repetível para a cobertura do conhecimento médico e capacidade de leitura de pesquisas [1–2]. Mas a prática clínica não salta diretamente da pergunta para a resposta. Os pacientes não apresentam as informações na ordem dos livros didáticos, nem todos os testes são conhecidos, vários diagnósticos podem ser razoáveis simultaneamente e as decisões são influenciadas pelo tempo, recursos, preferências do paciente e tolerância ao risco.
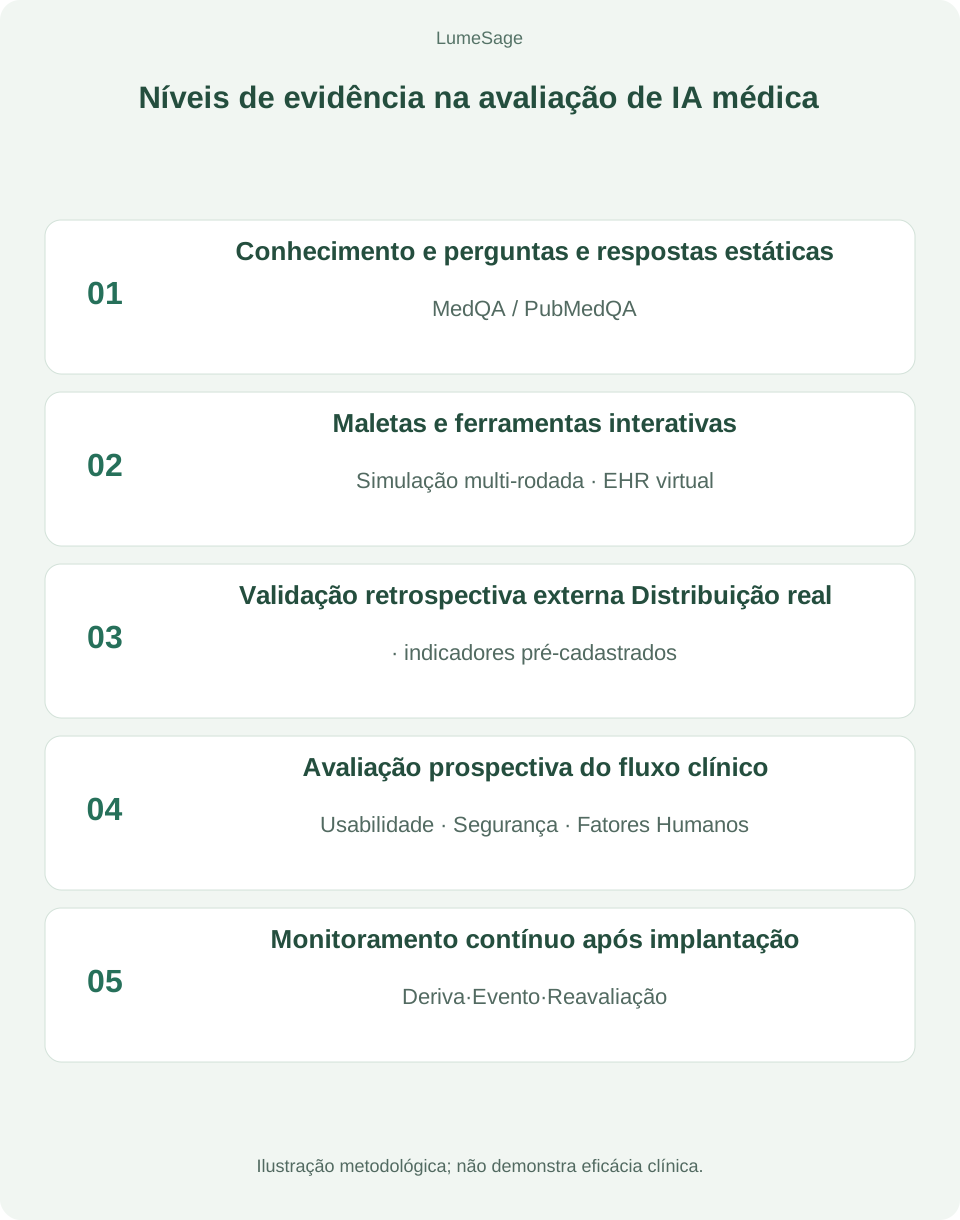
O trabalho de avaliação nos últimos anos está expandindo os referenciais médicos para tarefas mais próximas do trabalho real: o HealthBench usa rubricas escritas por médicos para avaliar conversas abertas e multifacetadas sobre saúde; AgentClinic coloca consultas, uso de ferramentas e informações incompletas em ambientes clínicos simulados; O MedAgentBench permite que os agentes concluam tarefas por meio de um ambiente virtual de prontuário eletrônico que esteja em conformidade com o FHIR; MedHELM organiza vários benchmarks médicos com base em um sistema de classificação de tarefas [3–6]. A revisão da IA clínica de 2026 apontou ainda que questões padrão, casos simulados, validação retrospectiva e avaliação clínica prospectiva estão em diferentes níveis de evidência e não podem substituir uns aos outros [7].
Este artigo é baseado em um plano de construção de ranking de modelos de IA médica, com foco na análise de múltiplas rodadas de consulta, simulação de feedback de exame, codificação de CDI, base de diretrizes, contabilidade de custos, avaliação de especialistas duplo-cega e design colaborativo homem-máquina. A solução tem um claro valor de engenharia, mas também há questões científicas que devem ser corrigidas primeiro: as pontuações dos modelos internos não podem ser usadas diretamente como classificações públicas quando o tamanho da amostra, a versão, as palavras de alerta, as regras de pontuação e os intervalos de confiança estão incompletos; resultados de exames faltantes não podem ser preenchidos silenciosamente como “negativos” pelo simulador; a lista real de registros médicos não deve ser usada como padrão-ouro para diagnóstico e tratamento por padrão.
Este artigo propõe um caminho de construção mais robusto: primeiro definir usos e riscos e, em seguida, organizar casos originados, autorizados e representativos; estabelecer uma escada de evidências entre questões estáticas, simulações interativas, verificação externa retrospectiva e possíveis pilotos; relatar ao mesmo tempo sobre correção, segurança, calibração, utilização de recursos, usabilidade e desempenho de colaboração homem-máquina; e, finalmente, manter a lista com dados versionados, pontuação auditável e testes contínuos da equipe vermelha. Para a LumeSage, essa direção pode conectar engenharia de dados, anotação médica, revisão especializada, gerenciamento de qualidade e avaliação privada em um processo de serviço verificável, em vez de empacotar “ter dados” ou “estar na lista” como resultados clínicos.
1. Por que notas em exames não comprovam competência clínica
1. Perguntas de conhecimento médico medem fatias de habilidade O benchmark de questões médicas de múltipla escolha
é adequado para testar extração de conhecimento, análise de conceitos e processos de raciocínio limitado sob questões claras. Suas vantagens são que os formatos de perguntas e respostas são relativamente estáveis, fáceis de reproduzir, fáceis de estabelecer linhas de base e adequados para observar alterações de modelo com atualizações de versão. O problema é que a estrutura das questões do teste condensa a tarefa clínica em “informações fornecidas – escolha uma resposta”. O modelo não precisa fazer perguntas, decidir se vai testar ou indicar quais informações são insuficientes para apoiar uma conclusão.
Perguntas e respostas baseadas em pesquisa também têm seus próprios limites de tarefas. O PubMedQA organiza perguntas, contexto abstrato e conclusões em julgamentos de sim/não/talvez, o que é adequado para testar leitura e indução de evidências, mas não se pode inferir que o modelo seja capaz de lidar com informações conflitantes em registros médicos ou na comunicação real médico-paciente. Referir-se diretamente aos resultados dos testes como “competência clínica” é extrapolar os resultados de uma tarefa restrita para outra tarefa de sistemas complexos.
2. A tomada de decisão clínica é um processo sequencial
O diagnóstico e o tratamento reais envolvem uma série de escolhas interativas: o que perguntar primeiro, quando fazer o acompanhamento, se testar, como interpretar novos resultados, se revisar o diagnóstico diferencial, quando interromper o teste e quando solicitar revisão. A pesquisa da AgentClinic transformou questões estáticas de MedQA em múltiplas rodadas de interações e descobriu que a dificuldade da tomada de decisão sequencial aumentaria significativamente; O MedAgentBench colocou um conjunto de tarefas em um ambiente virtual de prontuário eletrônico, exigindo que o modelo leia ou opere registros médicos estruturados por meio de chamadas de ferramentas [4–5]. Esses trabalhos lembram que a capacidade de um modelo de responder perguntas e a capacidade de um modelo de completar um processo são dois tipos diferentes de habilidades.
3. O custo dos erros médicos é assimétrico
A falta de um sinal crítico, a fabricação de um resultado de inspeção que não foi realizado e a proposta de medidas desnecessárias de alto risco não podem ser deduzidas de acordo com os mesmos padrões que uma redação inadequada. A precisão geral pode mascarar lapsos de segurança de baixa frequência, mas de altas consequências. Os parâmetros de referência de segurança, como o NOHARM, tomam a “frequência e gravidade dos danos potenciais” como um objeto de avaliação especial; sua pesquisa ainda deve ser interpretada de acordo com os casos e a gama de anotações do próprio artigo, mas ilustra claramente que segurança não é sinônimo de pontuações de conhecimento médico [8].
4. Os padrões médicos envelhecerão e poderão ficar “cozidos”
Quando o banco de questões públicas é usado muitas vezes para treinamento, otimização de palavras imediatas e seleção de modelo, a pontuação da lista pode refletir mais a familiaridade do modelo com a distribuição de questões do que sua capacidade de generalização ao enfrentar novos casos. Os conjuntos de testes estáticos também podem perder rapidamente a distinção devido à iteração do modelo muito rapidamente. Dynamic Red Teaming Research 2025 e seu trabalho de revista de 2026 demonstram o valor de prompts de mutação contínua, cenários adversários e testes de estresse de segurança, além de testes estáticos [9]. Os testes dinâmicos não são uma solução universal: se as regras de ataque para cada rodada não forem transparentes ou reproduzíveis, será difícil comparar as pontuações. Portanto, é prudente usar conjuntos públicos fixos para linhas de base reproduzíveis, conjuntos ocultos controlados, validação fora do tempo e red teaming dinâmico para verificações de novidade e robustez, e divulgar claramente as perguntas respondidas por cada pontuação.
2. Dos benchmarks estáticos à avaliação dos fluxos clínicos
1. De respostas de perguntas únicas a conversas reais As informações originais do projeto
HealthBench mostram que o benchmark inclui 5.000 diálogos de saúde, que foram construídos por 262 médicos que atuaram em 60 países, e uma rubrica de pontuação item por item foi projetada para respostas modelo; a informação oficial afirma claramente que o diálogo pode ser multiturno, multilíngue e também abrange cenários entre usuários comuns e profissionais médicos [3]. Portanto, a descrição do HealthBench como “todas as conversas de um só turno” nos materiais do programa precisa ser corrigida. A chave aqui não é se um determinado índice de referência é “o mais avançado”, mas que a introdução do índice de referência deve voltar ao documento original e verificar a descrição oficial dos dados, e não pode confiar em tabelas de segunda mão.
Os médicos escrevem rubricas item por item para ajudar a evitar a avaliação de respostas médicas abertas apenas com correspondência de palavras-chave. Mas a cobertura das rubricas, os pesos, os limites de decisão e as classificadoras automáticas ainda precisam ser verificados. O trabalho original no HealthBench também usou marcadores de modelo e fez com que os médicos os revisassem quanto à consistência com os julgamentos humanos; tais métodos são adequados para expansão, mas não devem ser interpretados como "os juízes do LLM são naturalmente objetivos".
2. De casos estáticos a ambiente interativo
AgentClinic configura funções como médicos, pacientes e ferramentas de medição em um ambiente simulado para oferecer suporte a informações incompletas, múltiplas rodadas de interação e uso de ferramentas [4]. MedAgentBench fornece ainda 300 tarefas clínicas, 100 arquivos de pacientes e um ambiente EHR virtual compatível com FHIR [5]. Eles expandem o objeto de avaliação de uma resposta de texto para “se o modelo pode concluir a ação especificada em um determinado ambiente”.
O valor do ambiente de simulação reside em sua controlabilidade, repetibilidade e capacidade de gravação; sua limitação é a lacuna entre o simulador do paciente, o simulador do exame, a estrutura de dados do prontuário médico e o sistema médico real. O artigo do MedAgentBench também mencionou claramente que o ambiente virtual não pode ser usado diretamente como um sistema de produção e apontou que existem limites nas fontes de dados e na cobertura de tarefas. Para benchmarks autoconstruídos, o ambiente do agente não deve apenas perguntar "se a tarefa foi concluída", mas também registrar chamadas de ferramentas, alterações de status, operações não autorizadas, solicitações inválidas, verificações repetidas e pontos de terminação.
3. De “uma grande lista” ao pedigree de tarefas
MedHELM organiza grandes avaliações de modelos médicos em 5 categorias principais, 22 subcategorias e 121 tarefas, e reúne vários benchmarks novos e existentes [6]. Essa estrutura ilustra melhor o que o modelo é ou não é adequado do que esmagar diagnóstico, geração de registros médicos, comunicação com o paciente, pesquisa médica e processos administrativos em uma única pontuação. A inspiração é: o primeiro nível da lista deveria ser a classificação dos usos, e o segundo nível deveria ser a comparação de modelos.
Por exemplo, resumos de registros clínicos e educação do paciente pertencem a diferentes cenários de risco; extração de relatórios de testes, recomendações diagnósticas e agendamento de recursos médicos não devem compartilhar o mesmo conjunto de pesos de avaliação. Para uma lista orientada para um propósito específico, os usuários-alvo, as informações de entrada, as ferramentas permitidas, a saída do sistema, as responsabilidades da revisão manual e os custos de falha devem ser fixados primeiro e, em seguida, as dimensões de pontuação devem ser determinadas.
4. Da classificação única ao monitoramento contínuo Os sistemas de IA clínica
podem contar com APIs de modelo, palavras de prompt, bibliotecas de pesquisa, cadeias de ferramentas e estratégias de interação humano-computador. Apenas relatar “nome do modelo + pontuação” não é suficiente para reproduzir um sistema. O TRIPOD-LLM em 2025 lembra aos pesquisadores que relatem informações como cenários de uso, modelos e versões, engenharia imediata, processamento de dados, qualificações de revisão humana e controle de qualidade; TRIPOD+AI, DECIDE-AI e CONSORT-AI fornecem estruturas de relatórios correspondentes para relatórios de modelos preditivos, avaliação inicial de cenários da vida real e ensaios clínicos de intervenção de IA, respectivamente [10–13]. Estas diretrizes não constituem aprovação clínica ou certificação de qualidade, mas ilustram que a notificação transparente é a base para a comparabilidade e reprodutibilidade académicas.
3. Análise da proposta: viabilidade, limitações e melhorias
1. Registros médicos reais e informações complexas: a direção está correta e a origem e representatividade da amostra precisam ser claras O esquema
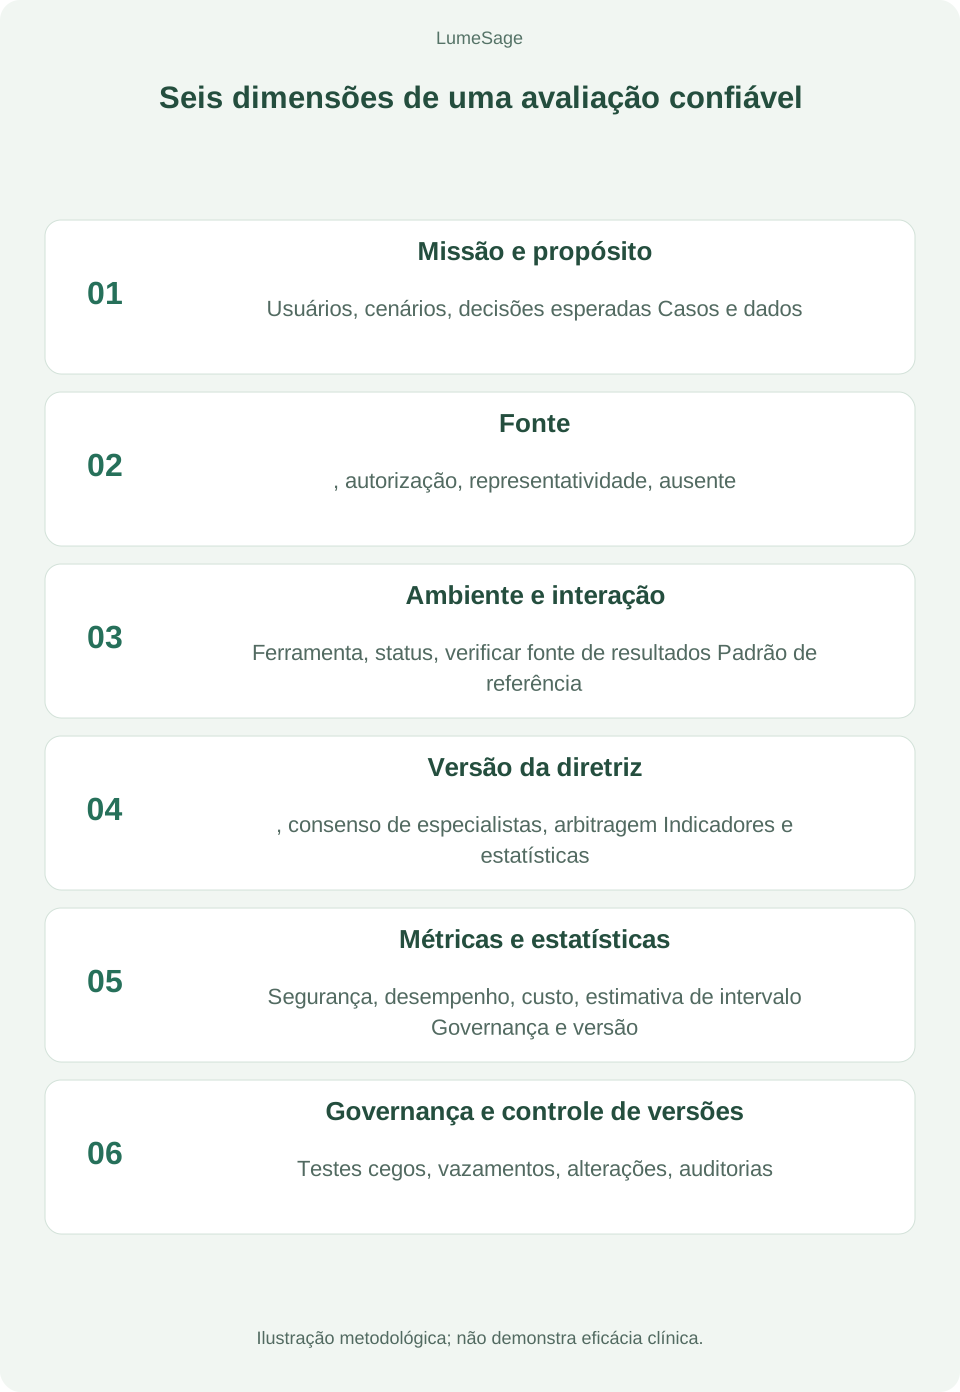
recomenda que registros médicos, exames e informações de exames reais estruturados sejam usados para melhorar a abundância de informações clínicas, o que é uma direção necessária. Os textos clínicos contêm abreviações, omissões, erros de digitação, intervalos de tempo e contradições entre documentos, tornando difícil para os casos sintéticos cobrir toda a verdadeira complexidade. A utilização de dados reais também deve explicar: fontes de dados e âmbito de autorização, desduplicação ao nível do paciente, proteção da privacidade, critérios de inclusão e exclusão, distribuição institucional e populacional, taxas de doença e gravidade, mecanismos em falta e se existem problemas com o mesmo paciente em conjuntos de treino/teste.
“Real” não significa “representante”. Os dados de grandes hospitais ou departamentos individuais não podem ser extrapolados naturalmente para comunidades, diferentes regiões e diferentes grupos linguísticos. As medições devem reportar o desempenho por ambiente clínico, instituição, faixa etária, género, subtipo de doença e principal grupo de risco; quando há amostras disponíveis insuficientes, a incerteza deve ser explicitada, em vez de tratar as pontuações de grupos amostrais baixos como classificações confiáveis.
2. Simulação de resultados de inspeção: pesquisas podem ser feitas, mas incógnitas não podem ser disfarçadas de negativas O plano
propõe que quando o caso original não fornecer o exame solicitado pelo modelo, o “agente examinador” irá prever o resultado. Isto pode ajudar a construir cenas interativas, mas também é o elo mais arriscado em todo o design técnico. Nos dados do mundo real, “sem inspeção” significa que o resultado é desconhecido, o que não significa que o resultado seja normal; se o simulador gerar um resultado aparentemente razoável e retorná-lo diretamente ao modelo em teste, o teste passará de "tomada de decisão sob informações incompletas" para "tomada de decisão sob informações escritas manualmente", o que pode induzir conclusões errôneas e fazer com que os resultados do teste dependam do desvio do próprio simulador.
recomenda que o status da informação seja estritamente diferenciado em: resultados observados, claramente não realizados, inatingíveis e geração simulada. Os resultados da simulação são retornados apenas dentro de uma tarefa de estudo do simulador separada, e sua fonte de geração, nível de confiança, aplicabilidade e verificação de distribuição verdadeira são preservados em segundo plano. A lista principal pode ser configurada com duas faixas: uma apenas pontua informações determinísticas do caso; o outro utiliza um simulador ambiental verificado externamente com dados reais para avaliar a forma como o modelo lida com resultados incertos. Simuladores não devem ser usados como geradores invisíveis de fatos clínicos.
3. CID-10 e pontuação padronizada: É útil para padronizar registros, mas não significa estabelecer um padrão ouro para diagnóstico.
Mapear diagnósticos para códigos como CID-10 é útil para estatísticas hierárquicas, agregação de categorias e revisão entre equipes, mas a correspondência de código só pode responder "onde o sistema codifica a conclusão?" e não pode responder de forma independente "se o julgamento clínico está correto". Os níveis de codificação podem ser demasiado grosseiros, múltiplas conclusões podem ser justificadas e os diagnósticos podem mudar ao longo do tempo e com novos testes. A abordagem correta é usar a codificação como um campo auxiliar computável, mantendo registros de conceitos clínicos, evidências, diagnósticos alternativos aceitáveis, hierarquia diagnóstica e julgamento de especialistas.
O padrão de referência deve ser estabelecido por médicos com experiência especializada correspondente com base em dados de casos e diretrizes aplicáveis; se necessário, duas pessoas devem marcá-lo de forma independente, arbitrá-lo por um terceiro e registrar as diferenças. Para os casos em que existem múltiplos caminhos clinicamente razoáveis, a pontuação deve reconhecer um conjunto predefinido de respostas aceitáveis, em vez de tratar um único código de alta como a única resposta correta.
4. Consistência da diretriz: caminho de avaliação, mas bloqueie a versão e o grupo aplicável
Incorpora diretrizes, caminhos clínicos e consenso de especialistas para fornecer uma justificativa para a escolha deste teste ou tratamento. O protocolo de avaliação deve fixar o nome da diretriz, versão, data de lançamento, população aplicável e força da recomendação; caso contrário, o modelo poderá ser pontuado com uma recomendação desatualizada ou inadequada para o paciente. As diretrizes também não podem esgotar as preferências, contraindicações, disponibilidade de recursos e incertezas clínicas de cada paciente.
sugere dividir a consistência das diretrizes em três questões verificáveis: se as principais etapas necessárias foram omitidas; se as etapas executadas possuem indicações correspondentes; se o modelo expressa incerteza e propõe um caminho de atualização razoável quando as evidências são insuficientes ou não são cobertas pela diretriz.“Mencionar palavras-chave na diretriz” não pode ser considerado como “seguir a diretriz”, nem deve a fluência do processo de raciocínio ser diretamente equiparada à correção clínica.
5. Avaliação de custos: Incluir a economia na lista é um progresso, mas um preço único não pode substituir o valor clínico.
propõe calcular o consumo de recursos com base nos preços de fiscalização, podendo identificar a estratégia pouco razoável de “inspeções ilimitadas para aumentar a informação”. Isso é consistente com a orientação do Sequential Diagnosis Benchmark de colocar o diagnóstico sequencial e os custos do exame no mesmo ambiente de avaliação [14]. Porém, o preço dos serviços médicos depende da região, hospital, sistema de pagamento, seguro do paciente e combinações específicas de exames; a lista de preços só pode ser uma aproximação em um determinado momento e cenário, e não um valor de custo verdadeiro e universal.
Uma abordagem de relatório mais robusta seria apresentar simultaneamente o desempenho do diagnóstico, o risco de diagnóstico perdido, o exame excessivo, o número de exames, a faixa de custo, o tempo de espera, a carga médica adicional e a incerteza. Desenhe a fronteira “risco-efeito-custo” para diferentes modelos para explicar em que utilizações, limites e ambientes de pagamento uma determinada solução é mais adequada, em vez de declarar diretamente que um modelo é “o mais rentável”. Se não houver base para ponderação de utilidade clínica ou análise de decisão, múltiplos indicadores não devem ser convertidos à força num único ROI.
6. Estabilidade e pass@k: devem ser definidos com precisão, sem amostragem repetida para substituir a confiabilidade única
Os sistemas médicos geralmente enfrentam uma solicitação real quando implantados, portanto, pass@1 reflete se uma única execução pode concluir a tarefa; pass@k geralmente enfatiza a probabilidade de pelo menos um sucesso entre várias tentativas, e a probabilidade de "k todos os sucessos" ou a variação das pontuações entre as execuções é outro indicador de estabilidade. Pass@k e pass^k no esquema precisam ser claramente definidos um por um no protocolo de papel, e o número de repetições, sementes aleatórias, temperatura, estratégia de amostragem e algoritmo de resumo de cada caso devem ser anotados.
Se o modelo puder ser repetido em cenários reais, o sistema poderá exibir a melhor resposta ao usuário, mas esta abordagem alterará o atraso, o custo e o risco e deverá ser avaliada separadamente. A qualidade pós-treinamento ou a estabilidade clínica não podem ser inferidas diretamente apenas pela diferença entre pass@k e pass@1; as diferenças estatísticas também levam em consideração o tamanho da amostra, os intervalos de confiança, o agrupamento de casos e os planos de análise predeterminados. Todas as classificações devem fornecer intervalos de incerteza e evitar interpretar as trocas de classificação em pequenas amostras como diferenças geracionais na capacidade.
7. LLM-as-a-Judge: Expanda os recursos de anotação, retenha calibração e auditoria especializada
O árbitro LLM é adequado para verificação de formato, verificação parcial de fatos, triagem preliminar de rubricas e pontuação auxiliar de grandes amostras. No entanto, pode preferir respostas mais longas, mais confiantes e redigidas mais de acordo com o seu próprio resultado, ou pode partilhar os mesmos pontos cegos de conhecimento com o modelo que está a ser testado. Estudos como HealthBench e MedHELM demonstraram a prática de avaliadores de rubricas e modelos, e também ilustraram a necessidade de comparar a consistência entre os avaliadores e os julgamentos de especialistas clínicos [3,6].
recomenda o uso de pontuação hierárquica: regras determinísticas são usadas para itens verificáveis programáveis; os fatos médicos e os principais pontos de segurança são revisados usando fontes citadas, regras e especialistas clínicos; a experiência de comunicação e a adequação do programa são avaliadas por meio de análises clínicas cegas treinadas. Uma certa proporção de cada lote de amostras é selecionada para pontuação independente por duas pessoas, e o índice de consistência, a taxa de desacordo e o status de arbitragem são relatados. O nome e a versão do modelo de referência, as palavras de alerta, a temperatura de pontuação, a versão da rubrica e as amostras de calibração também são congeladas e arquivadas.
8. Plataforma especialista duplo-cega: necessidade de evitar cegamento, efeitos de ordem e fadiga de pontuação A comparação de casos, perguntas e respostas de modelo duplo e plataformas de teste cego aleatório projetadas no plano
são operáveis. Para tornar os resultados confiáveis, o cegamento não pode depender apenas da ocultação dos nomes dos modelos: o formato de saída precisa ser unificado, as tags de estilo do fornecedor e do modelo removidas e a ordem das respostas randomizada; os revisores não devem saber a origem das respostas ou a sua posição na lista; duas respostas de modelo para o mesmo caso não devem revelar pistas emparelhadas na interface. Treinamento de revisão, controle de fadiga, detecção de perguntas duplicadas, limite de tempo de pontuação, questionário de adivinhação cega e revisão de objeções devem ser configurados.
As avaliações clínicas de especialistas também não são “naturalmente imparciais”. Os julgamentos dos riscos aceitáveis podem diferir entre especialidades, anos de experiência e ambientes de prática. Os estudos devem relatar as qualificações dos revisores, a distribuição de especialidades, os métodos de correspondência de tarefas de casos, a consistência entre os revisores e os processos de arbitragem, e estabelecer mecanismos de participação para as preocupações dos pacientes e do público. DECIDE-AI enfatiza a praticidade clínica, segurança, fatores humanos e preparação para novos ensaios na avaliação clínica precoce; isso nos lembra que a avaliação clínica real deve se concentrar nos usuários, no fluxo de trabalho e na iteração do sistema, e não apenas nas pontuações das respostas do modelo [12].
4. Uma metodologia confiável para avaliar a IA médica
1. Faça primeiro o “Cartão de Propósito” e depois escreva as perguntas
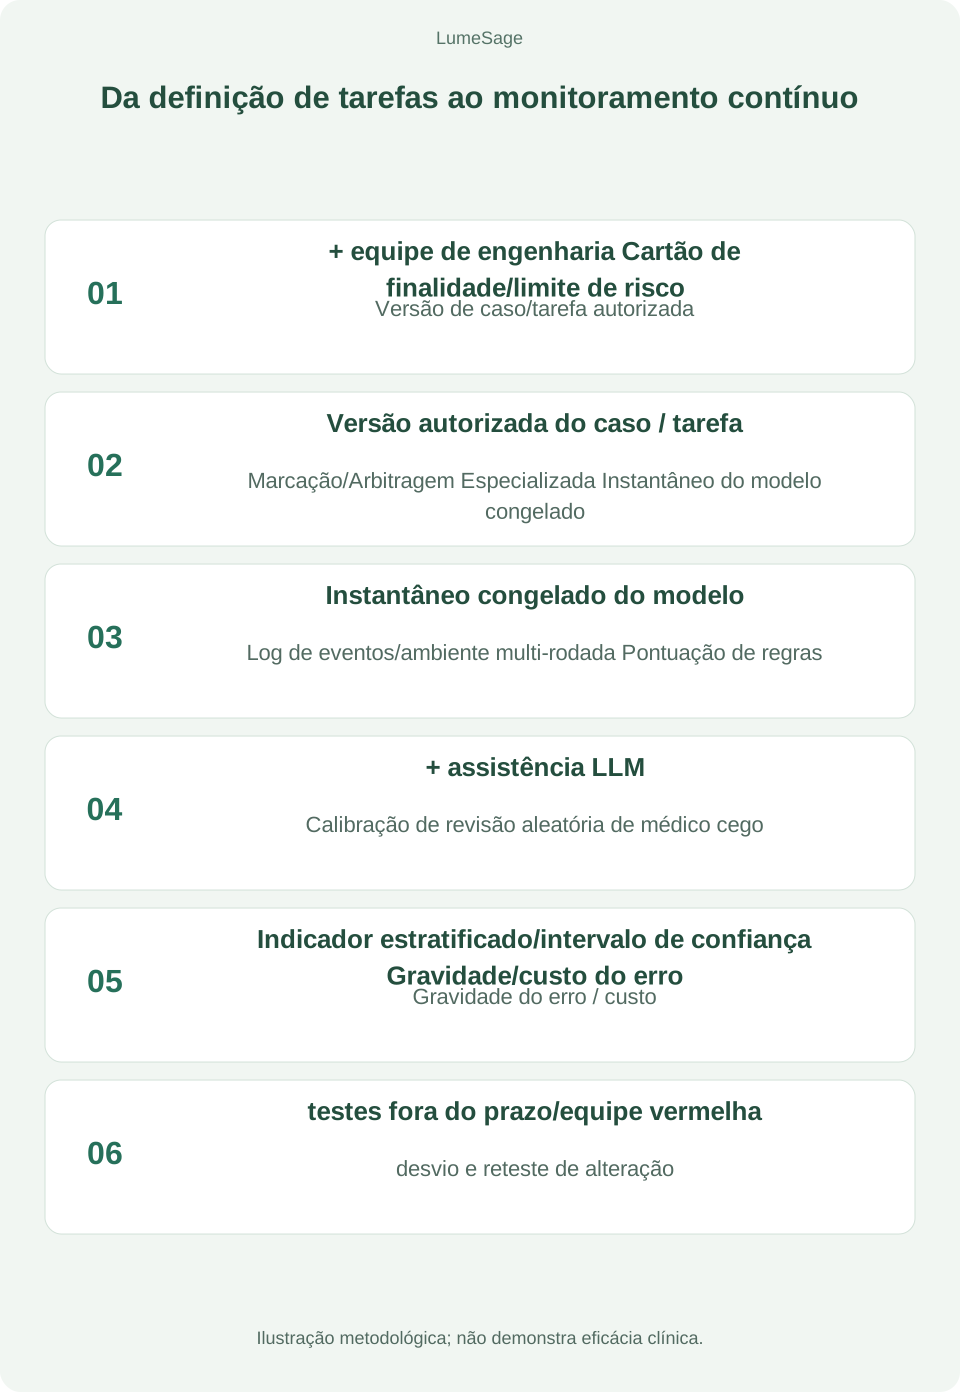
Para cada subitem da lista, primeiro preencha o cartão de finalidade: quem é o usuário alvo; que tipo de pacientes e problemas clínicos são atendidos; qual o papel que o modelo desempenha; quais dados podem ser incluídos na entrada; se o resultado afeta as decisões médicas reais; se a recuperação, ferramentas ou registros médicos eletrônicos podem ser chamados; quem conduzirá a revisão final; que dano será causado pelo fracasso. Os cartões de finalidade determinam tarefas, níveis de risco, métricas de medição e texto de divulgação. Na ausência de uma definição de finalidade, a lista não pode explicar o que a pontuação significa para aquisição ou implantação clínica.
2. Estabeleça o pedigree do caso e o cartão de dados
Cada caso registra pelo menos identificação anonimizada do paciente/consulta, tipo de tarefa, doença e gravidade, fonte de informação, momento, campos estruturados, associação entre documentos e exames, base de rotulagem, versão da diretriz aplicável, status ausente, regras de inclusão/exclusão de caso e conjunto de respostas aceitáveis. A divisão em nível de caso deve evitar o mesmo paciente, a mesma consulta ou documentos quase duplicados abrangendo treinamento, ajuste de parâmetros e conjuntos de testes. O conjunto de testes deve reter a versão e a linhagem dos dados; auditorias regulares de poluição devem ser realizadas no conjunto público, e o controle de acesso e registros de auditoria devem ser implementados no conjunto oculto.
3. Cartão de tarefas de design e status do ambiente
descreve cada tarefa como: informações iniciais, perguntas que o modelo pode fazer, ferramentas disponíveis, regras de retorno do ambiente, condições de encerramento, operações permitidas, operações proibidas e riscos predefinidos. As tarefas sequenciais devem preservar diálogos completos e rastreamentos de ferramentas, distinguindo entre modelos sem consultas, ambientes sem dados, verificações não realizadas e resultados desconhecidos. Caso pacientes simulados ou agentes fiscalizadores participem do teste, seu processo de verificação e modo de falha deverão ser divulgados; o ambiente de simulação não pode vazar rótulos para o modelo em teste, nem novos fatos que não cumpram as regras de transição de estado podem ser gerados apenas porque o modelo em teste precisa de mais algumas rodadas.
4. Use o painel de indicadores em vez da pontuação total única Recomenda-se que
seja dividido em pelo menos seis grupos de indicadores: Desempenho da tarefa
1. Desempenho da tarefa: Precisão de diagnóstico ou decisão, cobertura de etapas principais, integridade de extração estruturada, taxa de conclusão de tarefas.2. Segurança do Paciente Erro grave, omissão perigosa, manuseio excessivo, falso conforto, negligência tabu, exame ou cotação fictícia.3. Qualidade do processo Eficiência na coleta de informações, seleção de inspeção, operações repetidas, chamada correta da ferramenta e se deve parar no momento apropriado.4. Incerteza Incerteza: Erro de calibração, estratificação de risco, adequação da mão de obra de rejeição/atualização, relação entre previsão seletiva e cobertura.5. Utilização de recursos Uso de recursos: Benefícios clínicos em custo, atraso, número de exames, tempo de revisão manual e restrições de recursos.6. Generalização Generalização: Desempenho ao longo do tempo, fora da instituição, subgrupos, diferentes qualidades de entrada, variantes de linguagem e perturbações adversárias.
Deve haver um limite mínimo para desempenho de segurança; modelos com falhas graves de segurança não devem ser “compensados” pela pontuação geral devido a pontuações altas em tarefas de baixo risco. A lista pode fornecer uma visão ponderada relevante para o objectivo, mas os pesos, limiares e análise de sensibilidade devem ser divulgados, e cada indicador original deve ser retido para revisão dos leitores.
5. Plano estatístico de pré-registro e relatório de versão
Antes de executar o modelo, primeiro anote o endpoint primário, o endpoint secundário, a base do tamanho da amostra, o objeto de comparação, o intervalo de confiança, o processamento de dados ausentes, a análise estratificada, o processamento de comparação múltipla e as regras de parada. Os resultados das tarefas podem ser agrupados de acordo com casos, pacientes e instituições para calcular intervalos; comparações multimodelos para o mesmo caso devem usar análise pareada apropriada para evitar tratar os testes de cada modelo como independentes um do outro. Versões de modelos e palavras de prompt, temperatura, permissões de ferramentas, fontes de pesquisa, datas de API, configurações de software e hardware e fontes de preços devem ser mantidas em arquivo. Após a atualização do fornecedor do modelo, não use diretamente a classificação antiga. Você deve marcar o instantâneo e reavaliar.
6. O benchmark público adota a estrutura paralela de "conjunto de desenvolvimento-conjunto de validação-conjunto oculto-conjunto dinâmico" O conjunto de desenvolvimento
é usado para depuração da comunidade, o conjunto de verificação suporta calibração de parâmetros e regras de pontuação, o conjunto oculto reduz o ajuste excessivo ao alvo de teste e o conjunto dinâmico da equipe vermelha testa novos ataques e mudanças de distribuição. Cada um dos quatro tipos de dados tem seus próprios usos e não devem ser combinados em um misterioso “conjunto de testes total”. Se as amostras de casos forem tornadas públicas, deve ser avaliado o risco de serem incluídas nos motores de busca e no subsequente corpus de formação; rótulos-chave, rubricas completas ou casos ocultos não precisam ser tornados públicos, mas os protocolos de avaliação, resumos estatísticos, códigos ou interfaces auditáveis devem ser tornados públicos e os procedimentos de acesso dos pesquisadores devem ser estabelecidos.
5. Quatro etapas do protótipo à evidência clínica
Fase 0: Definição de limites e governança, aproximadamente 4–6 semanas
Primeiro escolha uma tarefa de entrada específica, verificável e de baixo risco, como "verificação de integridade de informações de documentos clínicos" ou "extração de campo de relatório de imagem específico", em vez de começar com "avaliar toda IA médica". Estabelecer uma equipe com participação clínica, algoritmo, estatística, proteção de dados e produtos; formar cartão de finalidade, análise de risco, lista de autorização de dados, especificações de rotulagem de casos, manual de pontuação e plano estatístico de pré-registro. Os limites do estágio são: a origem do caso é clara, os usos permitidos são claros e os padrões de avaliação podem ser realmente usados por dois especialistas independentes.
Fase 1: Linha de base estática e anotação cega, aproximadamente 6–10 semanas
Construa um conjunto de conjuntos de desenvolvimento e conjuntos de verificação independentes para iteração; selecione instantâneos de modelos públicos e interfaces de modelos privados e congele palavras e configurações de prompt. Primeiro avaliamos o desempenho das tarefas, os tipos de erros, o desempenho hierárquico e a consistência entre árbitros automáticos e pontuações de especialistas, e não buscamos a divulgação única de uma "classificação nacional". Os limites do estágio são: os principais indicadores podem ser repetidos, existe um processo de arbitragem para pontuar disputas e erros graves de segurança podem ser atribuídos a casos e evidências.
Fase 2: Ambiente interativo e validação externa, aproximadamente 8–14 semanas
Coloque tarefas de consulta, tomada de decisão em exames ou operação de registros médicos em um ambiente de simulação isolado. O status do paciente, os resultados dos exames, as interfaces das ferramentas, os prazos e os custos de recursos são todos salvos; os dados simulados são estritamente separados dos dados de observação reais. No mínimo, a validação é repetida em casos de retirada de terras de diferentes fontes ou períodos de tempo, e a configuração e a rotulagem são revistas por uma equipa clínica independente. Os limites do estágio são: o simulador possui relatórios de validação, as lacunas de desempenho entre fontes são quantificadas e nenhuma informação sintética não rotulada é misturada aos fatos clínicos.
Fase 3: Piloto de fluxo de trabalho real em pequena escala e monitoramento contínuo
Se a tarefa afetar as decisões médicas reais, ela deverá entrar em uma avaliação prospectiva em pequena escala, apoiada pela ética, privacidade e governança institucional, e ser posicionada como "assistida" em vez de "execução automatizada". Registre se os médicos observaram e agiram de acordo com as recomendações, duração do uso, modificação de comportamento, frequência de escalonamento manual, possíveis eventos adversos, carga de trabalho e desempenho em diferentes subgrupos. Relate de forma transparente de acordo com as orientações aplicáveis, como DECIDE-AI, e selecione as especificações apropriadas com base no tipo de estudo específico. Estudos clínicos em larga escala ou vias de produção são discutidos somente depois que os limites predefinidos de segurança e eficácia são atingidos. O rascunho do ciclo de vida do software de dispositivos médicos de IA lançado pela FDA em 2025 fornece sugestões para gerenciamento de risco e materiais de arquivamento para produtos relacionados, mas o documento é marcado como um rascunho e não vinculativo, e não deve ser descrito como uma aprovação completa ou uma conclusão regulatória de aplicação geral [15].
O período para as Fases 0–3 é apenas um intervalo de planejamento do projeto e não é um compromisso de entrega garantido; o período real depende da cooperação institucional, revisão ética, autorização de dados, volume de casos, recursos de revisão e usos específicos. O orçamento deve ser dividido em governança de dados, especialistas clínicos, engenharia, estatísticas, plataforma, auditorias de segurança e manutenção contínua, em vez de apenas estimar por modelo o volume de chamadas.
6. A contribuição dos benchmarks para a assistência à saúde
1. Permitir que instituições médicas escolham modelos mais baseados em
As organizações de saúde podem visualizar as margens de segurança, custos e tipos de erros de um modelo por tarefas específicas, em vez de apostar em uma classificação geral. Para compras, a lista pode transformar "o desempenho da demonstração do modelo é bom" em termos de aceitação verificáveis: escopo de amostra e tarefa, limite de erro grave, limite de tempo de resposta, registros de auditoria, teste de regressão após atualização de versão e mecanismo de atualização quando não puder ser processado.
2. Ajude a equipe do modelo a localizar a direção real da melhoria
Precisão insuficiente pode surgir do conhecimento, coleta de informações, leitura de imagens, invocação de ferramenta, integração contextual, calibração ou apresentação. A classificação de erros e os rastreamentos de processos podem conectar enriquecimento de dados, pós-treinamento, aprimoramento de recuperação, design de ferramentas e políticas de segurança. Para serviços de dados, isso ajuda a mudar de “quantas amostras entregar” para “quais amostras podem preencher qual lacuna de capacidade observável”.
3. Reduzir riscos invisíveis suportados por pacientes e equipes clínicas Se a lista
registrar omissões, operações enganosas, verificações excessivas, ultra-autorizadas e comportamentos incertos, ela poderá ajudar as organizações a definir pontos de revisão manuais antes da implantação. Não garante risco zero, mas pode tornar os riscos conhecidos mais fáceis de identificar, comunicar e gerir.
4. Estabeleça uma base de comparação reproduzível para pesquisa
Tarefas padrão, configurações congeladas, relatórios públicos e auditorias de versão podem reduzir a incomparabilidade causada por "cada um testando o seu" entre diferentes organizações. Os pesquisadores também podem observar o desvio de desempenho do modelo em diferentes tarefas, idiomas, instituições e versões, fornecendo um ponto de partida rastreável para validação externa e pesquisa prospectiva.
5. Deixe que os serviços de dados e a avaliação clínica formem um ciclo fechado
Quando a especificação de dados e a avaliação do modelo são mapeadas, a equipe pode rastrear “atributos do caso – evidência rotulada – falha do modelo – amostras suplementares – resultados de novo teste”. Este ciclo fechado ajuda a distinguir entre qualidade de dados, qualidade de anotação e capacidades do modelo: a falha do modelo não é necessariamente uma falta de dados, e a abundância de dados não produz automaticamente valor clínico. A conclusão da avaliação deve basear-se em tarefas específicas e cartões de dados, em vez de apenas formar uma lista publicitária.
7. LumeSage: processos de avaliação verificáveis
A construção da ranking de modelos de IA médica requer mais do que apenas a capacidade de engenharia para chamar o modelo. Também precisa traduzir objetivos clínicos em especificações de tarefas, incorporar fontes de casos, autorização, dessensibilização e gerenciamento de versões em processos de dados; estabelecer associações rastreáveis para imagens, documentos, testes e amostras multimodais; precipitar anotação de especialidade, revisão, arbitragem de desacordo e pontuação de rubrica em registros auditáveis; e então usar a plataforma de engenharia para concluir a execução automatizada, reprodução de registros, contabilidade de custos e geração de relatórios.
LumeSage pode organizar serviços em torno destes links: classificação de requisitos e uso, design de conjunto de testes, especificações de amostra e cartões de dados, anotação médica e inspeção de qualidade, avaliação cega de especialistas, ambiente de avaliação privado, relatório de benchmark e regressão de versão. O valor dos serviços de avaliação privados, como o Medical Gate, deve ser explicado pelos seus limites reais de tarefas, autorização de dados, participação de especialistas, protocolos de pontuação e evidências de replicação; declarações envolvendo a segurança do paciente ou efeitos clínicos devem ser apoiadas por pesquisas correspondentes e evidências de cenários aplicáveis.
A simulação multiagente, análise de custos, plataforma especializada e pontuação orientada a diagnóstico apresentadas nesta solução são adequadas para uso como rota de pesquisa e desenvolvimento e verificação interna de hipóteses. Antes de divulgar publicamente os resultados do modelo, devem ser preenchidos o número e a origem dos casos, a divisão de dados, os instantâneos do modelo, as palavras de alerta, a temperatura, as ferramentas, o número de repetições por caso, a rubrica de pontuação, a composição dos especialistas, a consistência do árbitro, o intervalo de confiança, a área de custo e o método de cálculo, bem como as informações de pré-registro ou recorrência de código. Na ausência destes materiais, não é apropriado chamar o gráfico interno de uma classificação pública verificada de forma independente; este white paper não divulga as classificações específicas do modelo e os custos de caso único no plano.
Quanto a "A lista médica pode provar que o modelo pode diagnosticar e tratar de forma independente", a resposta deve ser clara: não. O benchmarking fornece evidências off-line para tarefas específicas; a verdadeira usabilidade clínica também depende de validação externa, fluxo de trabalho clínico, fatores humanos, limites regulatórios e estudos prospectivos de segurança e eficácia. A credibilidade da marca da IA médica deve ser estabelecida por limites claros, métodos revisáveis e pela capacidade de questionar os resultados. Conclusão
Conclusão: um mapa de evidências além de uma classificação única
O futuro do benchmark de IA médica não deve ser uma medalha que permanece inalterada por toda a vida, mas um mapa expandido por propósito, população de pacientes, tipo de dados, risco, custo e nível de evidência. Não só permite que os modelos demonstrem progressos em tarefas claras, mas também apresenta problemas não resolvidos; não apenas incentiva a iteração do algoritmo, mas também mantém espaço para julgamento por especialistas clínicos, pacientes e instituições.
Para instituições médicas, a lista deve servir opções limitadas; para equipes de algoritmos, deve servir melhorias locais; para os prestadores de serviços de dados, deve servir um ciclo fechado de tarefas, evidências e qualidade; para os pacientes, deve reduzir o risco de confundir respostas fluentes com conclusões seguras. A competição na IA médica não deve ser apenas sobre quem tem a pontuação mais elevada no banco de questões, mas também sobre quem pode fornecer ajuda estável, transparente e responsável para um propósito claro e saber quando parar quando não há provas suficientes.
*Este artigo é uma discussão sobre avaliação de IA médica e métodos de pesquisa. Não constitui diagnóstico clínico e recomendações de tratamento, conclusões de registro de dispositivos médicos ou certificação da eficácia clínica de qualquer modelo.*
Perguntas frequentes
Referências
[1] Jin D, Pan E, Oufattole N, et al. Que doença esse paciente tem? Uma pergunta de domínio aberto em grande escala que responde a um conjunto de dados de exames médicos. *Ciências Aplicadas*. 2021;11(14):6421. DOI: 10.3390/app11146421
[2] Jin Q, Dhingra B, Liu Z, Cohen WW, Lu X. PubMedQA: Um conjunto de dados para resposta a perguntas de pesquisa biomédica. *EMNLP-IJCNLP*. 2019:2567–2577. Antologia ACL ACL Anthology
[3] Arora RK, Wei J, Hicks RS, et al. HealthBench: avaliando grandes modelos de linguagem para melhorar a saúde humana. 2025. Descrição e dados do projeto Artigo · Visão geral do projeto e dados
[4] Schmidgall S, Ziaei R, Harris C, et al. AgentClinic: uma referência de agente multimodal para avaliar IA em ambientes clínicos simulados. 2024. arXiv:2405.07960
[5] Jiang Y, Black KC, Geng G, et al. MedAgentBench: um ambiente virtual de EHR para avaliar agentes médicos LLM. *NEJM AI*. 2025;2(9). DOI: 10.1056/AIdbp2500144
[6] Bedi S, Liu Y, Orr-Ewing L, et al. MedHELM: Avaliação Holística de Grandes Modelos de Linguagem para Tarefas Médicas. 2025. arXiv:2505.23802 · Tabela de classificação do LEME de Stanford
[7] Worth JE, Perez A, Wu DJH, et al. Estado da IA Clínica em 2026. *BMJ Digital Health & AI*. 2026;2(1):e000113. Texto completo do diário Texto integral
[8] Wu D, Nateghi Haredasht F, Kumar Maharaj S, et al. Primeiro, faça NOHARM: Rumo a grandes modelos de linguagem clinicamente seguros. 2025. arXiv:2512.01241, pré-impressão
[9] Pan J, Jian B, Hager P, et al. Abordando lacunas de benchmarking em grandes modelos de linguagem para saúde e medicina com Dynamic Red-Teaming. *Saúde da Natureza*. 2026. DOI: 10.1038/s44360-026-00152-8
[10] Gallifant J, Afshar M, Ameen S, et al. A Diretriz de Relatórios TRIPOD-LLM para Estudos que Utilizam Grandes Modelos de Linguagem. *Medicina da Natureza*. 2025;31:60–69. DOI: 10.1038/s41591-024-03425-5
[11] Collins GS, Moons KGM, Dhiman P, et al. Declaração TRIPOD+AI: Orientação atualizada para relatar modelos de previsão clínica que usam métodos de regressão ou aprendizado de máquina. *BMJ*. 2024;385:e078378. DOI: 10.1136/bmj-2023-078378
[12] Vasey B, Nagendran M, Campbell B, et al. Diretriz de Relatórios para Avaliação Clínica em Estágio Inicial de Sistemas de Apoio à Decisão Impulsionados por Inteligência Artificial: DECIDE-AI. *BMJ*. 2022;377:e070904. DOI: 10.1136/bmj-2022-070904
[13] Liu X, Cruz Rivera S, Moher D, et al. Diretrizes para relatórios de ensaios clínicos para intervenções envolvendo inteligência artificial: extensão CONSORT-AI. *BMJ*. 2020;370:m3164. DOI: 10.1136/bmj.m3164
[14] Nori H, Daswani M, Kelly C, et al. Diagnóstico Sequencial com Modelos de Linguagem. 2025. arXiv:2506.22405, pré-impressão
[15] Administração de Alimentos e Medicamentos dos EUA. Funções de software de dispositivos habilitados para inteligência artificial: gerenciamento do ciclo de vida e recomendações de envio de marketing. Projeto de orientação, janeiro de 2025. Página oficial da FDA Página oficial da FDA
