Resumen: los rankings de IA médica deben apoyar decisiones basadas en evidencia
Las listas en el campo de la inteligencia artificial médica a menudo se comprimen en una tabla ordenada por puntuación total. Sin embargo, en un escenario médico, el hecho de que un modelo esté por delante en las preguntas de los exámenes no significa que pueda recopilar de manera estable el historial médico, identificar la información faltante, seleccionar exámenes de manera razonable, seguir pautas y expresar incertidumbre en el diagnóstico y tratamiento reales, ni tampoco significa que sea adecuado para ser incluido en los servicios al paciente o en los flujos de trabajo de los médicos. El valor real de la lista no es crear un campeón único, sino hacer que las capacidades del modelo, los límites de las tareas, los riesgos, los costos y los niveles de evidencia sean observables, comparables y revisables.
Los puntos de referencia de preguntas y respuestas médicas siguen siendo relevantes. MedQA convierte las preguntas del examen de médico estadounidense en tareas de preguntas y respuestas médicas. PubMedQA requiere que el modelo combine el resumen del artículo para determinar si la conclusión de la investigación respalda el problema; Proporcionan un punto de partida repetible para la cobertura del conocimiento médico y la capacidad de lectura de investigaciones [1–2]. Pero la práctica clínica no salta directamente de la pregunta a la respuesta. Los pacientes no presentan la información en el orden de los libros de texto, no se conocen todas las pruebas, pueden ser razonables diagnósticos múltiples simultáneamente y las decisiones están influenciadas por el tiempo, los recursos, las preferencias del paciente y la tolerancia al riesgo.
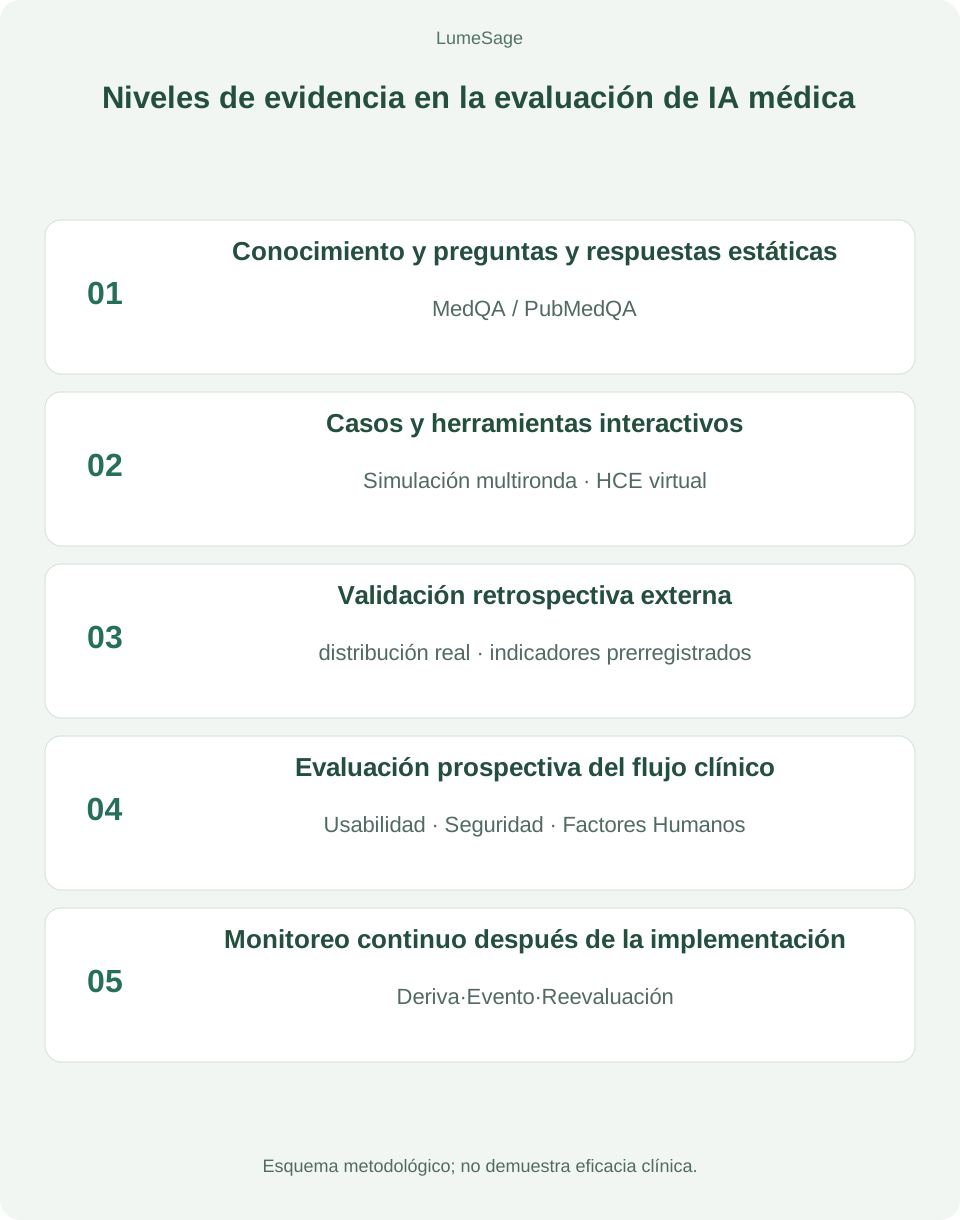
El trabajo de evaluación de los últimos años está ampliando los puntos de referencia médicos a tareas más cercanas al trabajo real: HealthBench utiliza rúbricas escritas por médicos para evaluar conversaciones de salud abiertas y de múltiples rondas; AgentClinic coloca consultas, uso de herramientas e información incompleta en entornos clínicos simulados; MedAgentBench permite a los agentes completar tareas a través de un entorno de registros médicos electrónicos virtuales que cumple con FHIR; MedHELM organiza múltiples puntos de referencia médicos basados en un sistema de clasificación de tareas [3–6]. La revisión clínica de IA de 2026 señaló además que las preguntas estándar, los casos simulados, la validación retrospectiva y la evaluación clínica prospectiva se encuentran en diferentes niveles de evidencia y no pueden reemplazarse entre sí [7].
Este artículo se basa en un plan de construcción de un ranking de IA médica, centrándose en el análisis de múltiples rondas de consulta, simulación de retroalimentación de examen, codificación ICD, base de pautas, contabilidad de costos, evaluación de expertos doble ciego y diseño colaborativo hombre-máquina. La solución tiene un claro valor de ingeniería, pero también hay cuestiones científicas que deben corregirse primero: las puntuaciones del modelo interno no se pueden utilizar directamente como clasificaciones públicas cuando el tamaño de la muestra, la versión, las palabras clave, las reglas de puntuación y los intervalos de confianza están incompletos; los resultados faltantes del examen no pueden ser completados silenciosamente como "negativos" por el simulador; La lista de registros médicos reales no debe utilizarse como estándar de oro para el diagnóstico y el tratamiento por defecto.
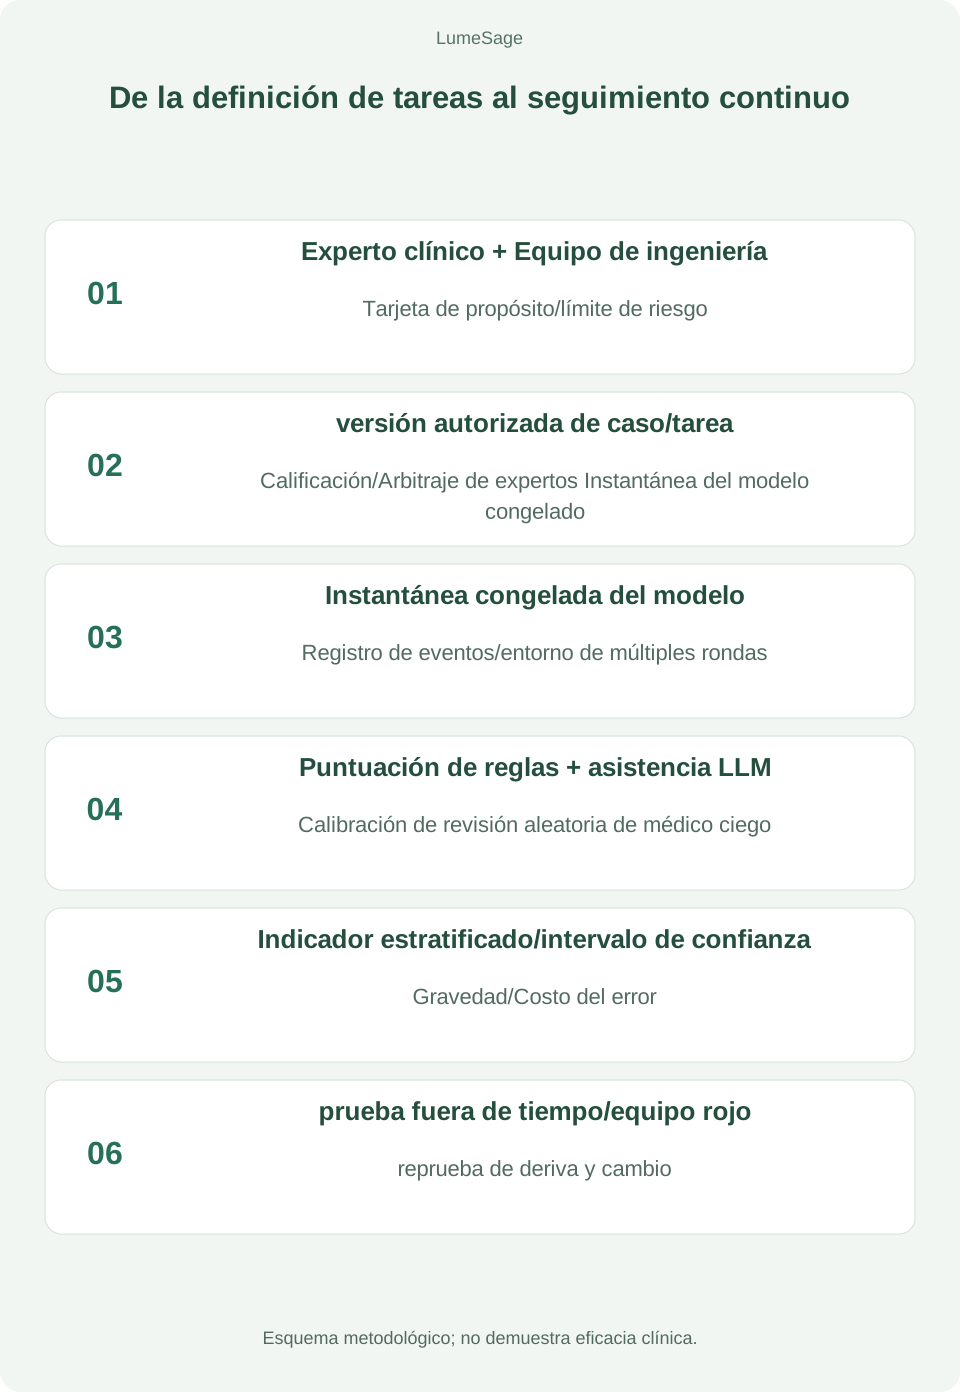
Este artículo propone un camino de construcción más sólido: primero defina usos y riesgos, y luego organice casos de origen, autorizados y representativos; establecer una escalera de evidencia entre preguntas estáticas, simulaciones interactivas, verificación externa retrospectiva y pilotos potenciales; informar al mismo tiempo sobre la corrección, la seguridad, la calibración, la utilización de recursos, la usabilidad y el rendimiento de la colaboración entre humanos y máquinas; y finalmente mantener la lista con datos versionados, puntuación auditable y pruebas continuas del equipo rojo. Para LumeSage, esta dirección puede conectar la ingeniería de datos, la anotación médica, la revisión de expertos, la gestión de calidad y la evaluación privada en un proceso de servicio verificable, en lugar de empaquetar "tener datos" o "estar en la lista" como resultados clínicos.
1. Por qué los resultados de un examen no demuestran capacidad clínica
1. Las preguntas sobre conocimientos médicos miden porciones de capacidad El punto de referencia de preguntas médicas de opción múltiple
es adecuado para evaluar la extracción de conocimientos, el análisis de conceptos y los procesos de razonamiento limitado bajo preguntas claras. Su ventaja es que los formatos de preguntas y respuestas son relativamente estables, fáciles de reproducir, fáciles de establecer líneas de base y adecuados para observar cambios en el modelo con actualizaciones de versión. El problema es que la estructura de las preguntas del examen condensa la tarea clínica en “información dada: elegir una respuesta”. El modelo no tiene que hacer preguntas, decidir si realizar pruebas o indicar qué información es insuficiente para respaldar una conclusión.
Las preguntas y respuestas basadas en investigaciones también tienen sus propios límites de tareas. PubMedQA organiza preguntas, contexto abstracto y conclusiones en juicios de sí/no/tal vez, lo cual es adecuado para probar la lectura e inducción de evidencia, pero no se puede inferir que el modelo sea capaz de manejar información contradictoria en registros médicos o en la comunicación real entre médico y paciente. Referirse directamente a las puntuaciones de las pruebas como "competencia clínica" es extrapolar los resultados de una tarea limitada a otra tarea de sistemas complejos.
2. La toma de decisiones clínicas es un proceso secuencial
El diagnóstico y el tratamiento reales implican una serie de opciones que interactúan: qué preguntar primero, cuándo realizar el seguimiento, si realizar pruebas, cómo interpretar nuevos resultados, si revisar el diagnóstico diferencial, cuándo suspender las pruebas y cuándo solicitar una revisión. La investigación de AgentClinic convirtió preguntas estáticas de MedQA en múltiples rondas de interacciones y descubrió que la dificultad de la toma de decisiones secuencial aumentaría significativamente; MedAgentBench colocó un conjunto de tareas en un entorno de registros médicos electrónicos virtuales, lo que requiere que el modelo lea u opere registros médicos estructurados a través de llamadas a herramientas [4–5]. Estos trabajos recuerdan que la capacidad de un modelo para responder preguntas y la capacidad de un modelo para completar un proceso son dos tipos diferentes de habilidades.
3. El coste de los errores médicos es asimétrico
Omitir un signo crítico, fabricar un resultado de inspección que no se ha realizado y proponer medidas innecesarias de alto riesgo no se pueden deducir según los mismos estándares que una mala redacción. La precisión general puede enmascarar fallos de seguridad de baja frecuencia pero de grandes consecuencias. Los puntos de referencia de seguridad como NOHARM toman "la frecuencia y la gravedad del daño potencial" como objeto de evaluación especial; su investigación aún debe interpretarse de acuerdo con los casos y el rango de anotaciones del artículo en sí, pero ilustra claramente que la seguridad no es sinónimo de puntajes de conocimiento médico [8].
4. Los estándares médicos envejecerán y pueden “cocinarse”
Cuando el banco público de preguntas se utiliza muchas veces para capacitación, optimización de palabras y selección de modelos, la puntuación de la lista puede reflejar más la familiaridad del modelo con la distribución de preguntas que su capacidad de generalización al enfrentar nuevos casos. Los conjuntos de pruebas estáticas también pueden perder rápidamente la distinción debido a que el modelo se itera demasiado rápido. Dynamic Red Teaming Research 2025 y su trabajo en la revista 2026 demuestran el valor de las indicaciones de mutación continua, los escenarios adversos y las pruebas de estrés de seguridad, además de las pruebas estáticas [9]. Las pruebas dinámicas no son una solución universal: si las reglas de ataque para cada ronda no son transparentes o reproducibles, será difícil comparar las puntuaciones. Por lo tanto, es prudente utilizar conjuntos públicos fijos para líneas de base reproducibles, conjuntos ocultos controlados, validación fuera de tiempo y equipos rojos dinámicos para verificaciones de novedad y solidez, y revelar claramente las preguntas respondidas por cada puntaje.
2. De los benchmarks estáticos a la evaluación de los flujos clínicos
1. De respuestas de preguntas únicas a conversaciones reales La información original del proyecto
HealthBench muestra que el punto de referencia incluye 5.000 diálogos de salud, que fueron construidos por 262 médicos que han ejercido en 60 países, y una rúbrica de puntuación elemento por elemento está diseñada para respuestas modelo; la información oficial establece claramente que el diálogo puede ser multiturno, multilingüe y también cubre escenarios entre usuarios comunes y profesionales médicos [3]. Por lo tanto, es necesario corregir la descripción de HealthBench como “todas las conversaciones de un solo turno” en los materiales del programa. La clave aquí no es si un determinado punto de referencia es "el más avanzado", sino que la introducción del punto de referencia debe volver al documento original y verificar la descripción de los datos oficiales, y no puede basarse en tablas de segunda mano.
Los médicos escriben rúbricas artículo por artículo para ayudar a evitar evaluar respuestas médicas abiertas únicamente con la concordancia de palabras clave. Pero aún es necesario verificar la cobertura de las rúbricas, las ponderaciones, los límites de decisión y las calificaciones automáticas. El trabajo original en HealthBench también utilizó puntajes modelo y los médicos los revisaron para verificar su coherencia con los juicios humanos; Estos métodos son adecuados para su ampliación, pero no deben interpretarse como "los jueces del LLM son objetivos por naturaleza".
2. De los casos estáticos al entorno interactivo
La investigación de AgentClinic establece roles como médicos, pacientes y herramientas de medición en un entorno simulado para respaldar información incompleta, múltiples rondas de interacción y uso de herramientas [4]. MedAgentBench proporciona además 300 tareas clínicas, 100 archivos de pacientes y un entorno EHR virtual compatible con FHIR [5]. Expanden el objeto de evaluación de una respuesta de texto a "si el modelo puede completar la acción especificada en un entorno determinado".
El valor del entorno de simulación radica en su controlabilidad, repetibilidad y registrabilidad; su limitación es la brecha entre el simulador de paciente, el simulador de examen, la estructura de datos de la historia clínica y el sistema médico real. El artículo de MedAgentBench también menciona claramente que el entorno virtual no se puede utilizar directamente como sistema de producción y señala que existen límites en las fuentes de datos y la cobertura de tareas. Para los puntos de referencia autoconstruidos, el entorno del agente no solo debe preguntar "si la tarea se completó", sino también registrar llamadas a herramientas, cambios de estado, operaciones no autorizadas, solicitudes no válidas, verificaciones repetidas y puntos de terminación.
3. De “una gran lista” al pedigrí de tareas
MedHELM organiza evaluaciones de grandes modelos médicos en 5 categorías principales, 22 subcategorías y 121 tareas, y reúne múltiples puntos de referencia nuevos y existentes [6]. Esta estructura ilustra mejor para qué es adecuado y para qué no es adecuado el modelo que agrupar el diagnóstico, la generación de registros médicos, la comunicación con el paciente, la investigación médica y los procesos administrativos en una sola puntuación. La inspiración es: el primer nivel de la lista debería ser la clasificación de usos y el segundo nivel debería ser la comparación de modelos.
Por ejemplo, los resúmenes de historias clínicas y la educación del paciente pertenecen a diferentes escenarios de riesgo; La extracción de informes de pruebas, las recomendaciones de diagnóstico y la programación de recursos médicos no deben compartir el mismo conjunto de ponderaciones de evaluación. Para una lista orientada a un propósito específico, primero se deben fijar los usuarios objetivo, la información de entrada, las herramientas permitidas, la salida del sistema, las responsabilidades de revisión manual y los costos de fallas, y luego se deben determinar las dimensiones de puntuación.
4. De la clasificación única al seguimiento continuo
Los sistemas de IA clínica pueden depender de API modelo, palabras clave, bibliotecas de búsqueda, cadenas de herramientas y estrategias de interacción persona-computadora. Simplemente informar "nombre del modelo + puntuación" no es suficiente para reproducir un sistema. TRIPOD-LLM en 2025 recuerda a los investigadores que informen información como escenarios de uso, modelos y versiones, ingeniería rápida, procesamiento de datos, calificaciones de revisión humana y control de calidad; TRIPOD+AI, DECIDE-AI y CONSORT-AI proporcionan marcos de informes correspondientes para informes de modelos predictivos, evaluación temprana de escenarios de la vida real y ensayos clínicos de intervención de IA, respectivamente [10–13]. Estas directrices no representan una aprobación clínica ni una certificación de calidad, pero ilustran que la presentación de informes transparentes es la base para la comparabilidad y reproducibilidad académica.
3. Evaluación de la propuesta: viabilidad, limitaciones y mejoras
1. Historiales médicos reales e información compleja: la dirección es correcta y la fuente y representatividad de la muestra deben ser claras El esquema
recomienda que se utilicen registros médicos, pruebas e información de exámenes estructurados y reales para mejorar la abundancia de información clínica, lo cual es una dirección necesaria. Los textos clínicos contienen abreviaturas, omisiones, errores tipográficos, períodos de tiempo y contradicciones entre documentos, lo que dificulta que los casos sintéticos cubran toda la verdadera complejidad. El uso de datos reales también debe explicar: fuentes de datos y alcance de la autorización, deduplicación a nivel de paciente, protección de la privacidad, criterios de inclusión y exclusión, distribución de la institución y la población, proporciones de enfermedad y gravedad, mecanismos faltantes y si hay problemas con el mismo paciente en todos los conjuntos de entrenamiento/prueba.
"Real" no significa "representante". Los datos de grandes hospitales o departamentos individuales no pueden extrapolarse naturalmente a comunidades, diferentes regiones y diferentes grupos lingüísticos. Las mediciones deben informar el desempeño por ámbito clínico, institución, grupo de edad, sexo, subtipo de enfermedad y grupo de riesgo clave; cuando no se dispone de muestras suficientes, la incertidumbre debe hacerse explícita en lugar de tratar las puntuaciones de grupos de muestra bajos como clasificaciones confiables.
2. Simulación de resultados de pruebas: se pueden realizar investigaciones, pero las incógnitas no se pueden disfrazar de negativas El plan
propone que cuando el caso original no proporcione el examen solicitado por el modelo, el "agente examinador" predecirá el resultado. Esto puede ayudar a construir escenas interactivas, pero también es el vínculo más riesgoso de todo el diseño técnico. En datos del mundo real, "sin inspección" significa que se desconoce el resultado, lo que no significa que el resultado sea normal; si el simulador genera un resultado aparentemente razonable y lo devuelve directamente al modelo bajo prueba, la prueba cambiará de "toma de decisiones con información incompleta" a "toma de decisiones con información escrita manualmente", lo que puede inducir conclusiones erróneas y hacer que los resultados de la prueba dependan de la desviación del propio simulador.
recomienda que el estado de la información se distinga estrictamente en: resultados observados, claramente no realizados, inobtenibles y generación de simulación. Los resultados de la simulación se devuelven únicamente dentro de una tarea de estudio del simulador separada, y su fuente de generación, nivel de confianza, aplicabilidad y verificación de la distribución real se conservan en segundo plano. La lista principal se puede configurar con dos pistas: una solo puntúa según la información determinista del caso; el otro utiliza un simulador ambiental verificado externamente con datos reales para evaluar el manejo del modelo de resultados inciertos. Los simuladores no deben utilizarse como generadores invisibles de hechos clínicos.
3. CIE-10 y puntuación estandarizada: es útil para estandarizar los registros, pero no significa establecer el estándar de oro para el diagnóstico.
La asignación de diagnósticos a códigos como ICD-10 es útil para estadísticas jerárquicas, agregación de categorías y revisión entre equipos, pero la comparación de códigos solo puede responder "¿dónde codifica el sistema la conclusión?" y no puede responder de forma independiente "si el juicio clínico es correcto". Los niveles de codificación pueden ser demasiado aproximados, es posible que se justifiquen múltiples conclusiones y los diagnósticos pueden cambiar con el tiempo y con nuevas pruebas. El enfoque correcto es utilizar la codificación como un campo auxiliar computable, conservando al mismo tiempo registros de conceptos clínicos, evidencia, diagnósticos alternativos aceptables, jerarquía diagnóstica y juicio de expertos.
El estándar de referencia debe ser establecido por médicos con la correspondiente experiencia especializada en función de los datos de los casos y las directrices aplicables; si es necesario, dos personas deben marcarlo de forma independiente, arbitrarlo por un tercero y registrar las diferencias. Para los casos en los que existen múltiples vías clínicamente razonables, la puntuación debe reconocer un conjunto predefinido de respuestas aceptables en lugar de tratar un único código de alta como la única respuesta correcta.
4. Coherencia de las pautas: ruta de evaluación, pero bloquea la versión y el grupo aplicable
Incorpora pautas, vías clínicas y consenso de expertos para proporcionar una justificación de por qué se eligió esta prueba o tratamiento. El protocolo de evaluación debe fijar el nombre de la guía, la versión, la fecha de publicación, la población aplicable y la fuerza de la recomendación; de lo contrario, el modelo puede recibir una calificación con una recomendación obsoleta o inapropiada para el paciente. Las directrices tampoco pueden agotar las preferencias, contraindicaciones, disponibilidad de recursos e incertidumbres clínicas de cada paciente.
recomienda dividir la coherencia de las directrices en tres preguntas verificables: si se han omitido pasos clave necesarios; si los pasos realizados tienen indicaciones correspondientes; si el modelo expresa incertidumbre y propone una ruta de actualización razonable cuando la evidencia es insuficiente o no está cubierta por la directriz."Mencionar palabras clave en la guía" no puede considerarse como "seguir la guía", ni la fluidez del proceso de razonamiento debe equipararse directamente con la corrección clínica.
5. Evaluación de costos: Incluir la economía en la lista es un progreso, pero un precio único no puede reemplazar el valor clínico. El plan
propone calcular el consumo de recursos en función de los precios de inspección y puede identificar la estrategia irrazonable de "abrir inspecciones ilimitadas para aumentar la información". Esto es consistente con la dirección del Sequential Diagnosis Benchmark de colocar los costos de diagnóstico y examen secuencial en el mismo entorno de evaluación [14]. Sin embargo, el precio de los servicios médicos depende de la región, el hospital, el sistema de pago, el seguro del paciente y las combinaciones de exámenes específicos; la lista de precios sólo puede ser una aproximación en un momento y escenario determinados, no un valor de costo verdadero universal.
Un enfoque de generación de informes más sólido sería presentar simultáneamente el rendimiento del diagnóstico, el riesgo de diagnóstico erróneo, el exceso de exámenes, el número de exámenes, el rango de costos, el tiempo de espera, la carga médica adicional y la incertidumbre. Dibujar la frontera "riesgo-efecto-coste" de diferentes modelos para explicar bajo qué usos, umbrales y entornos de pago una determinada solución es más adecuada, en lugar de declarar directamente que un modelo es "el más rentable". Si no hay una base para la ponderación de la utilidad clínica o el análisis de decisiones, no se deben convertir múltiples indicadores en un único retorno de la inversión.
6. Estabilidad y pass@k: deben definirse con precisión, sin muestreos repetidos para reemplazar la confiabilidad única
Los sistemas médicos generalmente enfrentan una solicitud real cuando se implementan, por lo que pass@1 refleja si una sola ejecución puede completar la tarea; pass@k generalmente enfatiza la probabilidad de al menos un éxito entre múltiples intentos, y la probabilidad de "k todos los éxitos" o la varianza de las puntuaciones entre ejecuciones es otro indicador de estabilidad. Pass@k y pass^k en el esquema deben definirse claramente uno por uno en el protocolo en papel, y se debe anotar el número de repeticiones, semillas aleatorias, temperatura, estrategia de muestreo y algoritmo resumido de cada caso.
Si el modelo se puede volver a intentar en escenarios reales, el sistema puede mostrar la mejor respuesta al usuario, pero este enfoque cambiará el retraso, el costo y el riesgo y debe evaluarse por separado. La calidad post-entrenamiento o la estabilidad clínica no se pueden inferir directamente de la diferencia entre pass@k y pass@1 únicamente; las diferencias estadísticas también tienen en cuenta el tamaño de la muestra, los intervalos de confianza, la agrupación de casos y los planes de análisis predeterminados. Todas las clasificaciones deben proporcionar intervalos de incertidumbre y evitar interpretar los intercambios de clasificaciones en muestras pequeñas como diferencias generacionales en capacidad.
7. LLM como juez: amplíe las capacidades de anotación, conserve la calibración y auditoría de expertos
El árbitro de LLM es adecuado para la verificación de formato, verificación parcial de hechos, evaluación preliminar de rúbricas y calificación auxiliar de muestras grandes, pero puede preferir respuestas que sean más largas, más seguras y redactadas más como su propio resultado, o puede compartir los mismos puntos ciegos de conocimiento con el modelo que se está probando. Estudios como HealthBench y MedHELM han demostrado la práctica de rúbricas y puntuadores modelo, y también ilustraron la necesidad de comparar la coherencia entre los puntuadores y los juicios de expertos clínicos [3,6].
recomienda el uso de puntuación jerárquica: se utilizan reglas deterministas para elementos verificables programables; los datos médicos y los puntos clave de seguridad se revisan utilizando fuentes citadas, reglas y expertos clínicos; la experiencia en comunicación y la idoneidad del programa se revisan mediante revisiones clínicas ciegas capacitadas. Dos personas seleccionan una determinada proporción de cada lote de muestras para su puntuación independiente, y se informa el índice de coherencia, la tasa de desacuerdo y el estado del arbitraje. El nombre y la versión del modelo de árbitro, las palabras clave, la temperatura de puntuación, la versión de la rúbrica y las muestras de calibración también se congelan y archivan.
8. Plataforma experta doble ciego: necesidad de evitar el cegamiento, los efectos de orden y la fatiga de puntuación Las plataformas de comparación de casos, preguntas y respuestas de modelo dual y pruebas ciegas aleatorias diseñadas en el plan
están operativas. Para que los resultados sean confiables, el cegamiento no puede basarse únicamente en ocultar los nombres de los modelos: es necesario unificar el formato de salida, eliminar las etiquetas de estilo de modelo y proveedor, y el orden de las respuestas debe ser aleatorio; los revisores no deben conocer la fuente de las respuestas ni su posición en la lista; Dos respuestas modelo para el mismo caso no deberían revelar pistas emparejadas en la interfaz. Se debe configurar capacitación de revisión, control de fatiga, detección de preguntas duplicadas, límite de tiempo de puntuación, cuestionario de adivinanzas a ciegas y revisión de objeciones. Las calificaciones de los expertos clínicos
tampoco son “naturalmente imparciales”. Los juicios sobre los riesgos aceptables pueden diferir según las especialidades, los años de experiencia y los entornos de práctica. Los estudios deben informar las calificaciones de los revisores, la distribución de especialidades, los métodos de comparación de tareas de casos, la coherencia entre revisores y los procesos de arbitraje, y establecer mecanismos de participación para las inquietudes de los pacientes y del público. DECIDE-AI enfatiza la practicidad clínica, la seguridad, los factores humanos y la preparación para ensayos adicionales en la evaluación clínica temprana; nos recuerda que la evaluación clínica real debe centrarse en los usuarios, el flujo de trabajo y la iteración del sistema, no solo en las puntuaciones de las respuestas del modelo [12].
4. Metodología para una evaluación fiable de la IA médica
1. Primero haga la “Tarjeta de propósito” y luego escriba las preguntas.
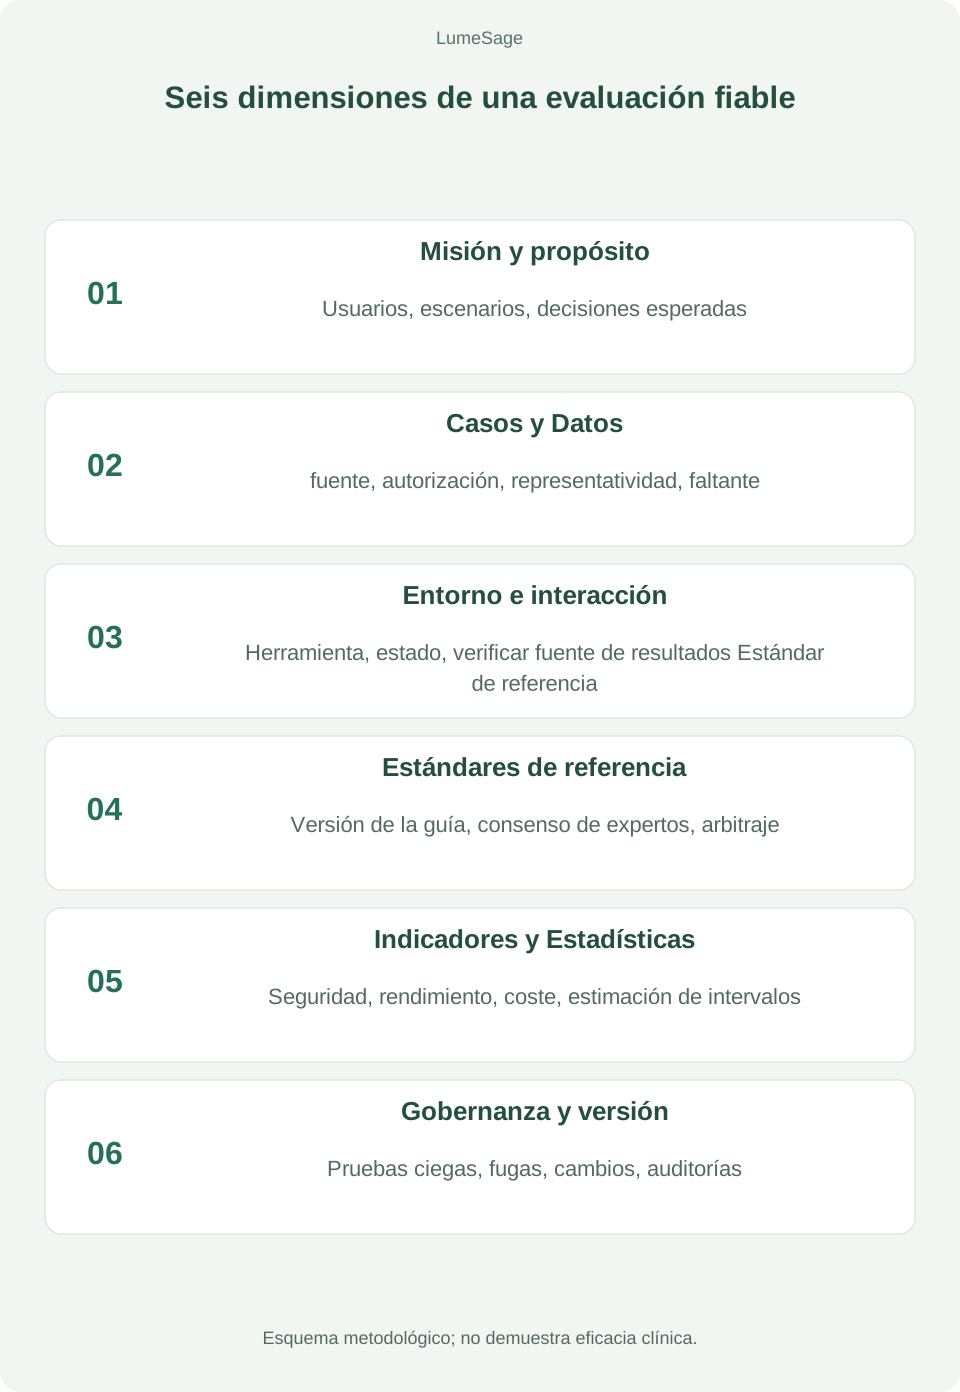
Para cada subelemento de la lista, primero complete la tarjeta de propósito: quién es el usuario objetivo; qué tipo de pacientes y problemas clínicos se atienden; qué papel juega el modelo; qué datos se pueden incluir en la entrada; si el resultado afecta las decisiones médicas reales; si se permite solicitar recuperación, herramientas o registros médicos electrónicos; quién realizará la revisión final; qué daño causará el fracaso. Las tarjetas de propósito determinan las tareas, los niveles de riesgo, las métricas de medición y la redacción de la divulgación. A falta de una definición de propósito, la lista no puede explicar qué significa la puntuación para la adquisición o el despliegue clínico.
2. Establecer pedigrí del caso y tarjeta de datos.
Cada caso registra al menos la identificación anónima del paciente/visita, el tipo de tarea, la enfermedad y la gravedad, la fuente de información, el momento, los campos estructurados, la asociación entre documentos y exámenes, la base de etiquetado, la versión de la guía aplicable, el estado faltante, las reglas de inclusión/exclusión de casos y un conjunto de respuestas aceptables. La división a nivel de caso debe evitar el mismo paciente, la misma visita o documentos casi duplicados que abarquen capacitación, ajuste de parámetros y conjuntos de pruebas. El conjunto de prueba debe conservar la versión y el linaje de datos; Se deben realizar auditorías periódicas de contaminación en el set público, y se deben implementar controles de acceso y registros de auditoría en el set oculto.
3. Tarjeta de tarea de diseño y estado del entorno
describe cada tarea como: información inicial, preguntas que el modelo puede plantear, herramientas disponibles, reglas de retorno del entorno, condiciones de terminación, operaciones permitidas, operaciones prohibidas y riesgos preestablecidos. Las tareas secuenciales deben preservar el diálogo completo y los rastros de herramientas, distinguiendo entre modelos sin consultas, entornos sin datos, comprobaciones no realizadas y resultados desconocidos. Si en la prueba participan pacientes simulados o agentes de inspección, se debe divulgar su proceso de verificación y modo de falla; el entorno de simulación no puede filtrar etiquetas al modelo bajo prueba, ni se pueden generar nuevos hechos que no cumplan con las reglas de transición de estado solo porque al modelo bajo prueba se le piden algunas rondas más.
4. Utilice el panel de indicadores en lugar de la puntuación total única
Se recomienda dividir los indicadores en al menos seis grupos: Rendimiento de la tarea
1. Rendimiento de la tarea: Precisión de diagnóstico o decisión, cobertura de pasos clave, integridad de extracción estructurada, tasa de finalización de tareas.2. Seguridad del paciente Error grave, omisión peligrosa, exceso de manejo, falso confort, negligencia tabú, examen o cotización ficticia.3. Calidad del proceso Eficiencia en la recopilación de información, selección de inspección, operaciones repetidas, corrección de la llamada de herramientas y si detenerse en el momento adecuado.4. Incertidumbre Error de calibración, estratificación de riesgos, idoneidad de la mano de obra de rechazo/actualización, relación entre predicción selectiva y cobertura.5. Utilización de recursos Beneficios clínicos en términos de costo, demora, cantidad de exámenes, tiempo de revisión manual y limitaciones de recursos.6. Generalizabilidad Desempeño en el tiempo, fuera de la institución, subgrupos, diferentes calidades de entrada, variantes lingüísticas y perturbaciones adversas.
Debe haber un umbral mínimo para el desempeño de seguridad; Los modelos con graves fallas de seguridad no deben ser "compensados" por la puntuación general debido a puntuaciones altas en tareas de bajo riesgo. La lista puede proporcionar una visión ponderada relevante para el propósito, pero las ponderaciones, los umbrales y el análisis de sensibilidad deben divulgarse, y cada indicador original debe conservarse para que los lectores lo revisen.
5. Plan estadístico de preinscripción e informe de versiones
Antes de ejecutar el modelo, primero escriba el criterio de valoración principal, el criterio de valoración secundario, la base del tamaño de la muestra, el objeto de comparación, el intervalo de confianza, el procesamiento de datos faltantes, el análisis estratificado, el procesamiento de comparación múltiple y las reglas de detención. Los resultados de las tareas se pueden agrupar según casos, pacientes e instituciones para calcular intervalos; Las comparaciones de múltiples modelos para el mismo caso deben utilizar un análisis emparejado apropiado para evitar tratar las pruebas de cada modelo como independientes entre sí. Las versiones de los modelos y palabras clave, la temperatura, los permisos de las herramientas, las fuentes de búsqueda, las fechas de API, las configuraciones de software y hardware y las fuentes de precios deben mantenerse en los archivos. Una vez actualizado el proveedor del modelo, no utilice directamente la clasificación anterior. Debe marcar la instantánea y volver a evaluarla.
6. El punto de referencia público adopta la estructura paralela de "conjunto de desarrollo-conjunto de validación-conjunto oculto-conjunto dinámico" El conjunto de desarrollo
se utiliza para la depuración comunitaria, el conjunto de verificación admite la calibración de parámetros y reglas de puntuación, el conjunto oculto reduce el sobreajuste del objetivo de prueba y el conjunto dinámico del equipo rojo prueba nuevos ataques y cambios de distribución. Cada uno de los cuatro tipos de datos tiene sus propios usos y no deben combinarse en un misterioso "conjunto de pruebas total". Si las muestras de casos se hacen públicas, se debe evaluar el riesgo de que se incluyan en los motores de búsqueda y en el corpus de formación posterior; No es necesario que las etiquetas clave, las rúbricas completas o los casos ocultos se hagan públicos, pero los protocolos de evaluación, los resúmenes estadísticos, los códigos o las interfaces auditables deben hacerse públicos y se deben establecer procedimientos de acceso de los investigadores.
5. Cuatro etapas del prototipo a la evidencia clínica
Fase 0: Definición de límites y gobernanza, ~4 a 6 semanas
Primero elija una tarea de entrada específica, verificable y de bajo riesgo, como "verificación de integridad de la información de documentos clínicos" o "extracción de campo de informes de imágenes específicos", en lugar de comenzar con "evaluar toda la IA médica". Establecer un equipo con participación clínica, algorítmica, estadística, de protección de datos y de productos; conformar una tarjeta de propósito, análisis de riesgos, lista de autorización de datos, especificaciones de etiquetado de cajas, manual de puntuación y plan estadístico de preinscripción. Los umbrales de la etapa son: el origen del caso es claro, los usos permitidos son claros y los estándares de evaluación pueden ser utilizados por dos expertos independientes.
Fase 1: línea base estática y anotación ciega, aproximadamente de 6 a 10 semanas
Cree un conjunto de conjuntos de desarrollo y conjuntos de verificación independientes para la iteración; seleccione instantáneas de modelos públicos e interfaces de modelos privados, y congele palabras y configuraciones de avisos. Primero evaluamos el desempeño de las tareas, los tipos de errores, el desempeño jerárquico y la coherencia entre los árbitros automáticos y las puntuaciones de los expertos, y no buscamos la publicación única de una "clasificación nacional". Los umbrales de la etapa son: los indicadores principales pueden repetirse, existe un proceso de arbitraje para calificar las disputas y los errores de seguridad graves pueden atribuirse a casos y pruebas.
Fase 2: entorno interactivo y validación externa, ~8–14 semanas
Coloque las tareas de consulta, toma de decisiones sobre exámenes u operación de registros médicos en un entorno de simulación aislado. Se ahorran el estado del paciente, los resultados de los exámenes, las interfaces de las herramientas, los cronogramas y los costos de los recursos; Los datos simulados están estrictamente separados de los datos de observación reales. Como mínimo, la validación se repite en casos reservados de diferentes fuentes o períodos de tiempo, y un equipo clínico independiente revisa el entorno y el etiquetado. Los umbrales de las etapas son: el simulador tiene informes de validación, se cuantifican las brechas de rendimiento entre fuentes y no se mezcla información sintética sin etiquetar con los hechos clínicos.
Fase 3: piloto de flujo de trabajo real a pequeña escala y monitoreo continuo
Si la tarea afectará la toma de decisiones médicas reales, debería entrar en una evaluación a pequeña escala con visión de futuro respaldada por la ética, la privacidad y la gobernanza institucional, y primero posicionarse como "ejecución asistida" en lugar de "ejecución automatizada". Registre si los médicos vieron y actuaron según las recomendaciones, la duración del uso, la modificación del comportamiento, la frecuencia del escalamiento manual, los posibles eventos adversos, la carga de trabajo y el desempeño en diferentes subgrupos. Informe de forma transparente de acuerdo con la guía aplicable, como DECIDE-AI, y seleccione las especificaciones apropiadas según el tipo de estudio específico. Los estudios clínicos a mayor escala o las vías de producción se analizan sólo después de que se alcanzan los umbrales de seguridad y eficacia preestablecidos. El borrador del ciclo de vida del software de dispositivos médicos de IA publicado por la FDA en 2025 proporciona sugerencias para la gestión de riesgos y la presentación de materiales para productos relacionados, pero el documento está marcado como un borrador y no vinculante, y no debe describirse como una aprobación completa o una conclusión regulatoria de aplicación general [15].
El período de tiempo para las Fases 0 a 3 es solo un intervalo de planificación del proyecto y no es un compromiso de entrega garantizado; el período real depende de la cooperación institucional, la revisión ética, la autorización de datos, el volumen de casos, los recursos de revisión y los usos específicos. El presupuesto debe dividirse en gobernanza de datos, expertos clínicos, ingeniería, estadísticas, plataforma, auditorías de seguridad y mantenimiento continuo, en lugar de simplemente estimar por volumen de llamadas de modelos.
6. La contribución de los benchmarks a la atención sanitaria
1. Permitir que las instituciones médicas elijan modelos más basados en
Las organizaciones de atención médica pueden ver los márgenes de seguridad, los costos y los tipos de error de un modelo por tareas específicas en lugar de apostar por una clasificación general. Para las adquisiciones, la lista puede convertir "el rendimiento de la demostración del modelo es bueno" en términos de aceptación verificables: muestra y alcance de la tarea, umbral de error grave, límite de tiempo de respuesta, registros de auditoría, pruebas de regresión después de la actualización de la versión y mecanismo de actualización cuando no se puede procesar.
2. Ayude al equipo modelo a localizar la dirección real de mejora
La precisión insuficiente puede deberse al conocimiento, la recopilación de información, la lectura de imágenes, la invocación de herramientas, la integración contextual, la calibración o la presentación. La clasificación de errores y el seguimiento de procesos pueden conectar el enriquecimiento de datos, la capacitación posterior, la mejora de la recuperación, el diseño de herramientas y las políticas de seguridad. Para los servicios de datos, esto ayuda a pasar de “cuántas muestras entregar” a “qué muestras pueden llenar qué brecha de capacidad observable”.
3. Reducir los riesgos invisibles que soportan los pacientes y los equipos clínicos Si la lista
registra omisiones, engaños, verificación excesiva, operaciones ultraautorizadas y comportamientos inciertos, puede ayudar a las organizaciones a establecer puntos de revisión manual antes de la implementación. No garantiza riesgo cero, pero puede hacer que los riesgos conocidos sean más fáciles de identificar, comunicar y gestionar.
4. Establecer una base de comparación reproducible para la investigación.
Las tareas estándar, las configuraciones congeladas, los informes públicos y las auditorías de versiones pueden reducir la incomparabilidad causada por "cada uno prueba lo suyo" entre diferentes organizaciones. Los investigadores también pueden observar la variación del rendimiento del modelo en diferentes tareas, idiomas, instituciones y versiones, lo que proporciona un punto de partida rastreable para la validación externa y la investigación prospectiva.
5. Deje que los servicios de datos y la evaluación clínica formen un circuito cerrado
Cuando se mapean la especificación de datos y la evaluación del modelo, el equipo puede rastrear “atributos del caso—evidencia etiquetada—fallo del modelo—muestras suplementarias—resultados de nuevas pruebas”. Este circuito cerrado ayuda a distinguir entre la calidad de los datos, la calidad de las anotaciones y las capacidades del modelo: el fallo del modelo no es necesariamente una falta de datos y la abundancia de datos no produce automáticamente valor clínico. La conclusión de la evaluación debería centrarse en tareas específicas y tarjetas de datos, en lugar de limitarse a formar una lista publicitaria.
7. LumeSage: procesos de evaluación verificables
La construcción de la ranking de IA médica requiere algo más que la capacidad de ingeniería para llamar al modelo. También necesita traducir los objetivos clínicos en especificaciones de tareas, incorporar fuentes de casos, autorización, desensibilización y gestión de versiones en los procesos de datos; establecer asociaciones rastreables para imágenes, documentos, pruebas y muestras multimodales; precipitar la anotación de especialidad, la revisión, el arbitraje de desacuerdos y la puntuación de rúbricas en registros auditables; y luego utilice la plataforma de ingeniería para completar la ejecución automatizada, la reproducción de registros, la contabilidad de costos y la generación de informes.
LumeSage puede organizar servicios en torno a estos enlaces: clasificación de requisitos y uso, diseño de conjuntos de pruebas, especificaciones de muestra y tarjetas de datos, anotaciones médicas e inspección de calidad, evaluación ciega de expertos, entorno de evaluación privada, informe de referencia y regresión de versiones. El valor de los servicios de evaluación privados como Medical Gate debe explicarse por los límites reales de sus tareas, la autorización de datos, la participación de expertos, los protocolos de puntuación y la evidencia de replicación; Las declaraciones que involucran la seguridad del paciente o los efectos clínicos deben estar respaldadas por la investigación correspondiente y la evidencia del escenario aplicable.
La simulación de múltiples agentes, el análisis de costos, la plataforma experta y la puntuación orientada al diagnóstico que se presentan en esta solución son adecuadas para su uso como ruta de investigación y desarrollo y verificación interna de hipótesis. Antes de publicar públicamente los resultados del modelo, se debe completar el número y la fuente de los casos, la división de datos, las instantáneas del modelo, las palabras clave, la temperatura, las herramientas, el número de repeticiones por caso, la rúbrica de puntuación, la composición de expertos, la coherencia del árbitro, el intervalo de confianza, el área de costos y el método de cálculo, así como la información de preinscripción o recurrencia del código. En ausencia de estos materiales, no es apropiado llamar al cuadro interno una clasificación pública verificada independientemente; Este documento técnico no revela las clasificaciones de modelos específicos ni los costos de casos únicos en el plan.
En cuanto a "¿Puede la lista médica demostrar que el modelo puede diagnosticar y tratar de forma independiente?", La respuesta debe ser clara: no. La evaluación comparativa proporciona evidencia fuera de línea para tareas específicas; La verdadera usabilidad clínica también depende de la validación externa, el flujo de trabajo clínico, los factores humanos, los límites regulatorios y los estudios prospectivos de seguridad y eficacia. La credibilidad de la marca de la IA médica debe establecerse mediante límites claros, métodos revisables y la capacidad de cuestionar los resultados.
Conclusión: un mapa de evidencia más allá de una clasificación única
El Future of Healthcare AI Benchmark no debería ser una medalla de por vida, sino un mapa ampliado por propósito, población de pacientes, tipo de datos, riesgo, costo y nivel de evidencia. No sólo permite que los modelos demuestren avances en tareas claras, sino que también presenta problemas no resueltos; no sólo fomenta la iteración del algoritmo, sino que también deja espacio para el juicio de los expertos clínicos, los pacientes y las instituciones.
Para las instituciones médicas, la lista debe ofrecer opciones limitadas; para los grupos de algoritmos, debería servir para mejoras locales; para los proveedores de servicios de datos, debería servir a un circuito cerrado de tareas, evidencia y calidad; para los pacientes, debería reducir el riesgo de confundir respuestas fluidas con conclusiones seguras. La competencia en IA médica no debería centrarse solo en quién obtiene una puntuación más alta en el banco de preguntas, sino también en quién puede brindar ayuda estable, transparente y responsable para un propósito claro, y saber cuándo detenerse cuando no hay evidencia suficiente.
*Este artículo es una discusión sobre los métodos de investigación y evaluación de la IA médica. No constituye recomendaciones de diagnóstico y tratamiento clínico, conclusiones de registro de dispositivos médicos ni certificación de la eficacia clínica de ningún modelo.*
Preguntas frecuentes
Referencias
[1] Jin D, Pan E, Oufattole N, et al. ¿Qué enfermedad tiene este paciente? Un conjunto de datos de respuestas a preguntas de dominio abierto a gran escala de exámenes médicos. *Ciencias Aplicadas*. 2021;11(14):6421. DOI: 10.3390/aplicación11146421
[2] Jin Q, Dhingra B, Liu Z, Cohen WW, Lu X. PubMedQA: un conjunto de datos para responder preguntas de investigación biomédica. *EMNLP-IJCNLP*. 2019:2567–2577. Antología ACL
[3] Arora RK, Wei J, Hicks RS, et al. HealthBench: Evaluación de modelos de lenguaje grandes para mejorar la salud humana. 2025. Artículo · Descripción y datos del proyecto
[4] Schmidgall S, Ziaei R, Harris C, et al. AgentClinic: un punto de referencia de agentes multimodal para evaluar la IA en entornos clínicos simulados. 2024. arXiv:2405.07960
[5] Jiang Y, Black KC, Geng G, et al. MedAgentBench: un entorno virtual de EHR para comparar agentes médicos de LLM. *NEJM AI*. 2025;2(9). DOI: 10.1056/AIdbp2500144
[6] Bedi S, Liu Y, Orr-Ewing L, et al. MedHELM: Evaluación holística de modelos de lenguaje grandes para tareas médicas. 2025. arXiv:2505.23802 · Clasificación HELM de Stanford
[7] Worth JE, Pérez A, Wu DJH, et al. Estado de la IA clínica en 2026. *BMJ Digital Health & AI*. 2026;2(1):e000113. Diario texto completo
[8] Wu D, Nateghi Haredasht F, Kumar Maharaj S, et al. Primero, haga NOHARM: Hacia modelos de lenguaje grande clínicamente seguros. 2025. arXiv:2512.01241, preimpresión
[9] Pan J, Jian B, Hager P, et al. Abordar las brechas de evaluación comparativa en modelos de lenguaje grandes para la salud y la medicina con Dynamic Red-Teaming. *Salud de la Naturaleza*. 2026. DOI: 10.1038/s44360-026-00152-8
[10] Gallifant J, Afshar M, Ameen S, et al. La guía de informes TRIPOD-LLM para estudios que utilizan modelos de lenguaje grandes. *Medicina de la Naturaleza*. 2025;31:60–69. DOI: 10.1038/s41591-024-03425-5
[11] Collins GS, Lunas KGM, Dhiman P, et al. Declaración TRIPOD+AI: Guía actualizada para informar modelos de predicción clínica que utilizan métodos de regresión o aprendizaje automático. *BMJ*. 2024;385:e078378. DOI: 10.1136/bmj-2023-078378
[12] Vasey B, Nagendran M, Campbell B, et al. Directriz de informes para la evaluación clínica en etapa temprana de sistemas de apoyo a la toma de decisiones impulsados por inteligencia artificial: DECIDE-AI. *BMJ*. 2022;377:e070904. DOI: 10.1136/bmj-2022-070904
[13] Liu X, Cruz Rivera S, Moher D, et al. Directrices para la presentación de informes de ensayos clínicos para intervenciones que involucran inteligencia artificial: Extensión CONSORT-AI. *BMJ*. 2020;370:m3164. DOI: 10.1136/bmj.m3164
[14] Nori H, Daswani M, Kelly C, et al. Diagnóstico secuencial con modelos de lenguaje. 2025. arXiv:2506.22405, preimpresión
[15] Administración de Alimentos y Medicamentos de EE. UU. Funciones de software de dispositivos habilitados para inteligencia artificial: recomendaciones de envío de marketing y gestión del ciclo de vida. Borrador de orientación, enero de 2025. Página oficial de la FDA
