La question de recherche détermine la structure de l'ensemble de données
La conception d'un ensemble de données longitudinales ne peut pas commencer par la structure des dossiers, mais doit d'abord clarifier les questions auxquelles le modèle ou l'étude souhaite répondre. L’identification précoce de la maladie nécessite des moments de référence clairs et des fenêtres d’observation de suivi ; l'analyse de la réponse au traitement nécessite la séquence entre l'exposition médicamenteuse ou chirurgicale, les résultats des tests et les résultats ; la prédiction d'une récidive ou d'une réadmission nécessite la définition de la date d'indexation, de la durée du suivi, des événements de résultat et des règles de perte de suivi. Sans ces définitions, une « période de trois ans » n'est qu'une exigence générale de collecte et ne garantit pas que l'échantillon est suffisant pour étayer une analyse spécifique.
Il est recommandé de clarifier quatre choses pour chaque cas : quel est le point de départ, comment calculer la période d'observation, comment déterminer le point final et quels enregistrements appartiennent à cette trajectoire. Le point de départ peut être la date du premier diagnostic, de l’évaluation préalable au traitement, de l’admission ou d’un test ; le point final peut être une récidive, une progression, un décès, une réadmission, une rémission ou l'atteinte d'une date limite de suivi spécifiée. Pour les patients présentant des « événements non observés », il faut distinguer « le suivi est complet mais n'a pas eu lieu », « perdu de vue précocement » et « aucune donnée de suivi dans le système d'enregistrement ». Écrire ces statuts comme « aucun résultat » entraînera des erreurs d'étiquetage et des biais de suivi.
L'étude Delphi-2M publiée dans « Nature » en 2025 a utilisé des chronologies de maladies pour modéliser le risque futur de plusieurs maladies, et a été validée en externe avec les données du registre danois après une formation dans la cohorte britannique, démontrant le potentiel des données de séries chronologiques pour la modélisation des processus pathologiques. L'étude a également souligné que le modèle peut apprendre des biais de sélection et des modèles manquants dans l'ensemble de données, de sorte que les performances de prédiction ne peuvent pas être expliquées indépendamment de la composition de la cohorte et du mécanisme de génération de données.[1] Cela a des implications directes sur la construction des données : les horodatages, les raisons de la fin du suivi, les institutions sources et les mécanismes manquants sont autant de contextes que le modèle doit connaître.
Les patients, les visites, les événements et les fichiers doivent être liés hiérarchiquement
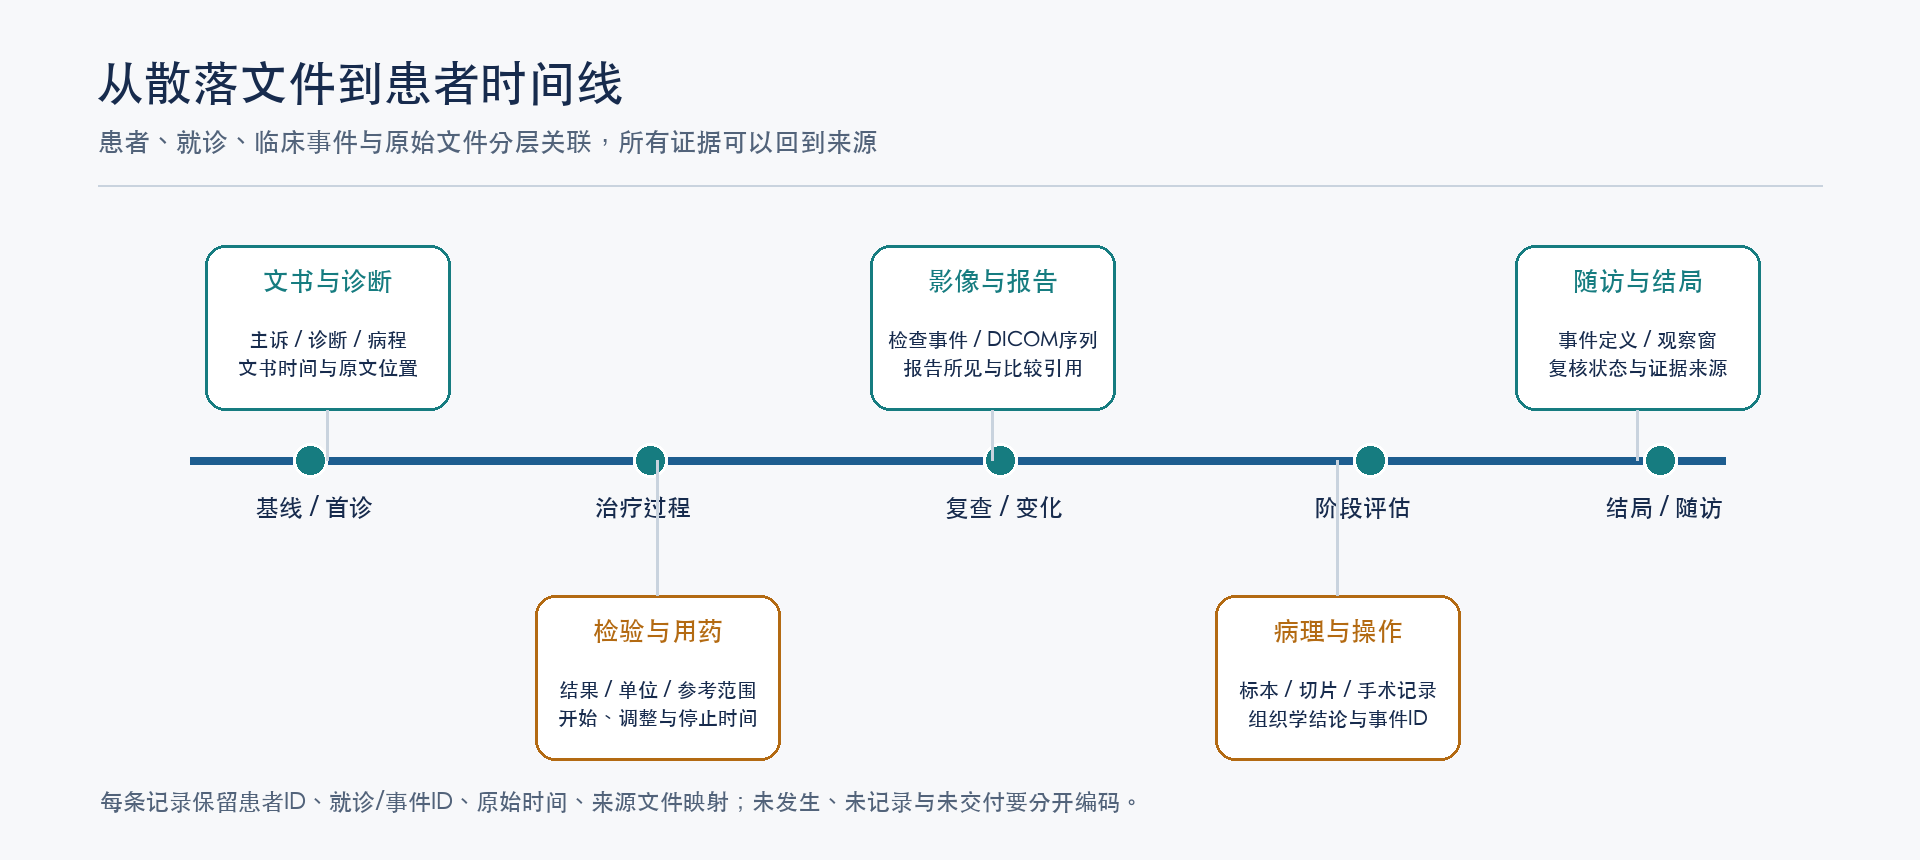
recommande de diviser les données longitudinales en quatre niveaux interdépendants. La couche patient utilise des identifiants de patient anonymes et stables et est chargée d'enchaîner plusieurs visites de la même personne ; la couche de visite enregistre les événements ambulatoires, d'hospitalisation, d'urgence, de transfert ou de suivi ; la couche d'événements cliniques enregistre le diagnostic, les symptômes, les examens, les tests, les médicaments, les opérations et les résultats ; la couche de fichiers stocke les supports originaux tels que les documents d'évolution de la maladie, les rapports d'examen, DICOM, les diapositives pathologiques, etc. Chaque couche doit avoir des clés uniques et être liée par des clés étrangères explicites, plutôt que de s'appuyer sur des relations devinées par noms de fichiers ou emplacements de répertoires.
L’ID stable au niveau du patient n’est pas destiné à préserver les informations d’identité réversibles. Il doit s'agir d'une clé pseudonymisée dans le cadre du projet, la véritable table de mappage d'identité est conservée séparément selon les exigences d'autorisation et les données de livraison ne comportent pas le mappage. La portée de l'ID de traitement, de l'ID de rapport, de l'ID d'étude/série d'imagerie et de l'ID de document doit également être clairement définie pour éviter que deux hôpitaux différents ou lots différents ne soient fusionnés par erreur après avoir généré le même numéro. La fusion entre systèmes doit enregistrer les règles de correspondance, la confiance et l'état de révision manuelle ; lorsqu'une correspondance fiable ne peut pas être obtenue, il est préférable de conserver le statut non associé plutôt que de forcer l'épissage.
Le champ heure doit au moins distinguer l'heure d'occurrence de l'événement, l'heure de collecte, l'heure de génération du rapport, l'heure de saisie, l'heure de modification et l'heure d'exportation. Ils sont souvent différents dans les dossiers médicaux. Les échantillons de test peuvent être collectés en premier et les résultats seront publiés plus tard ; les dossiers sur l'évolution de la maladie peuvent examiner et décrire les événements antérieurs ; le temps d’exportation du système ne peut pas remplacer le temps des événements cliniques. La préservation du fuseau horaire, de la précision, des champs source et des raisons manquantes permet à l'équipe d'algorithmes de déterminer quel moment doit être utilisé comme information visible pour éviter les fuites de données une fois le résultat généré dans l'entrée du modèle. Le système source, le fuseau horaire, la précision et les règles de conversion doivent également être décrits pour chaque type de champ horaire. Lorsqu'il n'y a qu'une date sans heure, la précision au niveau de la date doit être conservée et l'heure spécifique ne doit pas être rattrapée ; en cas de transfert inter-hôpital, d'enregistrement supplémentaire ultérieur ou de tri rétrospectif, l'incertitude de l'heure de l'événement doit être marquée. Les absences doivent également être différenciées entre les états non survenus, non acquis, non enregistrés, impossibles à associer et les accouchements manqués, car ces états ne sont pas identiques pour l'interprétation clinique et l'analyse des biais du modèle. Pour la tâche de prédiction, le dictionnaire de données doit définir clairement le moment de référence, l'heure limite de visibilité des caractéristiques, la fenêtre d'observation des résultats et la raison de l'arrêt du suivi, et, grâce à la vérification de l'échantillonnage chronologique au niveau du patient, confirmer que le modèle n'a pas lu les informations après que l'événement cible se soit produit.
Le texte complet du document, le type de document, la durée d'enregistrement, le statut de signature ou de révision et le traitement médical correspondant doivent être enregistrés. Si l'entreprise nécessite des événements structurés, les résultats de l'extraction doivent également établir un mappage de position avec les paragraphes du texte d'origine ou les numéros de page. De cette manière, les experts cliniques peuvent revenir aux preuves originales à des fins de vérification, les ingénieurs en algorithmes peuvent filtrer les échantillons par type de document et les ingénieurs de données peuvent vérifier la troncature et la duplication du texte. Pour les dossiers clés, l'acceptation doit se concentrer sur l'intégrité du texte, l'exactitude de la classification, la logique temporelle et l'association des patients ; un traitement excessif des champs non clés peut augmenter les erreurs et obscurcir le contenu original.
La multimodalité ne signifie pas placer les fichiers dans le même répertoire
Les données d'un patient peuvent inclure des textes sur l'évolution de la maladie, des valeurs de tests, des ordonnances de médicaments, des rapports de radiologie, des images DICOM, des rapports de pathologie et des diapositives plein champ. Ce n’est que lorsque les relations temporelles et sémantiques entre eux sont claires qu’un cas multimodal peut être constitué. Chaque image doit au moins pouvoir retrouver le patient correspondant, l'événement d'examen, la modalité, la partie du corps, la date d'acquisition et le rapport ; lorsque le rapport mentionne « comparaison avec le film précédent », l'image précédente et son rapport doivent également être inclus dans la chaîne de traçabilité. Les coupes pathologiques doivent être liées au site de prélèvement, à l'échantillon, à l'événement chirurgical ou de biopsie et à la conclusion pathologique. L'ontologie de séquence DICOM
et les champs d'en-tête clés contiennent non seulement des pixels d'image, mais également des informations techniques telles que la modalité, la date, l'espacement des voxels, l'épaisseur de la couche, la séquence, etc. La désensibilisation doit couvrir les balises standard, les balises privées, les noms de fichiers et les informations intégrées aux pixels, tout en essayant de préserver le contexte technique nécessaire pour mener à bien la tâche de recherche. Il doit être clair si la séquence est complète, si elle a été rééchantillonnée ou compressée, l'outil d'exportation et la version traitée. Si une capture d'écran est fournie, il convient d'indiquer quelles informations elle ne peut pas remplacer le DICOM d'origine afin d'éviter que les équipes en aval ne confondent la vignette avec des données d'image complètes.
Les « Packages Patients » sont un mode d'organisation qui facilite la délivrance et l'échantillonnage : regroupement de tableaux structurés, de documents PDF, de dossiers d'imagerie et de pathologie dans un même répertoire patient anonyme, et utilisation d'une liste pour indexer chaque dossier et ses événements associés. Mais le catalogue lui-même n’est qu’une coquille de livraison. Le modèle de données réel doit toujours avoir une structure de table claire, des clés primaires, des clés étrangères, des champs de date et des dictionnaires. La liste de contrôle doit répondre : quelles visites chaque patient a-t-il eu, quels documents et tests étaient présents pour chaque visite, ce qui manquait et si le manque était une inexistence structurelle ou une omission d'accouchement. Pour le mode « s'il y a une inspection », les conditions applicables et le calibre de comptage doivent être fournis en même temps pour éviter de traiter l'absence d'une certaine inspection comme un paiement manquant.
L'étude sur le parcours du patient publiée dans « Nature Medicine » en 2026 a proposé une méthode pour extraire des entités cliniques à partir de dossiers médicaux électroniques structurés et non structurés, les intégrer à des données codées et les organiser en parcours de patients interrogeables. Il illustre des orientations de recherche qui placent les rencontres, les médicaments, les tests, les signes vitaux et les symptômes dans le même contexte temporel.[2] Pour la chaîne d'approvisionnement des données, cela ne signifie pas que tous les projets doivent d'abord construire une carte des connaissances, mais cela signifie qu'une cartographie traçable doit être conservée entre les documents originaux et les données structurées, afin qu'une chronologie ou une structure graphique puisse être construite ultérieurement en fonction de tâches spécifiques.
Les variables cliniques conservent leur contexte d'origine et leur processus de changement
Les tableaux de chronométrage structurés ne doivent pas séparer la « valeur » de son état clinique. Les résultats des tests doivent au moins conserver le nom du projet, les résultats originaux, les unités, les intervalles de référence, l'identification des anomalies, les échantillons et l'heure de collecte ; les données sur les médicaments doivent distinguer les ordres médicaux, l'heure de début et de fin, la posologie, l'itinéraire, la fréquence et l'état d'exécution. La modification ou l'arrêt des prescriptions médicales peuvent eux-mêmes refléter des changements au cours de l'évolution de la maladie, et si seule la prescription définitive est retenue, le parcours thérapeutique sera perdu. L'échelle doit enregistrer le nom de l'échelle, la version, le score total et le score de l'élément pour faciliter le recalcul et la vérification. Si l'âge est généralisé ou regroupé, les règles de généralisation et les restrictions d'utilisation doivent être conservées, et les valeurs traitées ne doivent pas être confondues avec la mesure originale. Les diagnostics
ont également une sémantique temporelle. Le diagnostic préliminaire, le diagnostic révisé, le diagnostic de sortie et le diagnostic pathologique peuvent se compléter ou se modifier. La structure des données doit conserver l'heure du diagnostic, le type d'enregistrement, la version de codage et l'instrument source, et ne peut laisser qu'un seul code final. Si une étiquette unifiée est générée pour une certaine tâche modèle, il est nécessaire de créer un champ d'étiquette de tâche distinct et de conserver sa base de jugement. Cela permet d’étudier l’évolution du diagnostic et empêche les chercheurs ultérieurs de confondre les dossiers cliniques et les étiquettes de traitement.
Les connexions multimodales devraient passer du « même patient » au « même événement clinique ». Le même patient peut subir plusieurs examens de différentes parties le même jour, ou les examens peuvent être répétés dans un court laps de temps ; l’association uniquement par identifiant ou date du patient assemblera des images et des rapports sans rapport. L'association peut être établie via l'ID de traitement, le numéro de demande d'examen, l'ID de rapport, l'UID d'étude/série ou la clé d'événement interne. Une fois l’identifiant sensible désensibilisé, il sera remplacé par une clé anonyme stable. Avant la livraison, l'heure, le lieu et les références comparatives du rapport peuvent être extraits, et la liste d'index peut être automatiquement vérifiée, puis le personnel médical peut examiner les disparités, les couches manquantes ou les séquences temporelles déraisonnables.
Les cohortes de maladies et les étiquettes de résultats doivent être définies cliniquement conjointement Lors de la construction de la cohorte
, les critères d'inclusion de la maladie doivent être mis en œuvre dans le codage, le texte diagnostique et les preuves cliniques. S'appuyer uniquement sur un seul code de diagnostic peut inclure des cas qui ne répondent pas à la définition cible ; se contenter de regarder du texte libre peut également conduire à des erreurs de jugement dues à des synonymes, des négatifs ou des diagnostics historiques. Le dépistage par codage peut être utilisé comme dépistage préliminaire, puis nécessiter des preuves de base critiques, telles que des dossiers d'imagerie, de pathologie, de laboratoire ou spécialisés correspondants, et un examen médical pour traiter les échantillons contradictoires. Les versions de codage, les règles de mappage et les exceptions doivent être saisies dans le dictionnaire de données et les enregistrements d'acceptation.
Les cohortes multi-maladies et multi-départements doivent également examiner la structure de la population. Des facteurs tels que l'âge, le sexe, le stade de la maladie, la gravité de la maladie, le type de traitement, l'établissement et la période de temps affecteront les performances du modèle. Si un certain type d’échantillons est concentré dans un seul établissement, un seul appareil ou un certain parcours de diagnostic et de traitement, le modèle peut apprendre les habitudes institutionnelles plutôt que les schémas de maladie. Pour les maladies rares ou les cas complexes, l’ajout approprié de cas difficiles peut faciliter la formation et les tests, mais cela doit être cohérent avec l’utilisation cible et expliquer clairement comment les échantillons sont sélectionnés pour éviter de confondre la cohorte enrichie artificiellement avec la véritable distribution de la prévalence clinique.
Le champ de résultat doit comporter des règles de jugement, des fenêtres d'observation, des sources de preuves et des processus de révision. Une limite temporelle doit être définie entre les entrées du modèle et les étiquettes de résultats. Par exemple, pour prédire la récurrence future, les documents de récurrence après le point temporel de référence ne peuvent pas être saisis dans les entités en entrée ; des rapports d'imagerie ou de pathologie peuvent être générés après des événements cliniques, et il est également nécessaire d'éviter de voyager avant l'heure de prédiction. Il est préférable de diviser les données de formation, de validation et de test par groupe de patients ; lorsque l’objectif est de vérifier l’applicabilité interinstitutionnelle, l’ensemble de l’établissement doit être retenu pour des tests externes ; lorsque l’objectif est la migration temporelle, une période ultérieure doit être utilisée pour les tests. La répartition aléatoire par rapport peut entraîner la fuite de dossiers presque en double pour le même patient dans plusieurs collections.
Les progrès de l’IA en matière d’imagerie ont encore accru les besoins en données
CTPA est un test d'imagerie important pour l'évaluation de l'embolie pulmonaire. Une étude publiée dans « npj Digital Medicine » en 2025 a établi un modèle multimodal autour de l’imagerie CTPA, de la génération de rapports et de la prédiction des résultats. Les données utilisées couvraient plusieurs sources médicales et cohortes de patients, ce qui reflète le fait que la recherche passe d'une discrimination positive unique à une analyse conjointe d'images, de rapports et de résultats cliniques.[3] Les données requises pour ce type de tâche ne consistent pas seulement à « disposer d'une image CTPA » : elles nécessitent également la capacité d'aligner l'ensemble des images, les détails du rapport, le contexte clinique et les résultats du suivi, afin que nous puissions évaluer si le modèle peut résumer les lésions et prendre en charge l'analyse ultérieure.
En octobre 2026, une autre étude multi-institutionnelle dans le monde réel a rendu compte des performances réelles d'une IA commerciale pour l'embolie pulmonaire dans différents types d'examens et d'institutions, notant qu'il peut y avoir un écart de sensibilité selon les références des études de déploiement et d'enregistrement dans le monde réel.[4] Ce type de preuve rappelle aux équipes chargées des données que les performances d'un modèle une fois mis en ligne seront affectées par la composition des patients, le protocole d'examen, le stade de la maladie et le flux de travail institutionnel. L'ensemble de formation ne couvre qu'un certain protocole d'analyse ou un seul hôpital et ne peut pas être automatiquement extrapolé à d'autres hôpitaux ; le rapport de recherche doit décrire le dépistage des cas, l'équipement et les protocoles, la segmentation des données et les méthodes de validation externe.
Les ressources d'ensemble de données d'imagerie de la même année ont également commencé à fournir des informations plus fines telles que les étiquettes au niveau des tranches, les emplacements et les types d'embolisation.[5] Les étiquettes à granularité fine sont utiles pour les tâches de localisation et de sous-typage, mais plus les étiquettes sont fines, plus les exigences en matière de règles d'annotation, de plage d'images et d'accord d'experts sont élevées. Les mesures algorithmiques doivent être liées à l'utilisation clinique : le dépistage au niveau du cas, la localisation des lésions, la stratification de la gravité et la génération de rapports ne doivent pas partager un seul taux d'exactitude comme réponse finale. Pour les petites lésions ou les cas limites, la sensibilité, la spécificité, les indicateurs de stratification, les intervalles de confiance et les types d'erreur doivent tous être analysés séparément.
Langhui peut connecter l'ingénierie des données et l'examen clinique en boucle fermée
Pour les projets multimodaux à longue séquence, la présentation professionnelle de Langhui peut se concentrer sur « la définition des exigences, la modélisation au niveau du patient, la corrélation intermodale, l'examen de la qualité et la livraison révisable ». Lorsque le projet démarre, le type de maladie cible, le moment de départ, la définition des résultats et la plage de données sont conjointement confirmés ; au stade de l'échantillonnage, les associations de patients, les champs horaires, l'intégrité des documents et les séquences d'images sont vérifiés ; dans le lot formel, les défauts sont identifiés grâce à des listes de documents, des règles automatiques et des inspections par échantillonnage médical ; les versions et les enregistrements de réinspection sont conservés après les retouches. Chaque étape doit générer des champs, des journaux ou des critères d'acceptation vérifiables. La source de données spécifique et le statut d'autorisation doivent être confirmés en fonction du dossier de projet.
Cette méthode avance « si les données peuvent être soumises » jusqu'à « si ce lot de données peut répondre à la question cible ». Les clients peuvent vérifier les règles d'association et les lacunes dans les données au moment du POC, les équipes d'algorithmes peuvent évaluer si les entrées du modèle peuvent reconstruire la chronologie, les experts médicaux peuvent revenir aux documents et aux preuves de vérification par imagerie, et le personnel de gouvernance des données peut auditer les sources, la rédaction et modifier les processus. Pour les articles qui doivent être rachetés, le maintien de la cohérence de la structure du package patient, du dictionnaire de champs et de la version d'acceptation permettra d'économiser davantage que de réinterpréter le catalogue et les champs à chaque fois.
Questions fréquentes
Sur quelle période les données médicales des séries longues doivent-elles durer au moins ? Cela ne suffit pas. Vous ne pouvez pas répondre avec un seul nombre d'années. La fenêtre d'observation, la ligne de base, le nombre de visites de suivi et la détermination des résultats doivent être définis en fonction des objectifs de la recherche. Les spécifications de construction contenues dans la pièce jointe fixent un seuil de collecte de plus de trois ans, mais les tâches modèles spécifiques doivent encore définir des règles de début et de fin interprétables.
Pourquoi les inspections et les images doivent-elles conserver une heure précise ? Parce que la référence dans le dossier de cours, la génération des résultats des tests et l'acquisition d'images peuvent avoir lieu à des moments différents. Si seule la date ou la date d'exportation est retenue, il peut ne pas être possible de déterminer si un indicateur est disponible au moment de la prise de décision, ni de vérifier la relation séquentielle entre les rapports.
Comment sélectionner des échantillons POC représentatifs ? Les prélèvements croisés sur le même patient doivent généralement être évités. En utilisant davantage la segmentation temporelle ou les tests externes de l'organisation en fonction des tâches cibles, et en vérifiant les fichiers quasi-dupliqués et les fuites de modèles de rapport, nous pouvons obtenir une évaluation généralisée plus proche du déploiement réel.
Références
[1] Kaplan A, et al. Apprendre l'histoire naturelle des maladies humaines avec des transformateurs génératifs. Nature, 2025. https://doi.org/10.1038/s41586-025-09529-3
[2] Parcours longitudinaux calculables des patients à partir de données DSE structurées et non structurées. Médecine naturelle, 2026. https://www.nature.com/articles/s41591-026-04695-x
[3] Modèle de langage de vision pour la génération de rapports et la prédiction des résultats dans l'angiographie pulmonaire CT. npj Médecine numérique, 2025. https://www.nature.com/articles/s41746-025-01807-8
[4] Performances multisites réelles de l'IA commerciale pour la détection des embolies pulmonaires pulmonaires et accidentelles. npj Médecine numérique, 2026. https://www.nature.com/articles/s41746-026-03418-3
[5] Stanford AIMI. Ensemble de données d'angiographie pulmonaire CT. https://aimi.stanford.edu/datasets/CT-Pulmonary-Angiography