La pregunta de investigación determina la estructura del conjunto de datos
El diseño de un conjunto de datos longitudinal no puede comenzar con la estructura de carpetas, sino que primero debe aclarar qué preguntas quiere responder el modelo o estudio. La identificación temprana de la enfermedad requiere puntos temporales de referencia claros y ventanas de observación de seguimiento; el análisis de la respuesta al tratamiento requiere la secuencia entre la exposición al fármaco o a la cirugía, los resultados de las pruebas y los resultados; La predicción de recurrencia o reingreso requiere la definición de la fecha índice, la duración del seguimiento, los eventos de resultado y las reglas de pérdidas durante el seguimiento. Sin estas definiciones, el "período de tres años" es sólo un requisito de recopilación amplio y no garantiza que la muestra sea suficiente para respaldar un análisis específico.
Se recomienda aclarar cuatro cosas para cada caso: cuál es el punto de partida, cómo calcular el período de observación, cómo determinar el punto final y qué registros pertenecen a esta trayectoria. El punto de partida puede ser la fecha del primer diagnóstico, la evaluación previa al tratamiento, el ingreso o una prueba; el punto final puede ser recurrencia, progresión, muerte, reingreso, remisión o alcanzar una fecha límite de seguimiento específica. Para los pacientes con "eventos no observados", es necesario distinguir entre "el seguimiento está completo pero no ocurrió", "perdida temprana durante el seguimiento" y "no hay datos de seguimiento en el sistema de registro". Escribir estos estados como "sin resultado" provocará errores de etiquetado y sesgos en el seguimiento.
El estudio Delphi-2M publicado en "Nature" en 2025 utilizó cronogramas de enfermedades para modelar el riesgo futuro de múltiples enfermedades y fue validado externamente con datos de registros daneses después del entrenamiento en la cohorte británica, lo que demuestra el potencial de los datos de series temporales para el modelado de procesos de enfermedades. El estudio también señaló que el modelo puede aprender sesgos de selección y patrones faltantes en el conjunto de datos, por lo que el rendimiento de la predicción no puede explicarse de forma aislada de la composición de la cohorte y el mecanismo de generación de datos.[1] Esto tiene implicaciones directas para la construcción de datos: las marcas de tiempo, los motivos de la terminación del seguimiento, las instituciones de origen y los mecanismos faltantes son todos contextos que el modelo necesita conocer.
Pacientes, visitas, eventos y expedientes deben estar relacionados jerárquicamente
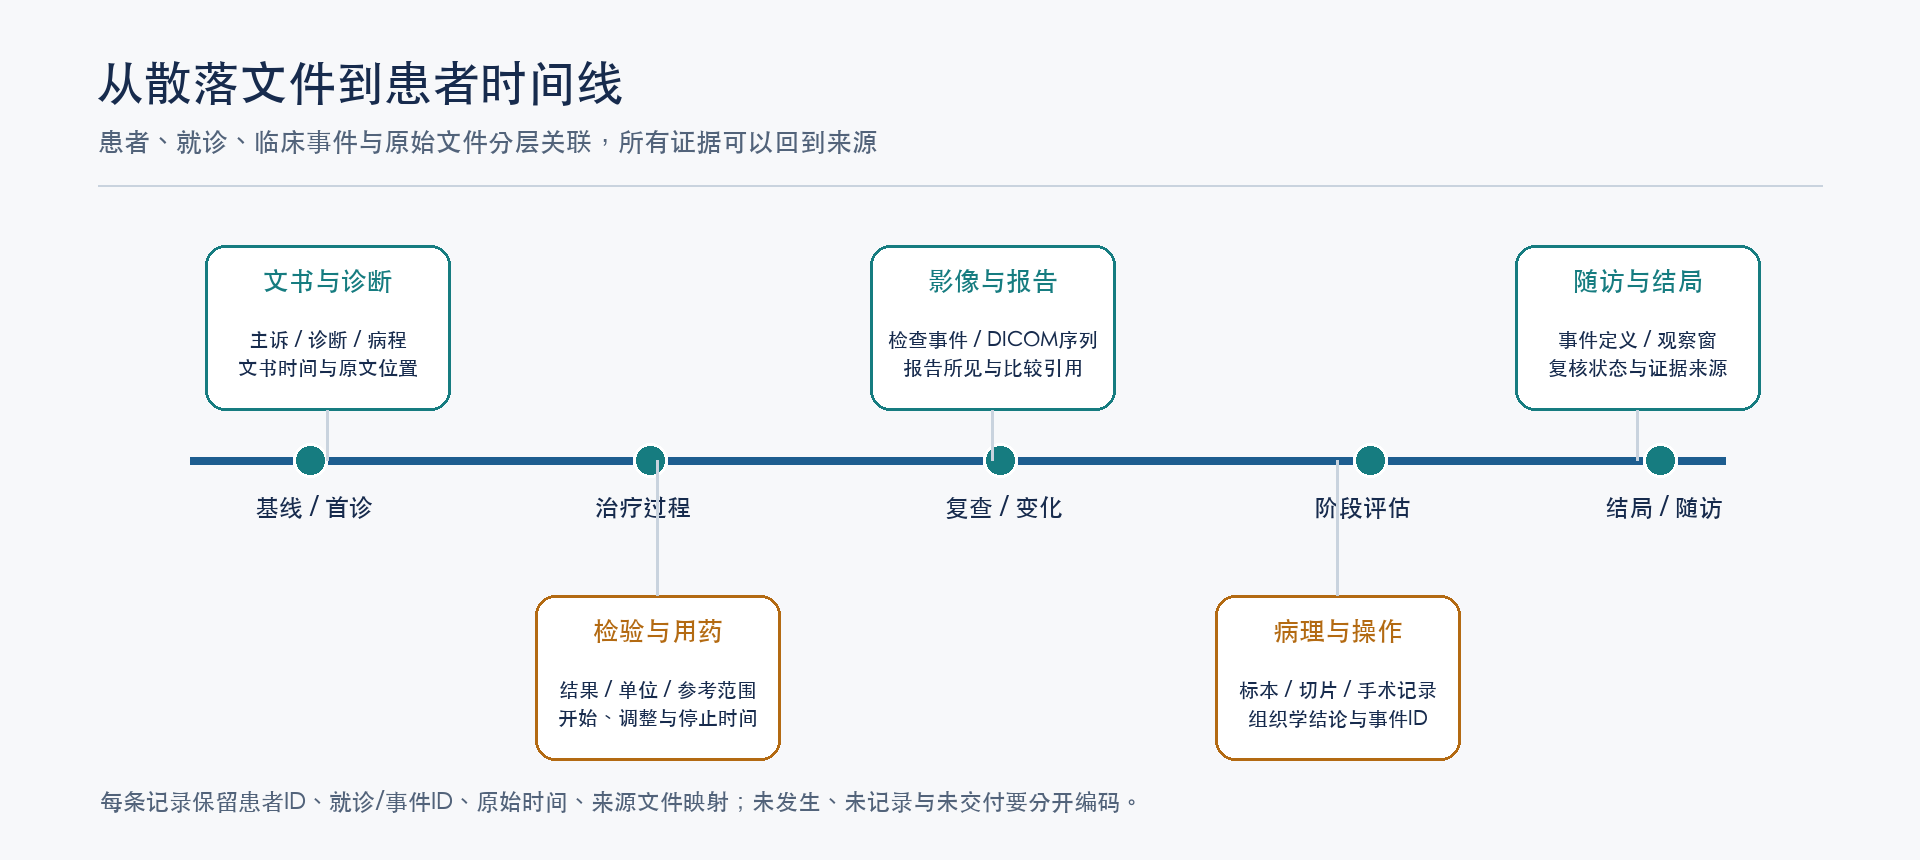
recomienda dividir los datos longitudinales en cuatro niveles interrelacionados. La capa de pacientes utiliza identificadores de pacientes anónimos y estables y es responsable de encadenar múltiples visitas de la misma persona; la capa de visitas registra eventos de pacientes ambulatorios, hospitalizaciones, departamentos de emergencia, traslados o seguimiento; la capa de eventos clínicos registra diagnósticos, síntomas, exámenes, pruebas, medicamentos, operaciones y resultados; la capa de archivos almacena soportes originales, como documentos sobre el curso de enfermedades, informes de exámenes, DICOM, portaobjetos patológicos, etc. Cada capa debe tener claves únicas y estar relacionadas mediante claves externas explícitas, en lugar de depender de adivinar relaciones por nombres de archivos o ubicaciones de directorios.
La identificación estable a nivel del paciente no pretende preservar información de identidad reversible. Debe ser una clave seudónima dentro del alcance del proyecto, la tabla de mapeo de identidad real se mantiene por separado de acuerdo con los requisitos de autorización y los datos de entrega no incluyen el mapeo. El alcance de la identificación del tratamiento, la identificación del informe, la identificación del estudio/serie de imágenes y la identificación del documento también deben definirse claramente para evitar que dos hospitales diferentes o lotes diferentes se fusionen por error después de generar el mismo número. La fusión entre sistemas debe registrar las reglas de coincidencia, la confianza y el estado de revisión manual; cuando no se puede lograr una coincidencia confiable, conservar el estado no asociado es mejor que realizar un empalme forzado.
El campo de hora debe distinguir al menos la hora de ocurrencia del evento, la hora de recopilación, la hora de generación del informe, la hora de entrada, la hora de modificación y la hora de exportación. A menudo son diferentes en los registros médicos. Las muestras de prueba se pueden recolectar primero y los resultados se publicarán más tarde; los registros del curso de la enfermedad pueden revisar y describir eventos anteriores; El tiempo de exportación del sistema no puede reemplazar el tiempo de los eventos clínicos. Preservar la zona horaria, la precisión, los campos de origen y los motivos faltantes permite al equipo del algoritmo determinar qué momento debe usarse como información visible para evitar la filtración de datos después de que se genera el resultado en la entrada del modelo. También se deben describir el sistema de origen, la zona horaria, la precisión y las reglas de conversión para cada tipo de campo de hora. Cuando solo hay una fecha sin hora, se debe conservar la precisión del nivel de fecha y no se debe recuperar la hora específica; cuando hay traslado entre hospitales, registro suplementario posterior o clasificación retrospectiva, se debe marcar la incertidumbre del momento del evento. La pérdida también debe diferenciarse entre no ocurrir, no adquirirse, no registrarse, no poder asociarse y entrega perdida, ya que estos estados no son idénticos para la interpretación clínica y el análisis de sesgo del modelo. Para la tarea de predicción, el diccionario de datos debe definir claramente el punto de tiempo de referencia, el tiempo de corte de visibilidad de la característica, la ventana de observación de resultados y el motivo de la finalización del seguimiento y, a través de la verificación del muestreo de la línea de tiempo a nivel del paciente, confirmar que el modelo no ha leído información después de que ocurre el evento objetivo.
Se debe guardar el texto completo del documento, tipo de documento, hora de registro, estado de firma o revisión y tratamiento médico correspondiente. Si el negocio requiere eventos estructurados, los resultados de la extracción también deben establecer un mapeo de posición con los párrafos del texto original o los números de página. De esta manera, los expertos clínicos pueden volver a la evidencia original para su verificación, los ingenieros de algoritmos pueden filtrar muestras por tipo de documento y los ingenieros de datos pueden verificar el truncamiento y la duplicación del texto. Para registros clave, el foco de la aceptación debe estar en la integridad del texto, la precisión de la clasificación, la lógica del tiempo y la asociación del paciente; el procesamiento excesivo de campos no clave puede aumentar los errores y oscurecer el contenido original.
Multimodalidad no significa colocar archivos en el mismo directorio
Los datos de un paciente pueden incluir texto sobre el curso de la enfermedad, valores de pruebas, órdenes de medicación, informes de radiología, imágenes DICOM, informes de patología y diapositivas de campo completo. Sólo cuando las relaciones temporales y semánticas entre ellos sean claras se podrá constituir un caso multimodal. Cada imagen debe poder encontrar al menos el paciente correspondiente, evento de examen, modalidad, parte del cuerpo, fecha de adquisición e informe; cuando el informe menciona "comparación con la película anterior", la imagen anterior y su informe también deben incluirse en la cadena de trazabilidad. Las secciones patológicas deben estar relacionadas con el sitio de muestreo, la muestra, el evento quirúrgico o de biopsia y la conclusión patológica.
La ontología de secuencia DICOM y los campos de encabezado clave contienen no solo píxeles de la imagen, sino también información técnica como modalidad, fecha, espaciado de vóxeles, espesor de capa, secuencia, etc. La desensibilización debe cubrir etiquetas estándar, etiquetas privadas, nombres de archivos e información incrustada en píxeles, al tiempo que se intenta preservar el contexto técnico necesario para completar la tarea de investigación. Debe quedar claro si la secuencia está completa, si ha sido remuestreada o comprimida, la herramienta de exportación y la versión procesada. Si se proporciona una captura de pantalla, se debe marcar qué información no puede reemplazar el DICOM original para evitar que los equipos posteriores confundan la miniatura con datos de imagen completos.
Los "paquetes de pacientes" son un método de organización que facilita la entrega y el muestreo: agrupando tablas estructuradas, documentos PDF, archivos de imágenes y patología en el mismo directorio anónimo de pacientes, y utilizando una lista para indexar cada archivo y sus eventos asociados. Pero el catálogo en sí es sólo una envoltura de entrega. El modelo de datos real aún necesita tener una estructura de tabla clara, claves primarias, claves externas, campos de fecha y diccionarios. La lista de verificación debe responder: qué visitas tuvo cada paciente, qué trámites y pruebas hubo en cada visita, qué faltaba y si la falta fue una inexistencia estructural o una omisión en el parto. Para la modalidad "si hay alguna inspección", se deben proporcionar al mismo tiempo las condiciones aplicables y el calibre de conteo para evitar tratar la ausencia de una determinada inspección como un pago faltante.
El estudio sobre el recorrido del paciente publicado en "Nature Medicine" en 2026 propuso un método para extraer entidades clínicas de registros médicos electrónicos estructurados y no estructurados, integrarlas con datos codificados y organizarlas en recorridos del paciente consultables. Ilustra direcciones de investigación que sitúan los encuentros, los medicamentos, las pruebas, los signos vitales y los síntomas en el mismo contexto temporal.[2] Para la cadena de suministro de datos, esto no significa que todos los proyectos deban construir primero un mapa de conocimiento, pero significa que se debe conservar un mapeo rastreable entre los documentos originales y los datos estructurados, de modo que más adelante se pueda construir una línea de tiempo o una estructura gráfica basada en tareas específicas.
Las variables clínicas conservan su contexto original y proceso de cambio.
Las tablas de tiempos estructuradas no deben separar el "valor" de su condición clínica. Los resultados de la prueba deben conservar al menos el nombre del proyecto, los resultados originales, las unidades, los intervalos de referencia, la identificación anormal, las muestras y el tiempo de recolección; los datos del medicamento deben distinguir órdenes médicas, hora de inicio y finalización, dosis, vía, frecuencia y estado de ejecución. La modificación o interrupción de las órdenes médicas puede reflejar en sí mismas cambios en el curso de la enfermedad, y si sólo se conserva la prescripción final, se perderá la trayectoria del tratamiento. La escala debe guardar el nombre de la escala, la versión, la puntuación total y la puntuación del ítem para facilitar el recálculo y la verificación. Si la edad se generaliza o se agrupa, se deben conservar las reglas de generalización y las restricciones de uso, y los valores procesados no se deben confundir con la medición original. Los diagnósticos
también tienen semántica de tiempo. El diagnóstico preliminar, el diagnóstico revisado, el diagnóstico de alta y el diagnóstico patológico pueden complementarse o modificarse entre sí. La estructura de datos debe conservar el momento del diagnóstico, el tipo de registro, la versión de codificación y el instrumento fuente, y no puede dejar un solo código final. Si se genera una etiqueta unificada para una determinada tarea modelo, es necesario crear un campo de etiqueta de tarea separado y conservar su base de juicio. Esto permite el estudio de la evolución diagnóstica y evita que investigadores posteriores combinen registros clínicos y etiquetas de procesamiento.
Las conexiones multimodales deberían caer aún más de “mismo paciente” a “mismo evento clínico”. El mismo paciente puede someterse a múltiples exámenes de diferentes partes el mismo día, o las exploraciones pueden repetirse en un corto período de tiempo; La asociación solo por ID de paciente o fecha unirá imágenes e informes no relacionados. La asociación se puede establecer a través del ID del tratamiento, el número de solicitud de examen, el ID del informe, el UID del estudio/serie o la clave de evento interno. Una vez que se desensibilice el identificador confidencial, será reemplazado por una clave anónima estable. Antes de la entrega, se pueden extraer la hora, la ubicación y las referencias comparativas del informe, y la lista de índice se puede verificar automáticamente, y luego el personal médico puede revisar las discrepancias, las capas faltantes o las secuencias de tiempo irrazonables.
Las cohortes de enfermedades y las etiquetas de resultados deben definirse clínicamente de forma conjunta Al construir la cohorte
, se deben implementar criterios de inclusión de enfermedades en la codificación, el texto de diagnóstico y la evidencia clínica. Depender únicamente de un único código de diagnóstico puede incluir casos que no cumplen con la definición objetivo; Mirar únicamente texto libre también puede llevar a errores de juicio debido a sinónimos, negativos o diagnósticos históricos. La detección de codificación se puede utilizar como una evaluación preliminar y luego requiere respaldo de evidencia de referencia crítica, como imágenes correspondientes, patología, registros de laboratorio o especialistas, y una revisión médica para manejar muestras conflictivas. Las versiones de codificación, las reglas de mapeo y las excepciones deben ingresarse en el diccionario de datos y en los registros de aceptación.
Las cohortes de múltiples enfermedades y departamentos también deben examinar la estructura de la población. Factores como la edad, el sexo, el estadio de la enfermedad, la gravedad de la enfermedad, el tipo de tratamiento, la institución y el período de tiempo afectarán el rendimiento del modelo. Si cierto tipo de muestras se concentran en una sola institución, un solo dispositivo o una determinada ruta de diagnóstico y tratamiento, el modelo puede aprender hábitos institucionales en lugar de patrones de enfermedad. Para enfermedades raras o casos complejos, agregar adecuadamente casos difíciles puede ayudar a la capacitación y las pruebas, pero debe ser consistente con el uso objetivo y explicar claramente cómo se analizan las muestras para evitar confundir la cohorte enriquecida artificialmente con la verdadera distribución de prevalencia clínica.
El campo de resultados debe tener reglas de juicio, ventanas de observación, fuentes de evidencia y procesos de revisión. Se debe establecer un límite de tiempo entre las entradas del modelo y las etiquetas de resultados. Por ejemplo, para predecir la recurrencia futura, los documentos de recurrencia posteriores al punto de tiempo de referencia no se pueden ingresar en las entidades de entrada; Se pueden generar informes de imágenes o patología después de eventos clínicos, y también es necesario evitar viajar antes del momento de predicción. Es mejor dividir los datos de capacitación, validación y pruebas por grupo de pacientes; cuando el objetivo es verificar la aplicabilidad interinstitucional, se debe contratar a toda la institución para pruebas externas; cuando el objetivo es la migración temporal, se debe utilizar un período de tiempo posterior para las pruebas. La división aleatoria por informe puede filtrar registros casi duplicados del mismo paciente en varias colecciones.
Los avances en la IA de imágenes han aumentado aún más los requisitos de datos
CTPA es una prueba de imagen importante para la evaluación de la embolia pulmonar. Un estudio publicado en "npj Digital Medicine" en 2025 estableció un modelo multimodal en torno a las imágenes CTPA, la generación de informes y la predicción de resultados. Los datos utilizados cubrieron múltiples fuentes médicas y cohortes de pacientes, lo que refleja que la investigación está pasando de la discriminación positiva única al análisis conjunto de imágenes, informes y resultados clínicos.[3] Los datos necesarios para este tipo de tarea no son solo "tener una imagen CTPA": también requiere la capacidad de alinear todo el conjunto de imágenes, informar detalles, contexto clínico y resultados de seguimiento, de modo que podamos evaluar si el modelo puede resumir las lesiones y respaldar el análisis posterior.
En octubre de 2026, otro estudio multiinstitucional del mundo real informó sobre el rendimiento real de una IA comercial para embolia pulmonar en diferentes tipos de exámenes e instituciones, y señaló que puede haber una brecha en la sensibilidad según los puntos de referencia de los estudios de registro e implementación en el mundo real.[4] Este tipo de evidencia recuerda a los equipos de datos que el rendimiento de un modelo una vez que entre en funcionamiento se verá afectado por la composición de los pacientes, el protocolo de examen, la etapa de la enfermedad y el flujo de trabajo institucional. El conjunto de formación solo cubre un determinado protocolo de exploración o un único hospital y no se puede extrapolar automáticamente a otros hospitales; el informe de investigación debe describir la selección de casos, equipos y protocolos, segmentación de datos y métodos de validación externa.
Los recursos del conjunto de datos de imágenes del mismo año también comenzaron a proporcionar información más detallada, como etiquetas a nivel de corte, ubicaciones y tipos de embolización.[5] Las etiquetas de grano fino son útiles para tareas de localización y subtipificación, pero cuanto más finas sean las etiquetas, mayores serán los requisitos de reglas de anotación, rango de imágenes y acuerdo de expertos. Las métricas algorítmicas deben estar vinculadas al uso clínico: la detección a nivel de caso, la localización de lesiones, la estratificación de la gravedad y la generación de informes no deben compartir una única tasa de precisión como respuesta final. Para lesiones pequeñas o casos límite, la sensibilidad, la especificidad, los indicadores de estratificación, los intervalos de confianza y los tipos de error deben analizarse por separado.
Langhui puede conectar la ingeniería de datos y la revisión clínica en un circuito cerrado
Para proyectos multimodales de secuencia larga, la presentación profesional de Langhui puede centrarse en "definición de requisitos, modelado a nivel de paciente, correlación intermodal, revisión de calidad y entrega revisable". Cuando se inicia el proyecto, se confirman conjuntamente el tipo de enfermedad objetivo, el momento del inicio, la definición de resultados y el rango de datos; en la etapa de muestreo se verifican las asociaciones de pacientes, los campos de tiempo, la integridad de los documentos y las secuencias de imágenes; en el lote formal, los defectos se identifican mediante listas de documentos, reglas automáticas e inspecciones por muestreo médico; Las versiones y los registros de reinspección se conservan después del retrabajo. Cada paso debe generar campos verificables, registros o criterios de aceptación. La fuente de datos específica y el estado de la autorización deben confirmarse de acuerdo con el archivo del proyecto.
Este método avanza "si los datos se pueden enviar" a "si este lote de datos puede responder a la pregunta de destino". Los clientes pueden verificar las reglas de asociación y las lagunas de datos en el momento de la POC, los equipos de algoritmos pueden evaluar si las entradas del modelo pueden reconstruir la línea de tiempo, los expertos médicos pueden volver a documentos y evidencia de verificación de imágenes, y el personal de gobierno de datos puede auditar fuentes, procesos de redacción y cambio. Para los artículos que deben recomprarse, mantener consistentes la estructura del paquete del paciente, el diccionario de campos y la versión de aceptación ahorrará más costos que reinterpretar el catálogo y los campos cada vez.
Preguntas frecuentes
¿Cuántos años deben tener al menos los datos médicos de series largas? No es suficiente. No se puede responder con un solo número de años. La ventana de observación, la línea de base, el número de visitas de seguimiento y la determinación de los resultados deben definirse de acuerdo con los objetivos de la investigación. Las especificaciones de construcción en el archivo adjunto establecen más de tres años como umbral de recolección, pero las tareas específicas del modelo aún necesitan establecer reglas de tiempo de inicio y finalización interpretables.
¿Por qué las inspecciones y las imágenes deben conservar la hora exacta? Porque la referencia en el registro del curso, la generación de resultados de pruebas y la adquisición de imágenes pueden ocurrir en diferentes momentos. Si solo se conserva la fecha o la fecha de exportación, es posible que no sea posible determinar si un indicador está disponible en el momento de la toma de decisiones, ni verificar la relación secuencial entre los informes.
¿Cómo se deben seleccionar muestras de POC representativas? En general, se debe evitar la recogida cruzada del mismo paciente. Al utilizar más la segmentación del tiempo o pruebas externas de la organización según las tareas objetivo y verificar si hay archivos casi duplicados y fugas de plantillas de informes, podemos obtener una evaluación generalizada que se acerque más a la implementación real.
Referencias
[1] Kaplan A, et al. Aprender la historia natural de las enfermedades humanas con transformadores generativos. Naturaleza, 2025. https://doi.org/10.1038/s41586-025-09529-3
[2] Recorridos longitudinales computables del paciente a partir de datos EHR estructurados y no estructurados. Medicina natural, 2026. https://www.nature.com/articles/s41591-026-04695-x
[3] Modelo visión-lenguaje para generación de informes y predicción de resultados en angiografía pulmonar por TC. npj Medicina digital, 2025. https://www.nature.com/articles/s41746-025-01807-8
[4] Rendimiento en múltiples sitios en el mundo real de la IA comercial para la detección de embolia pulmonar pulmonar e incidental. npj Medicina digital, 2026. https://www.nature.com/articles/s41746-026-03418-3
[5] Stanford AIMI. Conjunto de datos de angiografía pulmonar por TC. https://aimi.stanford.edu/datasets/CT-Pulmonary-Angiography