अनुसंधान प्रश्न डेटा सेट संरचना निर्धारित करता है
अनुदैर्ध्य डेटा सेट का डिज़ाइन फ़ोल्डर संरचना से शुरू नहीं हो सकता है, लेकिन पहले यह स्पष्ट करना होगा कि मॉडल या अध्ययन किन प्रश्नों का उत्तर देना चाहता है। रोग की प्रारंभिक पहचान के लिए स्पष्ट आधारभूत समय बिंदुओं और अनुवर्ती अवलोकन विंडो की आवश्यकता होती है; उपचार प्रतिक्रिया विश्लेषण के लिए दवा या सर्जिकल एक्सपोज़र, परीक्षण के परिणाम और परिणामों के बीच अनुक्रम की आवश्यकता होती है; पुनरावृत्ति या पुनः प्रवेश की भविष्यवाणी के लिए सूचकांक तिथि, अनुवर्ती अवधि, परिणाम की घटनाओं और हानि-से-अनुवर्ती नियमों की परिभाषा की आवश्यकता होती है। इन परिभाषाओं के बिना, "तीन-वर्षीय समय अवधि" केवल एक व्यापक संग्रह आवश्यकता है और यह गारंटी नहीं देती है कि नमूना विशिष्ट विश्लेषण का समर्थन करने के लिए पर्याप्त है।
प्रत्येक मामले के लिए चार चीजों को स्पष्ट करने की सिफारिश की गई है: प्रारंभिक बिंदु क्या है, अवलोकन अवधि की गणना कैसे करें, अंतिम बिंदु कैसे निर्धारित करें, और कौन से रिकॉर्ड इस प्रक्षेपवक्र से संबंधित हैं। शुरुआती बिंदु पहले निदान, पूर्व-उपचार मूल्यांकन, प्रवेश या परीक्षण की तारीख हो सकती है; अंतिम बिंदु पुनरावृत्ति, प्रगति, मृत्यु, पुन: प्रवेश, छूट, या एक निर्दिष्ट अनुवर्ती समय सीमा तक पहुंचना हो सकता है।"अनदेखी घटनाओं" वाले रोगियों के लिए, "फ़ॉलो-अप पूरा हो गया है लेकिन घटित नहीं हुआ", "फ़ॉलो-अप में जल्दी खो जाना" और "रिकॉर्डिंग सिस्टम में कोई फ़ॉलो-अप डेटा नहीं" के बीच अंतर करना आवश्यक है। इन स्थितियों को "कोई परिणाम नहीं" के रूप में लिखने से लेबलिंग त्रुटियां और अनुवर्ती पूर्वाग्रह पैदा होंगे।
2025 में "नेचर" में प्रकाशित डेल्फ़ी-2M अध्ययन में कई बीमारियों के भविष्य के जोखिम को मॉडल करने के लिए रोग समयसीमा का उपयोग किया गया था, और ब्रिटिश समूह में प्रशिक्षण के बाद डेनिश रजिस्ट्री डेटा के साथ बाहरी रूप से मान्य किया गया था, जो रोग प्रक्रिया मॉडलिंग के लिए समय श्रृंखला डेटा की क्षमता का प्रदर्शन करता था। अध्ययन में यह भी बताया गया है कि मॉडल डेटा सेट में चयन पूर्वाग्रह और लापता पैटर्न सीख सकता है, इसलिए पूर्वानुमान प्रदर्शन को समूह संरचना और डेटा उत्पादन तंत्र से अलग करके नहीं समझाया जा सकता है।[1] इसका डेटा निर्माण पर सीधा प्रभाव पड़ता है: टाइमस्टैम्प, फॉलो-अप की समाप्ति के कारण, स्रोत संस्थान और लापता तंत्र सभी संदर्भ हैं जिन्हें मॉडल को जानना आवश्यक है।
मरीजों, मुलाक़ातों, घटनाओं और फ़ाइलों को श्रेणीबद्ध रूप से संबंधित करने की आवश्यकता है
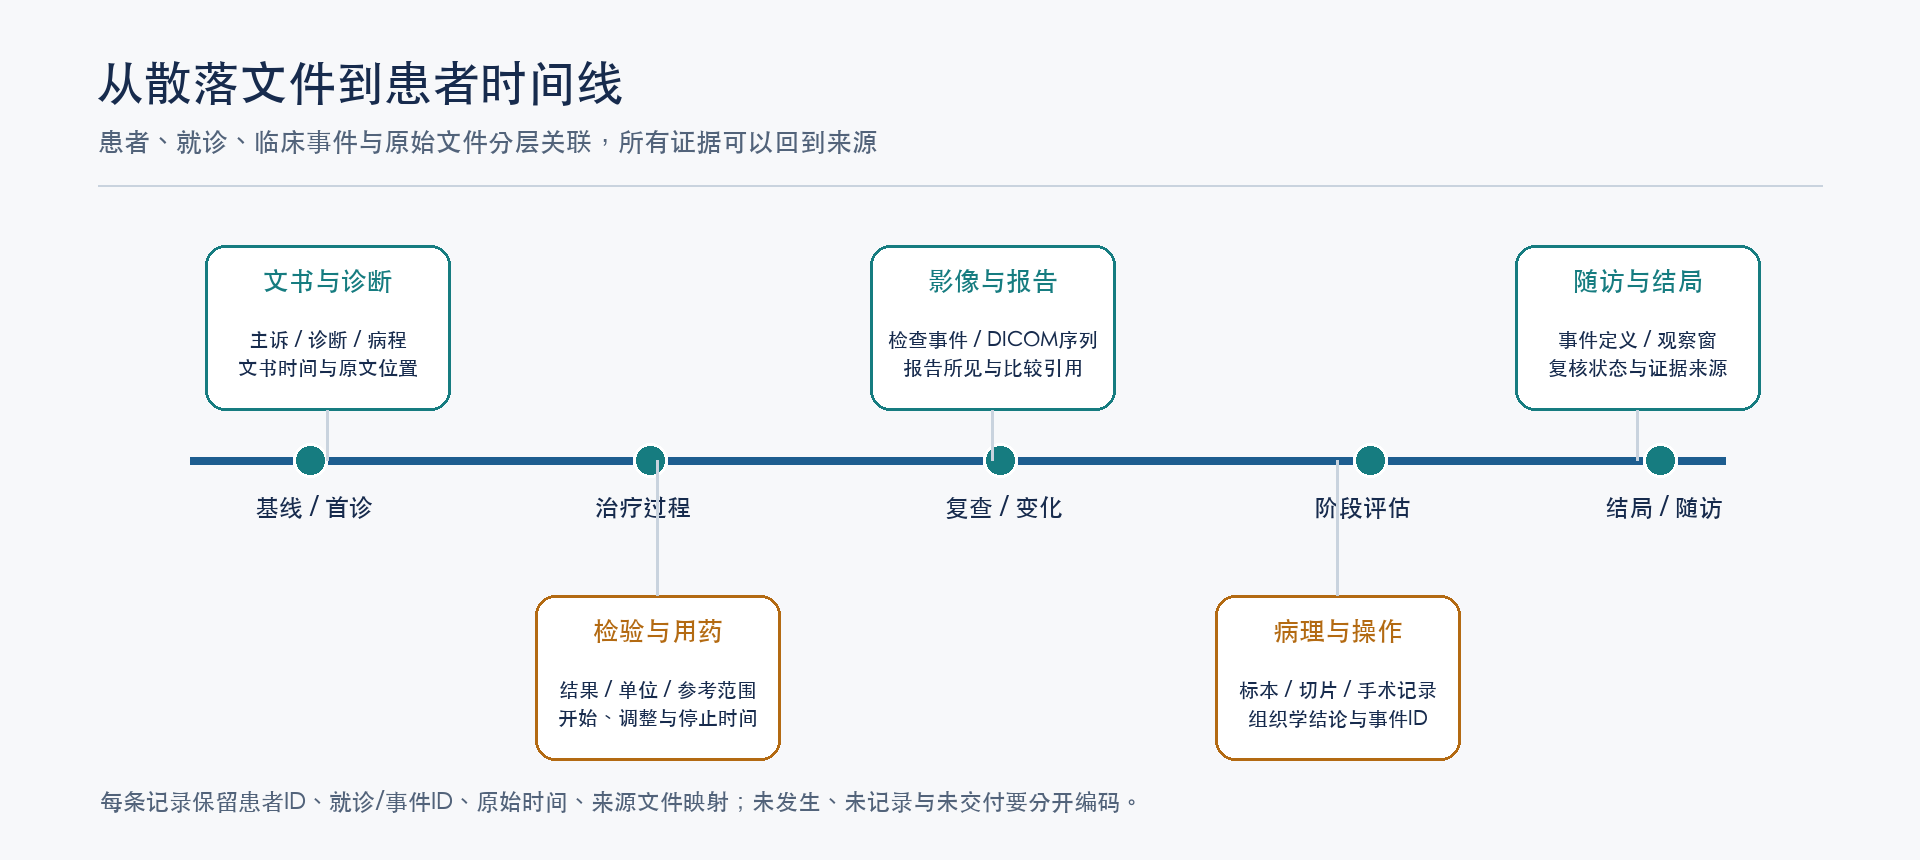
अनुदैर्ध्य डेटा को चार परस्पर संबंधित स्तरों में विभाजित करने की अनुशंसा करता है। रोगी परत अज्ञात और स्थिर रोगी पहचानकर्ताओं का उपयोग करती है और एक ही व्यक्ति की कई यात्राओं को एक साथ जोड़ने के लिए जिम्मेदार है; विज़िट परत बाह्य रोगी, अस्पताल में भर्ती, आपातकालीन विभाग, स्थानांतरण या अनुवर्ती घटनाओं को रिकॉर्ड करती है; नैदानिक घटना परत निदान, लक्षण, परीक्षा, परीक्षण, दवाएं, संचालन और परिणाम रिकॉर्ड करती है; फ़ाइल परत मूल वाहक जैसे रोग पाठ्यक्रम दस्तावेज़, परीक्षा रिपोर्ट, डीआईसीओएम, पैथोलॉजिकल स्लाइड इत्यादि संग्रहीत करती है। प्रत्येक परत में अद्वितीय कुंजियाँ होनी चाहिए और फ़ाइल नाम या निर्देशिका स्थानों के आधार पर संबंधों का अनुमान लगाने पर निर्भर होने के बजाय स्पष्ट विदेशी कुंजियों से संबंधित होना चाहिए।
रोगी-स्तरीय स्थिर आईडी का उद्देश्य प्रतिवर्ती पहचान जानकारी को संरक्षित करना नहीं है। यह परियोजना के दायरे में एक छद्म नाम वाली कुंजी होनी चाहिए, वास्तविक पहचान मैपिंग तालिका प्राधिकरण आवश्यकताओं के अनुसार अलग से रखी जाती है, और डिलीवरी डेटा में मैपिंग नहीं होती है। दो अलग-अलग अस्पतालों या अलग-अलग बैचों को एक ही नंबर जनरेट करने के बाद गलती से विलय होने से रोकने के लिए उपचार आईडी, रिपोर्ट आईडी, इमेजिंग अध्ययन/श्रृंखला आईडी और दस्तावेज़ आईडी के दायरे को भी स्पष्ट रूप से परिभाषित करने की आवश्यकता है। क्रॉस-सिस्टम विलय में मिलान नियमों, आत्मविश्वास और मैन्युअल समीक्षा स्थिति को रिकॉर्ड किया जाना चाहिए; जब विश्वसनीय मिलान प्राप्त नहीं किया जा सकता है, तो असंबद्ध स्थिति को बनाए रखना जबरन जोड़ने से बेहतर है।
समय फ़ील्ड को कम से कम घटना घटित होने का समय, संग्रह समय, रिपोर्ट निर्माण समय, प्रवेश समय, संशोधन समय और निर्यात समय में अंतर करना चाहिए। वे अक्सर मेडिकल रिकॉर्ड में भिन्न होते हैं। परीक्षण नमूने पहले एकत्र किए जा सकते हैं और परिणाम बाद में जारी किए जाएंगे; रोग पाठ्यक्रम रिकॉर्ड पिछली घटनाओं की समीक्षा और वर्णन कर सकते हैं; सिस्टम निर्यात समय नैदानिक घटनाओं के समय को प्रतिस्थापित नहीं कर सकता। समय क्षेत्र, परिशुद्धता, स्रोत फ़ील्ड और लापता कारणों को संरक्षित करने से एल्गोरिदम टीम को यह निर्धारित करने की अनुमति मिलती है कि मॉडल इनपुट में परिणाम उत्पन्न होने के बाद डेटा को लीक होने से बचाने के लिए समय के किस बिंदु को दृश्य जानकारी के रूप में उपयोग किया जाना चाहिए। प्रत्येक प्रकार के समय क्षेत्र के लिए स्रोत प्रणाली, समय क्षेत्र, परिशुद्धता और रूपांतरण नियमों का भी वर्णन किया जाना चाहिए। जब समय के बिना केवल एक तारीख होती है, तो तारीख-स्तरीय सटीकता बरकरार रखी जानी चाहिए और विशिष्ट समय नहीं बनाया जाना चाहिए; जब क्रॉस-हॉस्पिटल स्थानांतरण, बाद में पूरक रिकॉर्डिंग, या पूर्वव्यापी छँटाई होती है, तो घटना के समय की अनिश्चितता को चिह्नित किया जाना चाहिए। गुम होने को घटित न होने, अर्जित न होने, दर्ज न होने, संबद्ध न हो पाने और छूटी हुई डिलीवरी के बीच भी विभेदित किया जाना चाहिए, क्योंकि ये स्थितियाँ नैदानिक व्याख्या और मॉडल पूर्वाग्रह विश्लेषण के लिए समान नहीं हैं। भविष्यवाणी कार्य के लिए, डेटा डिक्शनरी को बेसलाइन समय बिंदु, सुविधा दृश्यता कटऑफ समय, परिणाम अवलोकन विंडो और फॉलो-अप की समाप्ति का कारण स्पष्ट रूप से परिभाषित करना होगा, और रोगी-स्तरीय समयरेखा नमूनाकरण सत्यापन के माध्यम से पुष्टि करनी होगी कि लक्ष्य घटना होने के बाद मॉडल ने जानकारी नहीं पढ़ी है।
दस्तावेज़ का पूरा पाठ, दस्तावेज़ प्रकार, रिकॉर्डिंग समय, हस्ताक्षर या संशोधन स्थिति और संबंधित चिकित्सा उपचार सहेजा जाना चाहिए। यदि व्यवसाय को संरचित घटनाओं की आवश्यकता होती है, तो निष्कर्षण परिणामों को मूल पाठ पैराग्राफ या पृष्ठ संख्याओं के साथ स्थिति मानचित्रण भी स्थापित करना होगा। इस तरह, नैदानिक विशेषज्ञ सत्यापन के लिए मूल साक्ष्य पर वापस जा सकते हैं, एल्गोरिदम इंजीनियर दस्तावेज़ प्रकार के आधार पर नमूनों को फ़िल्टर कर सकते हैं, और डेटा इंजीनियर टेक्स्ट ट्रंकेशन और दोहराव की जांच कर सकते हैं। प्रमुख रिकॉर्ड के लिए, स्वीकृति का ध्यान पाठ अखंडता, वर्गीकरण सटीकता, समय तर्क और रोगी संगति पर होना चाहिए; गैर-कुंजी फ़ील्ड के अति-प्रसंस्करण से त्रुटियाँ बढ़ सकती हैं और मूल सामग्री अस्पष्ट हो सकती है।
मल्टीमॉडैलिटी का मतलब फ़ाइलों को एक ही निर्देशिका में रखना नहीं है
एक मरीज के डेटा में रोग पाठ्यक्रम पाठ, परीक्षण मूल्य, दवा के आदेश, रेडियोलॉजी रिपोर्ट, DICOM छवियां, पैथोलॉजी रिपोर्ट और पूर्ण-क्षेत्र स्लाइड शामिल हो सकते हैं। केवल तभी जब उनके बीच लौकिक और अर्थ संबंधी संबंध स्पष्ट हों, एक मल्टीमॉडल मामला गठित किया जा सकता है। प्रत्येक छवि को कम से कम संबंधित रोगी, परीक्षा घटना, तौर-तरीके, शरीर के अंग, अधिग्रहण की तारीख और रिपोर्ट ढूंढने में सक्षम होना चाहिए; जब रिपोर्ट में "पिछली फिल्म के साथ तुलना" का उल्लेख किया गया है, तो पिछली छवि और उसकी रिपोर्ट को भी ट्रैसेबिलिटी श्रृंखला में शामिल किया जाना चाहिए। पैथोलॉजिकल अनुभागों को नमूना स्थल, नमूना, सर्जिकल या बायोप्सी घटना और पैथोलॉजिकल निष्कर्ष से संबंधित होना चाहिए।
DICOM अनुक्रम ऑन्कोलॉजी और कुंजी हेडर फ़ील्ड में न केवल छवि पिक्सेल होते हैं, बल्कि तकनीकी जानकारी जैसे मोडेलिटी, दिनांक, स्वर रिक्ति, परत मोटाई, अनुक्रम इत्यादि भी होते हैं। शोध कार्य को पूरा करने के लिए आवश्यक तकनीकी संदर्भ को संरक्षित करने का प्रयास करते समय डिसेन्सिटाइजेशन में मानक टैग, निजी टैग, फ़ाइल नाम और पिक्सेल-एम्बेडेड जानकारी शामिल होनी चाहिए। यह स्पष्ट होना चाहिए कि क्या अनुक्रम पूरा हो गया है, क्या इसे पुन: नमूना लिया गया है या संपीड़ित किया गया है, निर्यात उपकरण और संसाधित संस्करण। यदि एक स्क्रीनशॉट प्रदान किया जाता है, तो इसे चिह्नित किया जाना चाहिए कि कौन सी जानकारी मूल DICOM को प्रतिस्थापित नहीं कर सकती है ताकि डाउनस्ट्रीम टीमों को संपूर्ण छवि डेटा के लिए थंबनेल को गलत समझने से रोका जा सके।
"रोगी पैकेज" एक संगठन विधि है जो वितरण और नमूनाकरण की सुविधा प्रदान करती है: संरचित तालिकाओं, पीडीएफ दस्तावेजों, इमेजिंग और पैथोलॉजी फ़ाइलों को एक ही अज्ञात रोगी निर्देशिका में समूहीकृत करना, और प्रत्येक फ़ाइल और उससे संबंधित घटनाओं को अनुक्रमित करने के लिए एक सूची का उपयोग करना। लेकिन कैटलॉग स्वयं एक डिलीवरी शेल मात्र है। वास्तविक डेटा मॉडल में अभी भी एक स्पष्ट तालिका संरचना, प्राथमिक कुंजी, विदेशी कुंजी, दिनांक फ़ील्ड और शब्दकोशों की आवश्यकता होती है। चेकलिस्ट को उत्तर देना चाहिए: प्रत्येक मरीज ने कौन से दौरे किए, प्रत्येक दौरे के लिए कौन से कागजी कार्य और परीक्षण थे, क्या कमी थी, और क्या कमी संरचनात्मक गैर-मौजूदगी या वितरण चूक थी।"यदि कोई निरीक्षण है" मोडल के लिए, एक निश्चित निरीक्षण की अनुपस्थिति को लापता भुगतान के रूप में मानने से बचने के लिए लागू शर्तें और गणना क्षमता एक ही समय में प्रदान की जानी चाहिए।
2026 में "नेचर मेडिसिन" में प्रकाशित रोगी यात्रा अध्ययन ने संरचित और असंरचित इलेक्ट्रॉनिक मेडिकल रिकॉर्ड से नैदानिक इकाइयों को निकालने, उन्हें कोडित डेटा के साथ एकीकृत करने और उन्हें क्वेरी करने योग्य रोगी यात्राओं में व्यवस्थित करने की एक विधि प्रस्तावित की। यह अनुसंधान दिशाओं को दर्शाता है जो मुठभेड़ों, दवाओं, परीक्षणों, महत्वपूर्ण संकेतों और लक्षणों को एक ही अस्थायी संदर्भ में रखता है।[2] डेटा आपूर्ति श्रृंखला के लिए, इसका मतलब यह नहीं है कि सभी परियोजनाओं को पहले एक ज्ञान मानचित्र बनाना चाहिए, बल्कि इसका मतलब है कि मूल दस्तावेजों और संरचित डेटा के बीच एक ट्रेस करने योग्य मैपिंग को बनाए रखना होगा, ताकि बाद में विशिष्ट कार्यों के आधार पर एक समयरेखा या ग्राफ़ संरचना का निर्माण किया जा सके।
क्लिनिकल चर अपने मूल संदर्भ और परिवर्तन प्रक्रिया को बरकरार रखते हैं
संरचित समय सारणी को "मान" को उसकी नैदानिक स्थिति से अलग नहीं करना चाहिए। परीक्षण परिणामों में कम से कम परियोजना का नाम, मूल परिणाम, इकाइयाँ, संदर्भ अंतराल, असामान्य पहचान, नमूने और संग्रह समय बरकरार रहना चाहिए; दवा डेटा में चिकित्सा आदेशों, प्रारंभ और समाप्ति समय, खुराक, मार्ग, आवृत्ति और निष्पादन स्थिति को अलग करना चाहिए। चिकित्सा आदेशों में संशोधन या विच्छेदन स्वयं रोग के पाठ्यक्रम में परिवर्तन को प्रतिबिंबित कर सकता है, और यदि केवल अंतिम नुस्खे को बरकरार रखा जाता है, तो उपचार प्रक्षेपवक्र खो जाएगा। पुनर्गणना और सत्यापन की सुविधा के लिए स्केल को स्केल का नाम, संस्करण, कुल स्कोर और आइटम स्कोर सहेजना चाहिए। यदि आयु को सामान्यीकृत या बाइनिंग किया गया है, तो सामान्यीकरण नियमों और उपयोग प्रतिबंधों को बरकरार रखा जाना चाहिए, और संसाधित मूल्यों को मूल माप के लिए गलत नहीं किया जाना चाहिए।
डायग्नोस्टिक्स में समय शब्दार्थ भी है। प्रारंभिक निदान, संशोधित निदान, डिस्चार्ज निदान और पैथोलॉजिकल निदान एक दूसरे के पूरक या बदल सकते हैं। डेटा संरचना को निदान का समय, रिकॉर्ड प्रकार, कोडिंग संस्करण और स्रोत उपकरण को बनाए रखना चाहिए, और केवल एक अंतिम कोड नहीं छोड़ना चाहिए। यदि किसी निश्चित मॉडल कार्य के लिए एकीकृत लेबल तैयार किया जाता है, तो एक अलग कार्य लेबल फ़ील्ड बनाना और उसके निर्णय के आधार को बनाए रखना आवश्यक है। यह नैदानिक विकास के अध्ययन की अनुमति देता है और बाद के शोधकर्ताओं को नैदानिक रिकॉर्ड और प्रसंस्करण लेबल को मिलाने से रोकता है।
मल्टीमॉडल कनेक्शन को "समान रोगी" से "समान नैदानिक घटना" में गिरना चाहिए। एक ही रोगी को एक ही दिन में विभिन्न भागों की कई परीक्षाओं से गुजरना पड़ सकता है, या थोड़े समय के भीतर स्कैन दोहराया जा सकता है; केवल रोगी की आईडी या तारीख के आधार पर संबद्धता असंबद्ध छवियों और रिपोर्टों को एक साथ जोड़ देगी। एसोसिएशन की स्थापना उपचार आईडी, परीक्षा आवेदन संख्या, रिपोर्ट आईडी, अध्ययन/श्रृंखला यूआईडी या आंतरिक ईवेंट कुंजी के माध्यम से की जा सकती है। संवेदनशील पहचानकर्ता के असंवेदनशील होने के बाद, इसे एक स्थिर अनाम कुंजी से बदल दिया जाएगा। डिलीवरी से पहले, रिपोर्ट में समय, स्थान और तुलनात्मक संदर्भ निकाले जा सकते हैं, और सूचकांक सूची को स्वचालित रूप से जांचा जा सकता है, और फिर चिकित्सा कर्मी बेमेल, लापता परतों या अनुचित समय अनुक्रमों की समीक्षा कर सकते हैं।
रोग समूह और परिणाम लेबल को संयुक्त रूप से चिकित्सकीय रूप से परिभाषित करने की आवश्यकता है
समूह का निर्माण करते समय, रोग समावेशन मानदंड को कोडिंग, नैदानिक पाठ और नैदानिक साक्ष्य में लागू किया जाना चाहिए। केवल एक ही निदान कोड पर भरोसा करने से ऐसे मामले शामिल हो सकते हैं जो लक्ष्य परिभाषा को पूरा नहीं करते हैं; केवल मुफ़्त पाठ को देखने से पर्यायवाची, नकारात्मक या ऐतिहासिक निदान के कारण गलत निर्णय भी हो सकते हैं। कोडिंग स्क्रीनिंग का उपयोग प्रारंभिक स्क्रीनिंग के रूप में किया जा सकता है, और फिर संबंधित इमेजिंग, पैथोलॉजी, प्रयोगशाला या विशेषज्ञ रिकॉर्ड जैसे महत्वपूर्ण आधारभूत साक्ष्य समर्थन की आवश्यकता होती है, और विरोधाभासी नमूनों को संभालने के लिए चिकित्सा समीक्षा की आवश्यकता होती है। एन्कोडिंग संस्करण, मैपिंग नियम और अपवादों को डेटा शब्दकोश और स्वीकृति रिकॉर्ड में दर्ज किया जाना चाहिए।
बहु-रोग और बहु-विभागीय समूहों को भी जनसंख्या संरचना की जांच करने की आवश्यकता है। उम्र, लिंग, रोग की अवस्था, रोग की गंभीरता, उपचार का प्रकार, संस्था और समय अवधि जैसे कारक मॉडल के प्रदर्शन को प्रभावित करेंगे। यदि एक निश्चित प्रकार के नमूने एक ही संस्थान, एक ही उपकरण, या एक निश्चित निदान और उपचार पथ में केंद्रित होते हैं, तो मॉडल रोग पैटर्न के बजाय संस्थागत आदतों को सीख सकता है। दुर्लभ बीमारियों या जटिल मामलों के लिए, कठिन मामलों को उचित रूप से जोड़ने से प्रशिक्षण और परीक्षण में मदद मिल सकती है, लेकिन यह लक्ष्य के उपयोग के अनुरूप होना चाहिए और स्पष्ट रूप से बताना चाहिए कि वास्तविक नैदानिक प्रसार वितरण के लिए कृत्रिम रूप से समृद्ध समूह को गलत समझने से बचने के लिए नमूनों की जांच कैसे की जाती है।
परिणाम क्षेत्र में निर्णय नियम, अवलोकन विंडो, साक्ष्य स्रोत और समीक्षा प्रक्रियाएं होनी चाहिए। मॉडल इनपुट और परिणाम लेबल के बीच एक समय सीमा निर्धारित की जानी चाहिए। उदाहरण के लिए, भविष्य की पुनरावृत्ति की भविष्यवाणी करने के लिए, आधारभूत समय बिंदु के बाद पुनरावृत्ति दस्तावेजों को इनपुट सुविधाओं में दर्ज नहीं किया जा सकता है; नैदानिक घटनाओं के बाद इमेजिंग या पैथोलॉजी रिपोर्ट तैयार की जा सकती है, और पूर्वानुमान समय बिंदु से पहले यात्रा करने से बचना भी आवश्यक है। प्रशिक्षण, सत्यापन और परीक्षण डेटा को रोगी समूह द्वारा विभाजित करना सबसे अच्छा है; जब लक्ष्य अंतर-संस्थागत प्रयोज्यता को सत्यापित करना है, तो संपूर्ण संस्थान को बाहरी परीक्षण के लिए रखा जाना चाहिए; जब लक्ष्य समय प्रवास है, तो परीक्षण के लिए बाद की समय अवधि का उपयोग किया जाना चाहिए। रिपोर्ट द्वारा यादृच्छिक विभाजन एक ही रोगी के लगभग डुप्लिकेट रिकॉर्ड को कई संग्रहों में लीक कर सकता है।
इमेजिंग एआई में प्रगति ने डेटा आवश्यकताओं को और बढ़ा दिया है
CTPA फुफ्फुसीय अन्त: शल्यता के मूल्यांकन के लिए एक महत्वपूर्ण इमेजिंग परीक्षण है। 2025 में "एनपीजे डिजिटल मेडिसिन" में प्रकाशित एक अध्ययन ने सीटीपीए इमेजिंग, रिपोर्ट निर्माण और परिणाम भविष्यवाणी के आसपास एक मल्टी-मोडल मॉडल स्थापित किया। उपयोग किए गए डेटा में कई चिकित्सा स्रोतों और रोगी समूहों को शामिल किया गया है, जो दर्शाता है कि अनुसंधान एकल सकारात्मक भेदभाव से छवियों, रिपोर्टों और नैदानिक परिणामों के संयुक्त विश्लेषण की ओर बढ़ रहा है।[3] इस प्रकार के कार्य के लिए आवश्यक डेटा केवल "सीटीपीए छवि होना" नहीं है: इसके लिए छवियों के पूरे सेट, रिपोर्ट विवरण, नैदानिक संदर्भ और अनुवर्ती परिणामों को संरेखित करने की क्षमता की भी आवश्यकता होती है, ताकि हम मूल्यांकन कर सकें कि क्या मॉडल घावों को सारांशित कर सकता है और बाद के विश्लेषण का समर्थन कर सकता है।
अक्टूबर 2026 तक, एक अन्य बहु-संस्थागत वास्तविक-विश्व अध्ययन ने विभिन्न परीक्षा प्रकारों और संस्थानों में वाणिज्यिक फुफ्फुसीय अन्त: शल्यता एआई के वास्तविक प्रदर्शन पर रिपोर्ट दी, जिसमें कहा गया कि वास्तविक-विश्व परिनियोजन और पंजीकरण अध्ययन बेंचमार्क के तहत संवेदनशीलता में अंतर हो सकता है।[4] इस प्रकार के साक्ष्य डेटा टीमों को याद दिलाते हैं कि एक बार लाइव होने पर मॉडल का प्रदर्शन रोगी संरचना, परीक्षा प्रोटोकॉल, रोग चरण और संस्थागत वर्कफ़्लो से प्रभावित होगा। प्रशिक्षण सेट केवल एक निश्चित स्कैनिंग प्रोटोकॉल या एक अस्पताल को कवर करता है और इसे स्वचालित रूप से अन्य अस्पतालों में विस्तारित नहीं किया जा सकता है; अनुसंधान रिपोर्ट में केस स्क्रीनिंग, उपकरण और प्रोटोकॉल, डेटा विभाजन और बाहरी सत्यापन विधियों का वर्णन होना चाहिए।
उसी वर्ष के इमेजिंग डेटा सेट संसाधनों ने भी स्लाइस-स्तरीय लेबल, एम्बोलिज़ेशन स्थान और प्रकार जैसी बारीक जानकारी प्रदान करना शुरू कर दिया।[5] बारीक-बारीक लेबल स्थानीयकरण और उपटाइपिंग कार्यों के लिए सहायक होते हैं, लेकिन लेबल जितने महीन होंगे, एनोटेशन नियमों, छवि रेंज और विशेषज्ञ समझौते की आवश्यकताएं उतनी ही अधिक होंगी। एल्गोरिथम मेट्रिक्स को नैदानिक उपयोग से जोड़ने की आवश्यकता है: केस-स्तरीय स्क्रीनिंग, घाव स्थानीयकरण, गंभीरता स्तरीकरण, और रिपोर्ट पीढ़ी को अंतिम उत्तर के रूप में एक भी सटीकता दर साझा नहीं करनी चाहिए। छोटे घावों या सीमा रेखा के मामलों के लिए, संवेदनशीलता, विशिष्टता, स्तरीकरण संकेतक, आत्मविश्वास अंतराल और त्रुटि प्रकार सभी का अलग से विश्लेषण करने की आवश्यकता है।
लैंगहुई डेटा इंजीनियरिंग और क्लिनिकल समीक्षा को एक बंद लूप में जोड़ सकता है
लंबी-अनुक्रम मल्टी-मोडल परियोजनाओं के लिए, लैंगहुई की पेशेवर प्रस्तुति "आवश्यकताओं की परिभाषा, रोगी-स्तरीय मॉडलिंग, क्रॉस-मोडल सहसंबंध, गुणवत्ता समीक्षा और समीक्षा योग्य वितरण" पर ध्यान केंद्रित कर सकती है। जब परियोजना शुरू की जाती है, तो लक्ष्य रोग प्रकार, समय प्रारंभिक बिंदु, परिणाम परिभाषा और डेटा सीमा की संयुक्त रूप से पुष्टि की जाती है; नमूना चरण में, रोगी संघों, समय क्षेत्रों, दस्तावेज़ अखंडता और छवि अनुक्रमों की जाँच की जाती है; औपचारिक बैच में, दस्तावेज़ सूचियों, स्वचालित नियमों और चिकित्सा नमूना निरीक्षणों के माध्यम से दोषों की पहचान की जाती है; पुन: कार्य के बाद संस्करण और पुन: निरीक्षण रिकॉर्ड बनाए रखे जाते हैं। प्रत्येक चरण में जांच योग्य फ़ील्ड, लॉग या स्वीकृति मानदंड आउटपुट होना चाहिए। प्रोजेक्ट फ़ाइल के अनुसार विशिष्ट डेटा स्रोत और प्राधिकरण स्थिति की पुष्टि की जानी चाहिए।
यह विधि "क्या डेटा सबमिट किया जा सकता है" से "क्या डेटा का यह बैच लक्ष्य प्रश्न का उत्तर दे सकता है" तक आगे बढ़ता है। ग्राहक पीओसी के समय एसोसिएशन नियमों और डेटा अंतराल को सत्यापित कर सकते हैं, एल्गोरिदम टीमें मूल्यांकन कर सकती हैं कि क्या मॉडल इनपुट समयरेखा का पुनर्निर्माण कर सकते हैं, चिकित्सा विशेषज्ञ दस्तावेजों और इमेजिंग सत्यापन साक्ष्य पर वापस जा सकते हैं, और डेटा प्रशासन कर्मी स्रोतों, संशोधन और परिवर्तन प्रक्रियाओं का ऑडिट कर सकते हैं। उन वस्तुओं के लिए जिन्हें पुनर्खरीद करने की आवश्यकता है, रोगी पैकेज संरचना, फ़ील्ड शब्दकोश और स्वीकृति संस्करण को सुसंगत रखने से हर बार कैटलॉग और फ़ील्ड की पुनर्व्याख्या करने की तुलना में लागत में अधिक बचत होगी।
अक्सर पूछे जाने वाले प्रश्न
लंबी-श्रृंखला चिकित्सा डेटा कम से कम कितने वर्षों का होना चाहिए? आप केवल वर्षों की एक संख्या के साथ उत्तर नहीं दे सकते। अवलोकन विंडो, आधार रेखा, अनुवर्ती यात्राओं की संख्या और परिणाम निर्धारण को अनुसंधान उद्देश्यों के अनुसार परिभाषित किया जाना चाहिए। अनुलग्नक में निर्माण विनिर्देश संग्रह सीमा के रूप में तीन वर्ष से अधिक निर्धारित करते हैं, लेकिन विशिष्ट मॉडल कार्यों के लिए अभी भी व्याख्या योग्य समय प्रारंभ और समाप्ति नियम निर्धारित करने की आवश्यकता होती है।
निरीक्षण और छवियों को सटीक समय बनाए रखने की आवश्यकता क्यों है? क्योंकि पाठ्यक्रम रिकॉर्ड में संदर्भ, परीक्षण परिणाम निर्माण और छवि अधिग्रहण अलग-अलग समय पर हो सकते हैं। यदि केवल दिनांक या निर्यात तिथि को बरकरार रखा जाता है, तो यह निर्धारित करना संभव नहीं होगा कि निर्णय लेने के समय कोई संकेतक उपलब्ध है या नहीं, न ही रिपोर्ट के बीच अनुक्रमिक संबंध की जांच करना संभव नहीं होगा।
प्रतिनिधि POC नमूने कैसे चुने जाने चाहिए? आम तौर पर एक ही मरीज के क्रॉस-कलेक्शन से बचना चाहिए। लक्ष्य कार्यों के अनुसार संगठन के समय विभाजन या बाहरी परीक्षण का उपयोग करके, और लगभग डुप्लिकेट फ़ाइलों और रिपोर्ट टेम्पलेट लीक की जांच करके, हम एक सामान्यीकृत मूल्यांकन प्राप्त कर सकते हैं जो वास्तविक तैनाती के करीब है।
संदर्भ
[1] कपलान ए, एट अल। जनरेटिव ट्रांसफार्मर के साथ मानव रोग के प्राकृतिक इतिहास को सीखना। प्रकृति, 2025. https://doi.org/10.1038/s41586-025-09529-3
[2] संरचित और असंरचित ईएचआर डेटा से गणना योग्य अनुदैर्ध्य रोगी यात्रा। प्राकृतिक चिकित्सा, 2026. https://www.nature.com/articles/s41591-026-04695-x
[3] सीटी पल्मोनरी एंजियोग्राम में रिपोर्ट निर्माण और परिणाम भविष्यवाणी के लिए विजन-भाषा मॉडल। एनपीजे डिजिटल मेडिसिन, 2025. https://www.nature.com/articles/s41746-025-01807-8
[4] फुफ्फुसीय और आकस्मिक फुफ्फुसीय अन्त: शल्यता का पता लगाने के लिए वाणिज्यिक एआई का बहु-साइट वास्तविक दुनिया प्रदर्शन। एनपीजे डिजिटल मेडिसिन, 2026. https://www.nature.com/articles/s41746-026-03418-3
[5] स्टैनफोर्ड एआईएमआई। सीटी पल्मोनरी एंजियोग्राफी डेटासेट। https://aimi.stanford.edu/datasets/CT-Pulmonary-Angiography