A questão de pesquisa determina a estrutura do conjunto de dados
O desenho de um conjunto de dados longitudinais não pode começar com a estrutura de pastas, mas deve primeiro esclarecer quais questões o modelo ou estudo deseja responder. A identificação precoce da doença requer pontos de referência claros e janelas de observação de acompanhamento; a análise da resposta ao tratamento requer a sequência entre exposição medicamentosa ou cirúrgica, resultados de testes e desfechos; a previsão de recorrência ou readmissão requer a definição da data do índice, duração do acompanhamento, eventos de resultado e regras de perda de acompanhamento. Sem estas definições, o “período de três anos” é apenas um requisito amplo de recolha e não garante que a amostra seja suficiente para apoiar análises específicas.
Recomenda-se esclarecer quatro coisas para cada caso: qual é o ponto de partida, como calcular o período de observação, como determinar o ponto final e quais registros pertencem a esta trajetória. O ponto de partida pode ser a data do primeiro diagnóstico, avaliação pré-tratamento, admissão ou teste; o ponto final pode ser recorrência, progressão, morte, readmissão, remissão ou atingir um prazo de acompanhamento especificado. Para pacientes com “eventos não observados”, é necessário distinguir entre “acompanhamento completo, mas não ocorreu”, “perda de acompanhamento precoce” e “ausência de dados de acompanhamento no sistema de registro”. Escrever esses status como “sem resultado” causará erros de rotulagem e vieses de acompanhamento.
O estudo Delphi-2M publicado na "Nature" em 2025 usou cronogramas de doenças para modelar o risco futuro de múltiplas doenças e foi validado externamente com dados de registros dinamarqueses após treinamento na coorte britânica, demonstrando o potencial dos dados de séries temporais para modelagem de processos de doenças. O estudo também apontou que o modelo pode aprender vieses de seleção e padrões ausentes no conjunto de dados, de modo que o desempenho da previsão não pode ser explicado isoladamente da composição da coorte e do mecanismo de geração de dados.[1] Isso tem implicações diretas para a construção de dados: carimbos de data/hora, motivos para o encerramento do acompanhamento, instituições de origem e mecanismos ausentes são todos contextos que o modelo precisa conhecer.
Pacientes, visitas, eventos e arquivos precisam estar relacionados hierarquicamente
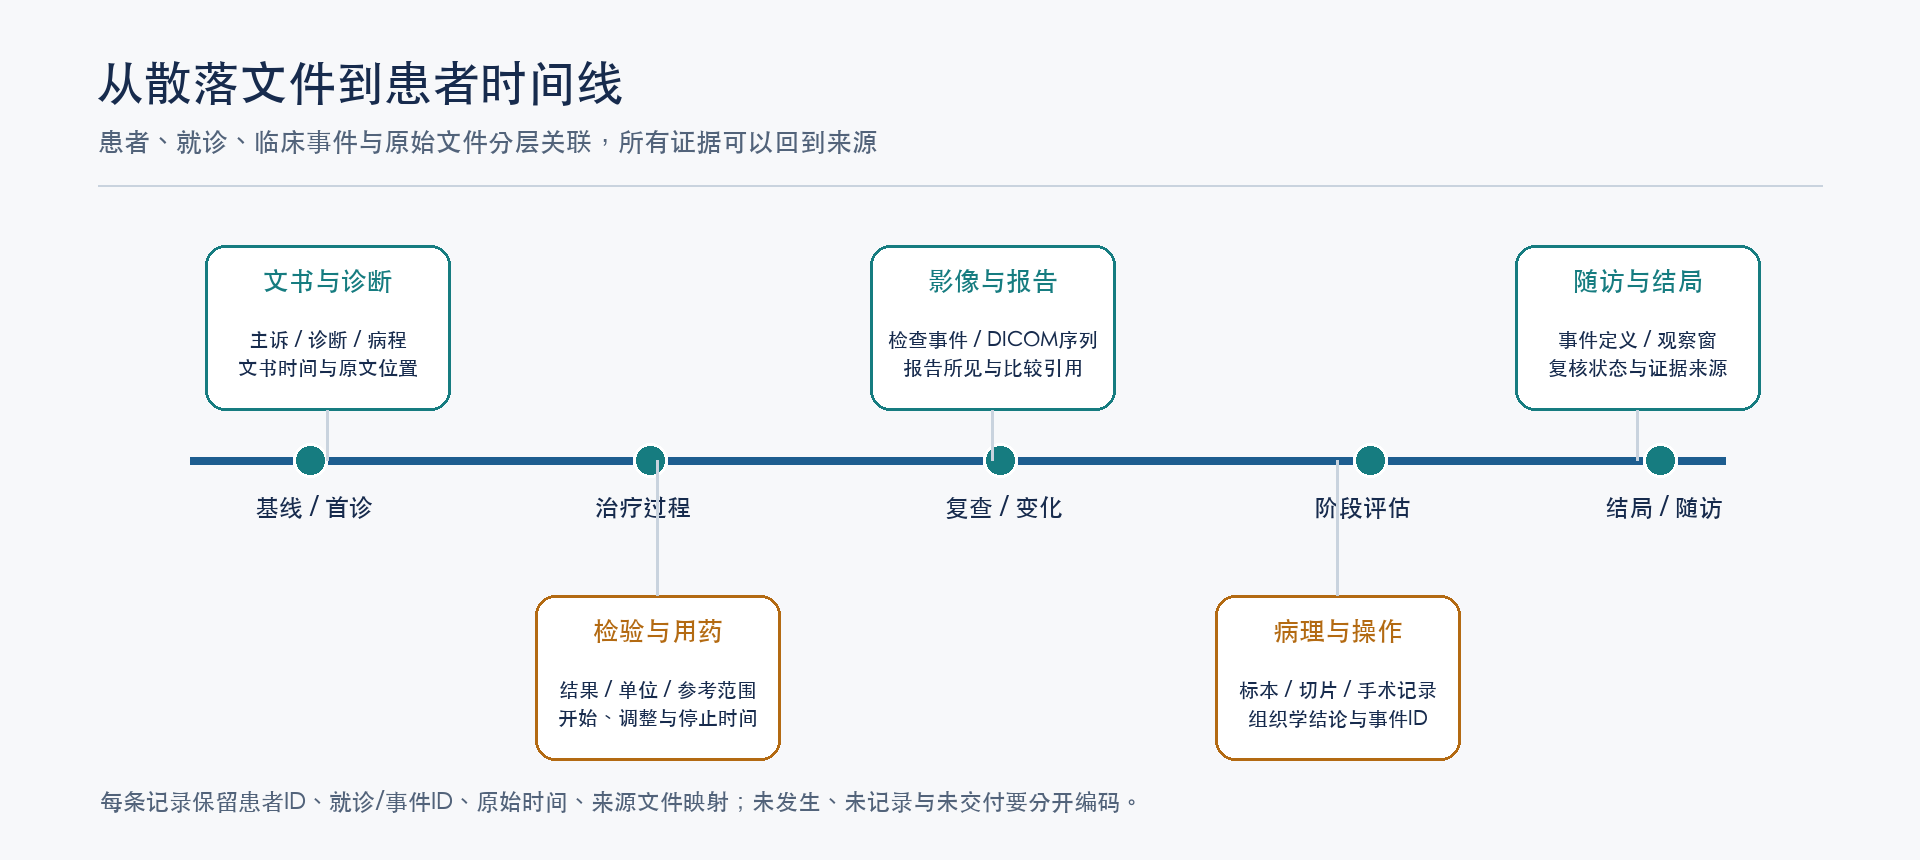
recomenda dividir os dados longitudinais em quatro níveis inter-relacionados. A camada do paciente utiliza identificadores de pacientes anônimos e estáveis e é responsável por encadear múltiplas visitas da mesma pessoa; a camada de visita registra eventos ambulatoriais, de internação, de emergência, de transferência ou de acompanhamento; a camada de eventos clínicos registra diagnósticos, sintomas, exames, testes, medicamentos, operações e resultados; a camada de arquivo armazena portadores originais, como documentos do curso da doença, relatórios de exames, DICOM, lâminas patológicas e assim por diante. Cada camada deve ter chaves exclusivas e estar relacionada por chaves estrangeiras explícitas, em vez de depender de adivinhações de relacionamentos por nomes de arquivos ou localizações de diretórios.
A identificação estável no nível do paciente não se destina a preservar informações de identidade reversíveis. Deve ser uma chave pseudonimizada dentro do escopo do projeto, a tabela de mapeamento de identidade real é mantida separadamente de acordo com os requisitos de autorização e os dados de entrega não carregam o mapeamento. O escopo do ID do tratamento, ID do relatório, ID do estudo/série de imagem e ID do documento também precisam ser claramente definidos para evitar que dois hospitais diferentes ou lotes diferentes sejam mesclados por engano após gerar o mesmo número. A fusão entre sistemas deve registrar regras de correspondência, confiança e status de revisão manual; quando a correspondência confiável não pode ser alcançada, manter o status não associado é melhor do que a emenda forçada.
O campo horário deve distinguir, no mínimo, horário de ocorrência do evento, horário de coleta, horário de geração do relatório, horário de entrada, horário de modificação e horário de exportação. Eles costumam ser diferentes nos registros médicos. Os corpos de prova poderão ser coletados primeiro e os resultados serão divulgados posteriormente; os registros do curso da doença podem revisar e descrever eventos anteriores; o horário de exportação do sistema não pode substituir o horário dos eventos clínicos. Preservar o fuso horário, a precisão, os campos de origem e os motivos ausentes permite que a equipe do algoritmo determine qual ponto no tempo deve ser usado como informação visível para evitar vazamento de dados após o resultado ser gerado na entrada do modelo. O sistema de origem, fuso horário, precisão e regras de conversão também devem ser descritos para cada tipo de campo de hora. Quando há apenas uma data sem hora, a precisão do nível da data deve ser mantida e a hora específica não deve ser inventada; quando houver transferência inter-hospitalar, registro suplementar subsequente ou triagem retrospectiva, a incerteza do horário do evento deve ser marcada. A falta também deve ser diferenciada entre não ocorrido, não adquirido, não registrado, incapaz de ser associado e parto perdido, uma vez que esses estados não são idênticos para interpretação clínica e análise de viés de modelo. Para a tarefa de previsão, o dicionário de dados deve definir claramente o ponto de tempo da linha de base, o tempo limite de visibilidade do recurso, a janela de observação do resultado e o motivo do encerramento do acompanhamento e, por meio da verificação de amostragem da linha do tempo no nível do paciente, confirmar se o modelo não leu as informações após a ocorrência do evento alvo.
Deve ser salvo o texto completo do documento, tipo de documento, horário de registro, status de assinatura ou revisão e tratamento médico correspondente. Caso o negócio exija eventos estruturados, os resultados da extração também deverão estabelecer mapeamento de posição com os parágrafos do texto original ou números de páginas. Dessa forma, os especialistas clínicos podem voltar às evidências originais para verificação, os engenheiros de algoritmos podem filtrar amostras por tipo de documento e os engenheiros de dados podem verificar o truncamento e a duplicação de texto. Para registros-chave, o foco da aceitação deve estar na integridade do texto, na precisão da classificação, na lógica temporal e na associação de pacientes; o processamento excessivo de campos não-chave pode aumentar os erros e obscurecer o conteúdo original.
Multimodalidade não significa colocar arquivos no mesmo diretório
Os dados de um paciente podem incluir texto do curso da doença, valores de testes, pedidos de medicamentos, relatórios de radiologia, imagens DICOM, relatórios de patologia e slides de campo completo. Somente quando as relações temporais e semânticas entre eles são claras é que um caso multimodal pode ser constituído. Cada imagem deve pelo menos ser capaz de encontrar o paciente correspondente, evento de exame, modalidade, parte do corpo, data de aquisição e laudo; quando o relatório menciona “comparação com o filme anterior”, a imagem anterior e seu relatório também deverão ser incluídos na cadeia de rastreabilidade. As seções patológicas precisam estar relacionadas ao local de amostragem, amostra, evento cirúrgico ou de biópsia e conclusão patológica. A ontologia de sequência DICOM
e os principais campos de cabeçalho carregam não apenas pixels de imagem, mas também informações técnicas, como modalidade, data, espaçamento de voxel, espessura da camada, sequência, etc. A dessensibilização deve cobrir tags padrão, tags privadas, nomes de arquivos e informações incorporadas em pixels, enquanto tenta preservar o contexto técnico necessário para concluir a tarefa de pesquisa. Deve ficar claro se a sequência está completa, se foi reamostrada ou compactada, a ferramenta de exportação e a versão processada. Se uma captura de tela for fornecida, deverá ser marcada quais informações não podem substituir o DICOM original para evitar que as equipes posteriores confundam a miniatura com dados completos da imagem.
"Pacotes de pacientes" são um método de organização que facilita a entrega e a amostragem: agrupando tabelas estruturadas, documentos PDF, arquivos de imagem e patologia no mesmo diretório anônimo de pacientes e usando uma lista para indexar cada arquivo e seus eventos associados. Mas o catálogo em si é apenas uma caixa de entrega. O modelo de dados real ainda precisa ter uma estrutura de tabela clara, chaves primárias, chaves estrangeiras, campos de data e dicionários. O checklist deveria responder: Quais consultas cada paciente fez, quais documentos e exames estavam disponíveis para cada consulta, o que faltou e se a falta foi uma inexistência estrutural ou uma omissão no parto. Para o modal “se houver fiscalização”, as condições aplicáveis e o calibre de contagem deverão ser fornecidos concomitantemente para evitar tratar a ausência de determinada fiscalização como falta de pagamento.
O estudo da jornada do paciente publicado na "Nature Medicine" em 2026 propôs um método para extrair entidades clínicas de registros médicos eletrônicos estruturados e não estruturados, integrá-los com dados codificados e organizá-los em jornadas de pacientes consultáveis. Ilustra direções de pesquisa que colocam encontros, medicamentos, testes, sinais vitais e sintomas no mesmo contexto temporal.[2] Para a cadeia de fornecimento de dados, isso não significa que todos os projetos devam primeiro construir um mapa de conhecimento, mas significa que um mapeamento rastreável precisa ser retido entre documentos originais e dados estruturados, para que uma linha do tempo ou estrutura gráfica possa ser construída posteriormente com base em tarefas específicas.
Variáveis clínicas mantêm seu contexto original e mudam o processo
Tabelas de cronometragem estruturadas não devem separar o “valor” de sua condição clínica. Os resultados dos testes devem conter pelo menos o nome do projeto, resultados originais, unidades, intervalos de referência, identificação de anormais, espécimes e horário de coleta; os dados dos medicamentos devem distinguir as prescrições médicas, horário de início e término, posologia, via, frequência e situação de execução. A modificação ou suspensão de prescrições médicas pode, por si só, refletir alterações no curso da doença e, se apenas a prescrição final for mantida, a trajetória do tratamento será perdida. A escala deve salvar o nome da escala, versão, pontuação total e pontuação do item para facilitar o recálculo e a verificação. Se a idade for generalizada ou categorizada, as regras de generalização e restrições de uso devem ser mantidas e os valores processados não devem ser confundidos com a medição original. Os diagnósticos
também possuem semântica de tempo. O diagnóstico preliminar, o diagnóstico revisado, o diagnóstico de alta e o diagnóstico patológico podem complementar-se ou alterar-se. A estrutura de dados deve reter o horário do diagnóstico, tipo de registro, versão da codificação e instrumento fonte, não podendo deixar apenas um código final. Se um rótulo unificado for gerado para uma determinada tarefa modelo, será necessário criar um campo de rótulo de tarefa separado e manter sua base de julgamento. Isso permite o estudo da evolução diagnóstica e evita que pesquisadores subsequentes confundam registros clínicos e processem rótulos.
As conexões multimodais devem cair ainda mais de “mesmo paciente” para “mesmo evento clínico”. O mesmo paciente pode ser submetido a vários exames de diferentes partes no mesmo dia, ou os exames podem ser repetidos em um curto período de tempo; a associação apenas por ID do paciente ou data unirá imagens e relatórios não relacionados. A associação pode ser estabelecida através do ID do tratamento, número do pedido de exame, ID do relatório, UID do estudo/série ou chave interna do evento. Depois que o identificador sensível for dessensibilizado, ele será substituído por uma chave anônima estável. Antes da entrega, a hora, o local e as referências comparativas no relatório podem ser extraídos, e a lista de índices pode ser verificada automaticamente, e então a equipe médica pode revisar incompatibilidades, camadas ausentes ou sequências de tempo não razoáveis.
As coortes de doenças e os rótulos de resultados precisam ser definidos clinicamente em conjunto Ao construir a coorte
, os critérios de inclusão de doenças devem ser implementados na codificação, no texto de diagnóstico e nas evidências clínicas. Depender apenas de um único código de diagnóstico pode incluir casos que não atendem à definição alvo; olhar apenas para texto livre também pode levar a erros de julgamento devido a sinônimos, negativas ou diagnósticos históricos. A triagem de codificação pode ser usada como uma triagem preliminar e, em seguida, exigir suporte de evidências básicas críticas, como registros de imagem, patologia, laboratório ou especialista correspondentes, e ter revisão médica para lidar com amostras conflitantes. Versões de codificação, regras de mapeamento e exceções devem ser inseridas no dicionário de dados e nos registros de aceitação.
Coortes com múltiplas doenças e vários departamentos também precisam examinar a estrutura populacional. Fatores como idade, sexo, estágio da doença, gravidade da doença, tipo de tratamento, instituição e período afetarão o desempenho do modelo. Se um determinado tipo de amostra estiver concentrado em uma única instituição, em um único dispositivo ou em um determinado diagnóstico e tratamento, o modelo poderá aprender hábitos institucionais em vez de padrões de doenças. Para doenças raras ou casos complexos, a adição adequada de casos difíceis pode ajudar na formação e nos testes, mas deve ser consistente com a utilização alvo e explicar claramente como as amostras são rastreadas para evitar confundir a coorte enriquecida artificialmente com a verdadeira distribuição da prevalência clínica.
O campo resultado deve possuir regras de julgamento, janelas de observação, fontes de evidências e processos de revisão. Um limite de tempo deve ser definido entre os rótulos de entrada e de resultado do modelo. Por exemplo, para prever a recorrência futura, os documentos de recorrência após o ponto de tempo da linha de base não podem ser inseridos nos recursos de entrada; relatórios de imagem ou patologia podem ser gerados após eventos clínicos, e também é necessário evitar viagens antes do momento de previsão. É melhor dividir os dados de treinamento, validação e teste por grupo de pacientes; quando o objectivo é verificar a aplicabilidade interinstitucional, toda a instituição deve ser retida para testes externos; quando o objetivo é a migração temporal, um período posterior deve ser usado para teste. A divisão aleatória por relatório pode vazar registros quase duplicados do mesmo paciente em diversas coleções.
Os avanços na IA de imagem aumentaram ainda mais os requisitos de dados
CTPA é um importante exame de imagem para avaliação de embolia pulmonar. Um estudo publicado na "npj Digital Medicine" em 2025 estabeleceu um modelo multimodal em torno de imagens de CTPA, geração de relatórios e previsão de resultados. Os dados utilizados abrangeram múltiplas fontes médicas e coortes de pacientes, refletindo que a investigação está a passar de uma discriminação positiva única para uma análise conjunta de imagens, relatórios e resultados clínicos.[3] Os dados necessários para este tipo de tarefa não são apenas “ter uma imagem CTPA”: também requerem a capacidade de alinhar todo o conjunto de imagens, relatar detalhes, contexto clínico e resultados de acompanhamento, para que possamos avaliar se o modelo pode resumir as lesões e apoiar análises subsequentes.
Em outubro de 2026, outro estudo multiinstitucional do mundo real relatou o desempenho real de uma IA comercial para embolia pulmonar em diferentes tipos de exames e instituições, observando que pode haver uma lacuna na sensibilidade nos parâmetros de referência do estudo de implantação e registro no mundo real.[4] Esse tipo de evidência lembra às equipes de dados que o desempenho de um modelo, quando ele entrar em operação, será afetado pela composição do paciente, pelo protocolo do exame, pelo estágio da doença e pelo fluxo de trabalho institucional. O conjunto de treinamento cobre apenas um determinado protocolo de varredura ou um único hospital e não pode ser extrapolado automaticamente para outros hospitais; o relatório da pesquisa deve descrever a triagem dos casos, equipamentos e protocolos, segmentação dos dados e métodos de validação externa.
Os recursos do conjunto de dados de imagem do mesmo ano também começaram a fornecer informações mais refinadas, como rótulos em nível de corte, locais e tipos de embolização.[5] Rótulos refinados são úteis para tarefas de localização e subtipagem, mas quanto mais finos os rótulos, maiores serão os requisitos para regras de anotação, intervalo de imagens e concordância de especialistas. As métricas algorítmicas precisam estar vinculadas ao uso clínico: a triagem em nível de caso, a localização da lesão, a estratificação da gravidade e a geração de relatórios não devem compartilhar uma única taxa de precisão como resposta final. Para lesões pequenas ou casos limítrofes, a sensibilidade, a especificidade, os indicadores de estratificação, os intervalos de confiança e os tipos de erro precisam ser analisados separadamente.
Langhui pode conectar engenharia de dados e revisão clínica em um circuito fechado
Para projetos multimodais de longa sequência, a apresentação profissional de Langhui pode se concentrar na “definição de requisitos, modelagem no nível do paciente, correlação intermodal, revisão de qualidade e entrega revisável”. Quando o projeto é iniciado, o tipo de doença alvo, o ponto de início, a definição do resultado e o intervalo de dados são confirmados conjuntamente; na etapa de amostragem são verificadas associações de pacientes, campos de tempo, integridade de documentos e sequências de imagens; no lote formal, os defeitos são identificados por meio de listas de documentos, regras automáticas e inspeções de amostras médicas; versões e registros de reinspeção são retidos após o retrabalho. Cada etapa deve gerar campos verificáveis, registros ou critérios de aceitação. A fonte de dados específica e o status de autorização devem ser confirmados de acordo com o arquivo do projeto.
Este método avança "se os dados podem ser enviados" para "se este lote de dados pode responder à pergunta alvo". Os clientes podem verificar regras de associação e lacunas de dados no momento do POC, as equipes de algoritmos podem avaliar se as entradas do modelo podem reconstruir a linha do tempo, os especialistas médicos podem voltar aos documentos e evidências de verificação de imagens, e o pessoal de governança de dados pode auditar fontes, redigir e alterar processos. Para itens que precisam ser recomprados, manter a estrutura do pacote do paciente, o dicionário de campos e a versão de aceitação consistentes economizará mais custos do que reinterpretar o catálogo e os campos a cada vez.
Perguntas frequentes
Quantos anos os dados médicos de série longa precisam ter pelo menos? Você não pode responder com apenas um número de anos. A janela de observação, a linha de base, o número de visitas de acompanhamento e a determinação dos resultados devem ser definidos de acordo com os objetivos da pesquisa. As especificações de construção no anexo estabelecem mais de três anos como limite de coleta, mas as tarefas específicas do modelo ainda precisam definir regras de início e término de tempo interpretáveis.
Por que as inspeções e imagens precisam reter o tempo preciso? Porque a referência no registro do curso, a geração do resultado do teste e a aquisição da imagem podem ocorrer em momentos diferentes. Se apenas a data ou data de exportação for mantida, poderá não ser possível determinar se um indicador está disponível no momento da tomada de decisão, nem verificar a relação sequencial entre os relatórios.
Como selecionar amostras de POC representativas? A coleta cruzada do mesmo paciente geralmente deve ser evitada. Ao usar ainda mais a segmentação de tempo ou testes externos da organização de acordo com as tarefas-alvo, e verificar se há arquivos quase duplicados e vazamentos de modelos de relatório, podemos obter uma avaliação generalizada mais próxima da implantação real.
Referências
[1] Kaplan A, et al. Aprendendo a história natural das doenças humanas com transformadores generativos. Natureza, 2025. https://doi.org/10.1038/s41586-025-09529-3
[2] Jornadas longitudinais computáveis do paciente a partir de dados EHR estruturados e não estruturados. Medicina Natural, 2026. https://www.nature.com/articles/s41591-026-04695-x
[3] Modelo de linguagem visual para geração de relatórios e previsão de resultados em angiografia pulmonar por TC. npj Medicina Digital, 2025. https://www.nature.com/articles/s41746-025-01807-8
[4] Desempenho em vários locais do mundo real de IA comercial para detecção de embolia pulmonar pulmonar e incidental. npj Medicina Digital, 2026. https://www.nature.com/articles/s41746-026-03418-3
[5] Stanford AIMI. Conjunto de dados de angiografia pulmonar por TC. https://aimi.stanford.edu/datasets/CT-Pulmonary-Angiography