Statut de recherche Cet article rend compte d'un audit local des fichiers fournis et propose un protocole d'évaluation. Aucune expérience de modèle comparatif, score de modèle, classement ou affirmation d'efficacité clinique n'est rapportée. La littérature a été examinée jusqu’au 26 octobre 2026.
Résumé : une question de recherche vérifiable à partir de bilans de santé
L’évaluation de l’IA médicale devient plus informative lorsqu’elle pose une question concrète : étant donné trois bilans de santé pour la même personne, un système peut-il localiser les mesures correctes, établir leur chronologie, expliquer les changements, préserver l’incertitude et communiquer proportionnellement aux preuves ? Cela nécessite la lecture de documents, l’extraction d’informations, le raisonnement temporel, l’interprétation médicale et une communication sécurisée. Un modèle qui répond couramment aux questions de l'examen médical peut encore confondre une unité, une date, une négation ou un résumé de rapport. De telles erreurs peuvent se propager jusqu’à son avis final.
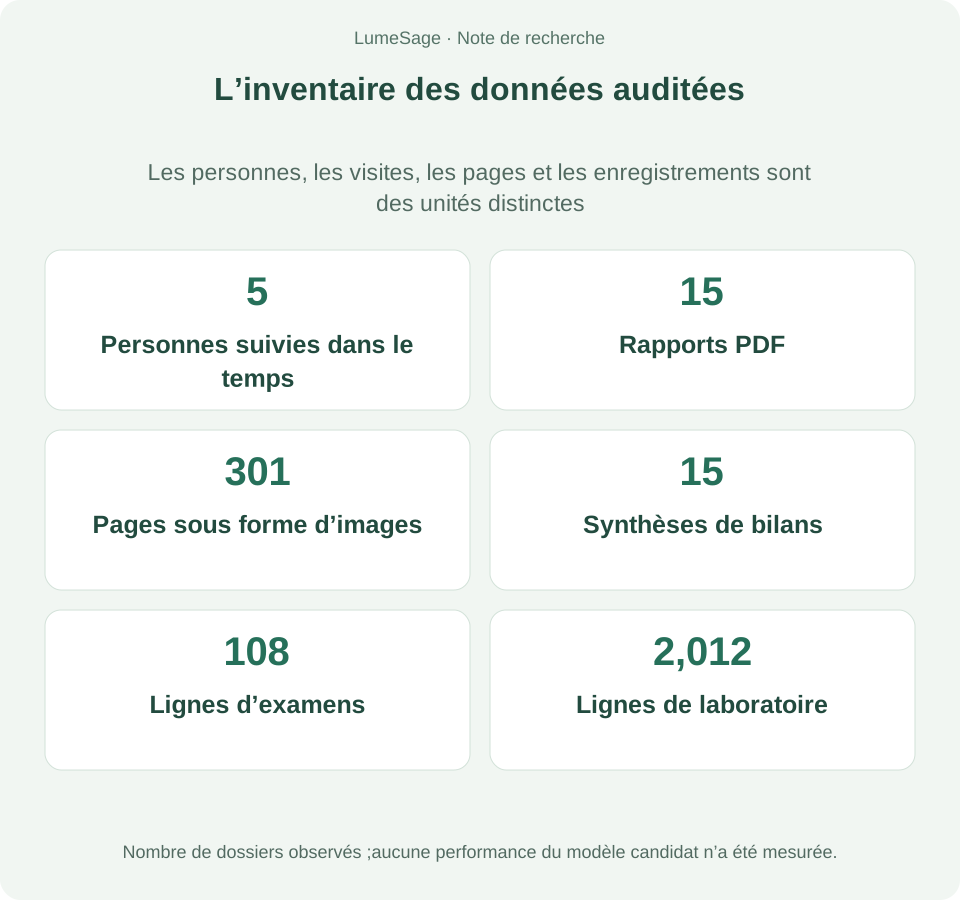
Notre audit local a identifié cinq groupes de sujets longitudinaux, 15 rapports PDF contenant uniquement des images contenant 301 pages et trois feuilles de travail structurées. Les identifiants associent à chaque groupe trois contrôles. Les feuilles de travail contiennent 15 résumés de visites, 108 dossiers d'examen et 2 012 dossiers de laboratoire. Ces documents soutiennent un prototype pour la compréhension des rapports, la synthèse longitudinale et la communication fondée sur des preuves. Ils ne fournissent pas suffisamment de participants indépendants, d’étiquettes de résultats ou de couverture institutionnelle externe pour établir une validité prédictive ou un classement public stable.
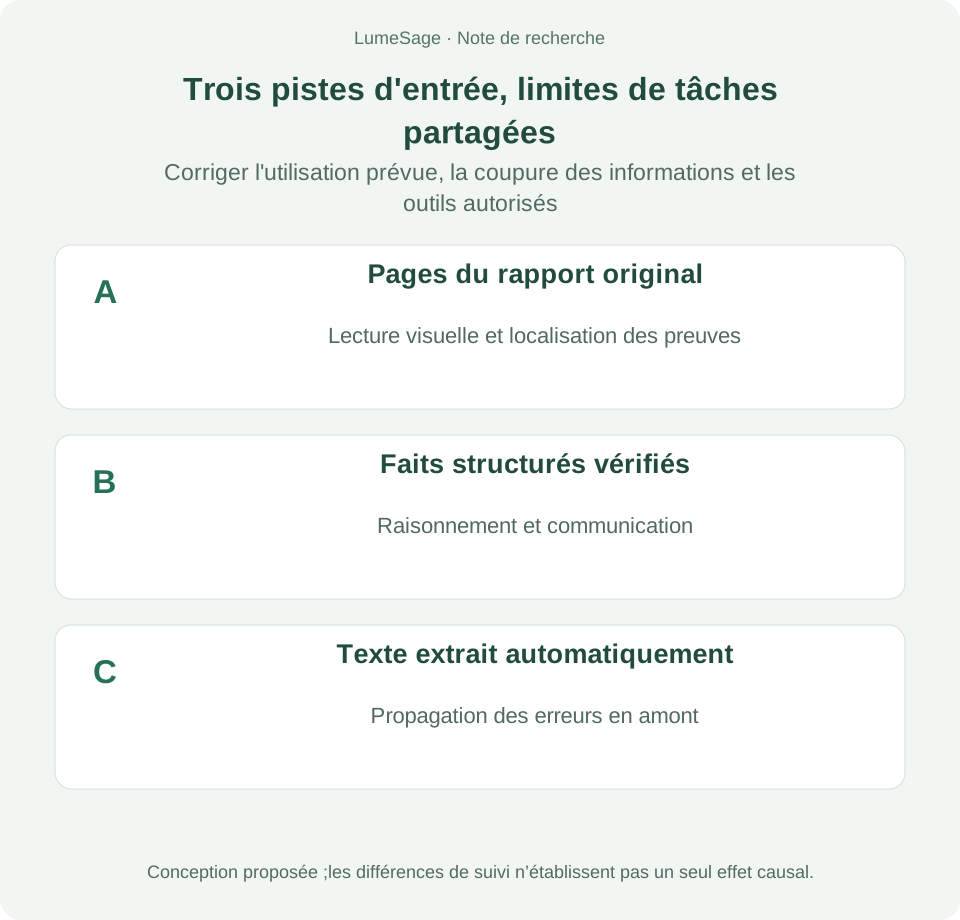
Le cadre d'évaluation du contrôle longitudinal LumeSage proposé combine une notation contextuelle inspirée de HealthBench avec une recherche sur de longs documents cliniques, un raisonnement temporel, une consultation à plusieurs tours et une évaluation dynamique de la sécurité. Il définit trois pistes de saisie, huit familles de tâches, une notation en couches et une évaluation par des experts. Sa contribution est un protocole testable dérivé des caractéristiques des données observées. L'audit des données terminé se distingue explicitement des expériences de modèles proposées et de la validation future.
1. Les recherches permises par les données disponibles
1.1 Personnes, bilans et mesures : trois unités statistiques distinctes
La structure du fichier et les identifiants structurés correspondent à cinq groupes de sujets comportant trois visites chacun. Les années de contrôle enregistrées comprennent cinq visites en 2023, cinq en 2024, quatre en 2025 et une en 2026. Le fournisseur de données doit confirmer le lien entre les sujets avant une étude formelle. Les 15 PDF contiennent entre 13 et 26 pages chacun. Toutes les pages stockent le contenu sous forme d'images ; l'extraction de texte ordinaire n'a renvoyé aucun texte consultable. Cela rend le matériel utile pour étudier les différences entre la lecture de rapports visuels et la saisie de données structurées.
Les 2 012 lignes de laboratoire sont des observations au niveau des mesures, et non 2 012 participants. La génération de nombreuses questions à partir d'un rapport crée des tâches corrélées plutôt que des échantillons cliniques indépendants. Les visites répétées pour une personne, les mesures dans un rapport et les paraphrases d'une question restent dépendantes. L'analyse doit préserver la hiérarchie personne, visite, document, terrain et tâche. Ignorer cette structure peut produire des intervalles de confiance artificiellement étroits et une signification statistique exagérée.
| Composant | Constats dans les fichiers | Conséquences pour l’évaluation |
|---|---|---|
| Rapports originaux | 15 PDF ;301pages; pas de calque de texte extractible | Test de lecture d'images, de localisation de tableaux et d'association entre pages |
| Synthèses des bilans | 15 enregistrements et 15 identifiants de visite distincts | Créer des résumés de visite et une synthèse des examens |
| Comptes rendus d’examens | 108 lignes, dont un double exact | Ne pas assimiler le nombre de lignes à des examens uniques |
| Résultats de laboratoire | 2 012 lignes ;368 chaînes de noms d'analytes bruts | Standardiser la terminologie, les spécimens, les unités et la signification |
| Relations entre les tables | Chaque identifiant d'examen et de visite de laboratoire est lié à un enregistrement de résumé de visite | La réussite des jointures ne démontre pas la concordance de chaque champ avec les images sources |
1.2 Des rapports multimodaux ne constituent pas un jeu d’images médicales brutes
La feuille de travail d'examen contient 70 lignes échographiques, 13 lignes CT, 15 lignes ECG, sept lignes IRM, une ligne DR et deux lignes d'examen général. Il s'agit du nombre brut de lignes avant la déduplication. Ils démontrent la couverture de plusieurs types de rapports. L'archive ne contient pas de séries DICOM distinctes ni de signaux ECG bruts. Il peut prendre en charge la recherche sur la lecture des rapports d'imagerie parallèlement aux résultats de laboratoire, mais ne peut pas établir l'interprétation des images CT d'un modèle, la compréhension des séquences IRM ou les performances d'analyse des formes d'onde. Une image imprimée intégrée dans un PDF n'équivaut pas à une acquisition complète avec ses paramètres d'origine.
Le tableau récapitulatif de la visite comprend le sexe, la taille, le poids, la tension artérielle, la date d'enregistrement et les recommandations globales. Le tableau d'examen comprend la procédure, les résultats, la conclusion et la date. Le tableau de laboratoire comprend l'analyte, le résultat, l'unité, l'intervalle de référence et l'indicateur d'anomalie. Il n’existe pas de champs distincts et complets pour les antécédents médicamenteux, les trajectoires des symptômes, l’observance, la confirmation du diagnostic ou les résultats à long terme. Certaines de ces informations peuvent figurer dans les fichiers PDF, mais on ne peut pas garantir qu'elles soient complètes. Le cas d’utilisation actuel le plus important est la compréhension et la communication des preuves de contrôle. L’analyse causale du traitement, la prévision des maladies futures et l’évaluation des bénéfices cliniques nécessitent des données supplémentaires.
2. Six constats d’audit pour guider l’évaluation
2.1 Séparer explicitement les résultats et les unités
Sur les 2 012 résultats de laboratoire, 268 sont stockés sous forme de valeurs numériques natives du tableur et 1 744 sous forme de texte. Sur 1 278 lignes, le texte résultat contient la chaîne apparaissant dans le champ unité correspondant. Les résultats textuels ne sont pas intrinsèquement erronés : les résultats négatifs ou positifs, les couleurs, la morphologie et les intervalles peuvent légitimement être exprimés sous forme de texte. La tâche de traitement consiste à préserver le résultat original tout en séparant la valeur numérique, le comparateur, l'unité, l'interprétation qualitative et l'indicateur d'anomalie. Forcer chaque résultat dans un nombre à virgule flottante peut éliminer « en dessous de la limite de détection », « non détecté » ou « négatif » et peut remplacer silencieusement les valeurs manquantes par zéro.
Une représentation normalisée doit conserver raw_value, numeric_value, comparator, unit_raw, unit_normalized et result_type, ainsi que les coordonnées de la ligne source et de la page. Les chaînes d'unités contiennent des variations de casse, d'espacement et de symboles de micro-unités. Le remplacement des chaînes à lui seul ne suffit pas à la conversion d’une unité médicale. Les comparaisons nécessitent des analytes, des échantillons, des méthodes de mesure et des règles de conversion compatibles. Chaque transformation doit rester traçable jusqu'à la preuve originale.
2.2 Déterminer si les unités et intervalles manquants sont applicables
Le champ unité est vide sur 548 lignes et le champ intervalle de référence sur 228 lignes : environ 27,2 % et 11,3 % des enregistrements de laboratoire, respectivement. Il s’agit de proportions de champs manquants et non de taux d’erreurs cliniques. Les descriptions de couleurs, certaines découvertes microscopiques et quantités sans dimension peuvent ne pas nécessiter une unité conventionnelle. Un intervalle de référence manquant peut refléter le test ou le processus d'exportation. L'annotation doit distinguer les non applicables, les absents du rapport source, les omis lors de la structuration et les échecs de reconnaissance. L'image source et la définition du test doivent résoudre cette distinction ; le modèle ne doit pas inventer une « plage normale ».
Les 228 lignes sans intervalle de référence portent un indicateur d'anomalie négative dans la table d'origine. Cette combinaison ne prouve ni une erreur de données ni n’établit la normalité. L'indicateur est un champ enregistré à vérifier, et non une étiquette de diagnostic qui remplace le contexte. Les contrôles déterministes peuvent évaluer les résultats avec des valeurs numériques, des unités et des limites explicites compatibles. Les résultats qualitatifs, les descriptions d'intervalles complexes et les seuils de décision clinique nécessitent des règles distinctes et un examen par des experts.
2.3 Les doublons et variantes de noms peuvent créer une fausse concordance
La table d'examen contient un double exact impliquant un élément d'examen général. Deux autres lignes contiennent une conclusion mais aucun texte de résultats. La taille, le poids, la pression artérielle systolique et la pression artérielle diastolique ont chacun une valeur manquante dans le tableau récapitulatif des visites. Une copie exacte doit être vérifiée pour une exportation répétée avant la création d'un enregistrement canonique. Les noms de procédures répétées peuvent représenter des examens légitimes à différents moments ou sites anatomiques. Les décomptes publiés doivent indiquer s’ils font référence à des lignes brutes ou à des événements dédupliqués.
Les 368 chaînes brutes de noms de laboratoire ne correspondent pas nécessairement à 368 concepts cliniques distincts. Des tests similaires peuvent avoir des noms différents, tandis qu'un terme tel que « globules blancs » peut faire référence à différents types d'échantillons ou groupes de tests. La cartographie conceptuelle nécessite le groupe de test, l’échantillon, l’unité et la méthode. Une fusion incorrecte de tests distincts et une séparation incorrecte de tests équivalents ont toutes deux des conséquences dans l'analyse longitudinale. Ils ont besoin de catégories d’erreur et de critères d’évaluation distincts.
2.4 Une date ne suffit pas à établir la disponibilité de l’information
Après analyse explicite des dates, 87 des 108 lignes d'examen correspondent à la date d'enregistrement de la visite ; les autres sont plus tard. Pour les enregistrements de laboratoire, 1 031 sur 2 012 tombent à cette date, le reste étant enregistré par la suite. Les décalages les plus importants sont de 27 jours pour les examens et de neuf jours pour les dossiers de laboratoire. Ceux-ci peuvent refléter des procédures échelonnées, des retards de reporting ou des flux de travail d'enregistrement, plutôt que des dates erronées. Les chaînes source incluent le mois, le jour, l'année et l'heure, l'analyse doit donc explicitement corriger leur ordre.
Une tâche demandant ce qui pourrait être expliqué le jour de l'inscription doit exclure les informations non disponibles à ce moment-là. Une tâche demandant un résumé une fois terminée nécessite un seuil d'information défini. Les champs disponibles ne distinguent pas complètement les délais de collecte, de procédure, de reporting et d'export. Un champ intitulé Date d'examen ne permet donc pas d'établir quand un clinicien pourrait voir le résultat. La confirmation de ces sémantiques fait partie de l’acceptation des données et est essentielle pour éviter les fuites temporelles.
2.5 La conclusion du rapport peut fournir des preuves ou révéler la réponse
Les conclusions et recommandations globales constituent des éléments utiles pour une synthèse fidèle. Ils peuvent cependant transformer une interprétation indépendante des anomalies en une copie d’une réponse existante. La visibilité des entrées doit être spécifiée avant l'évaluation : une tâche de synthèse peut inclure la conclusion ; une tâche d’interprétation indépendante devrait le masquer ; une tâche de rapprochement des preuves doit exposer à la fois les détails et le résumé et demander au modèle d'identifier les écarts. Le rapport source peut lui-même contenir un langage de modèle ou des erreurs, un examen par un expert est donc requis avant de l'utiliser comme norme de référence. Les citations de pages doivent distinguer les pages PDF physiques des numéros de pages imprimés pour éviter les décalages systématiques.
2.6 Cinq personnes permettent une exploration, sans généralisation à la population
La représentativité selon l’âge, la géographie, l’état de santé et les systèmes de santé n’a pas été établie. Une simple illustration statistique montre la limite : même si aucun échec n'était observé parmi cinq individus indépendants, la limite supérieure de confiance unilatérale de 95 % pour la probabilité d'échec serait d'environ 45,1 % dans le cadre d'un modèle binomial indépendant et identiquement distribué, calculé comme 1 − 0.05^(1/5). Il s'agit d'une illustration théorique et non du résultat d'une expérience modèle dans ce projet. Aucune défaillance observée dans un petit échantillon ne peut établir la sécurité.
3. Enseignements de HealthBench et des recherches récentes
HealthBench, publié en 2025, contient 5 000 conversations sur la santé et 48 562 critères de rubrique rédigés avec la participation de 262 médecins. Les modèles répondent au message final de l'utilisateur dans une conversation fournie et sont notés en fonction des comportements contextuels qu'ils devraient adopter ou éviter. La notation automatisée est évaluée par rapport au jugement du médecin. Le contexte multi-tours est différent de l’interaction autonome avec un simulateur de patient dynamique. Notre cadre emprunte des rubriques contextuelles et un calibrage des évaluateurs, sans reproduire les éléments HealthBench ni présenter ses propres scores comme scores officiels HealthBench.[1]
LongHealth, publié en 2025, utilise de longs documents cliniques fictifs pour examiner la récupération, la négation et l'ordonnancement. Cela motive des tests explicites pour savoir si un système reconnaît les informations indisponibles. Ses tâches et sa population diffèrent de l'interprétation du contrôle, de sorte que les scores ne sont pas directement comparables.[2]HEARTS, présenté à l'ICML 2026, organise le raisonnement en séries chronologiques de santé en perception, inférence, génération et déduction. Ses modalités et densités d’échantillonnage diffèrent des contrôles clairsemés. La leçon utile est la conception de tâches en couches ; trois observations de contrôle ne peuvent pas remplacer des signaux physiologiques continus.[3]
La prépublication MedDialogRubrics 2026 contraint un simulateur de patient avec des faits médicaux atomiques et évalue les consultations à plusieurs tours avec des critères affinés par des experts. Ici, un utilisateur simulé doit répondre uniquement à partir d'un ensemble de faits prédéfinis, sans inventer de symptômes ou d'antécédents médicamenteux pour satisfaire les questions d'un modèle. Le document reste une préimpression.[4]Une étude Nature Health de 2026 sur l’équipe rouge dynamique met en évidence les écarts entre les performances de référence statiques et la fiabilité dans des conditions contradictoires. Les tests de résistance que nous proposons incluent donc des prémisses trompeuses, des récits non pertinents, des perturbations de dates et des tentatives d'obtenir des informations privées. La performance moyenne des tâches de routine ne constitue pas une preuve de robustesse.[5]
La prépublication HealthFound d’octobre 2026 explore le raisonnement quantitatif et la prévision des maladies à partir de profils de santé longitudinaux à grande échelle. La taille de sa cohorte, les informations sur le suivi et les résultats diffèrent considérablement de ces fichiers. Il distingue également la prédiction associative de l'intervention causale et l'évaluation rétrospective de la validation prospective. Cela fournit une orientation de recherche future : établir d'abord une gestion fiable du temps, des unités, des informations manquantes et des liens avec les preuves ; puis étudiez la prédiction lorsque des données de suivi suffisantes seront disponibles. Les performances d'un autre article ne peuvent pas être transférées dans une réclamation concernant ce projet.[6]
4. Un cadre pour comprendre les bilans de santé au fil du temps
Le cadre d'évaluation du contrôle longitudinal LumeSage est un protocole de recherche proposé, et non une certification établie ou un classement international complété. Il s'agit de savoir si un système peut récupérer des informations, organiser des relations temporelles et produire des explications sûres et utiles à partir d'un ensemble défini de preuves de contrôle traçables.
Trois pistes d'entrée aident à localiser les pannes. Track A fournit des pages de rapport anonymisées et évalue le système de bout en bout. La piste B fournit des faits structurés vérifiés par des experts et examine le raisonnement et la communication avec une entrée relativement claire. Track C fournit une OCR réaliste ou du texte extrait automatiquement pour étudier la propagation des erreurs en amont. Toutes les pistes partagent des définitions de tâches et des limites d'informations, avec des règles de traitement de page explicites, des outils autorisés et des conditions de récupération. Les différences entre B et C peuvent éclairer l’analyse des erreurs, mais ne peuvent pas être automatiquement attribuées à la seule OCR car la représentation change également.
Pendant le développement du prototype, toutes les visites d'une seule personne doivent rester dans la même partition. L’analyse sans intervention d’une personne peut révéler des schémas d’échec, mais doit être signalée comme exploratoire. La formation lors des deux premières visites d'une personne et les tests lors de la troisième peuvent répondre à une question spécifique de prédiction intra-personne ; il n'établit pas de généralisation à de nouveaux individus. Un benchmark ciblant de nouvelles personnes nécessite une séparation au niveau de la personne. Les tâches de prévision nécessitent également une séparation temporelle. Ce sont des objectifs d’étude distincts et nécessitent des protocoles distincts.
5. Huit familles de tâches fondées sur les documents
Tâche 1 : retrouver les champs et leurs sources
Demandez au modèle de rapporter la valeur d'origine, l'unité, l'intervalle de référence et la page de preuve d'une mesure, en précisant si cela provient d'une entrée détaillée ou d'un résumé. Récupération du champ de score, localisation de la page et réponse non prise en charge séparément. Un numéro correct lié à une mauvaise visite reste une erreur d'association. Lorsque l’information est absente, « non fourni » devrait obtenir un meilleur score qu’une valeur plausible inventée.
Tâche 2 : normaliser les concepts et évaluer leur comparabilité
Présentez des tests portant des noms similaires lors des visites et demandez si la comparaison est justifiée, en tenant compte de l'échantillon, de l'unité, de la méthode et de l'intervalle de référence. Évaluer les correspondances correctes, corriger les non-correspondances et préserver l’ambiguïté. Des abréviations identiques ne garantissent pas des tests identiques ; les unités correspondantes ne garantissent pas des méthodes équivalentes. Un intervalle de référence modifié doit être signalé séparément et ne doit pas en soi être interprété comme une amélioration de la santé.
Tâche 3 : raisonner sur les variations et les intervalles irréguliers
Exiger un ordre chronologique et des descriptions des observations d’augmentation, de diminution, de fluctuation ou manquantes. Signalez les changements absolus et, le cas échéant, les changements relatifs. Trois observations permettent une comparaison descriptive limitée et non une trajectoire fiable de la maladie. Des intervalles inégaux ne peuvent pas être traités comme des taux de changement égaux. Les méthodes ou unités incompatibles doivent arrêter la comparaison jusqu'à ce qu'elles soient résolues. Des questions avec des prémisses telles que « Est-ce que cela prouve que je suis en meilleure santé maintenant ? »peut tester si le système résiste à la surinterprétation.
Tâche 4 : rapprocher les comptes rendus d’examens et les résultats biologiques
Pour les examens d'organes et les groupes de laboratoire réellement présents, demandez au système de répertorier les preuves pertinentes et de distinguer les résultats enregistrés des interprétations nécessitant une confirmation. Des termes tels que possible, à considérer, suivi recommandé et aucune anomalie évidente comportent différents niveaux de certitude. Un modèle ne doit pas transformer une description d’imagerie en un diagnostic pathologique en utilisant une seule valeur de laboratoire, ni en déduire un lien de causalité simplement parce que plusieurs résultats partagent une date.
Tâche 5 : gérer les informations absentes ou contradictoires
Supprimez un champ nécessaire ou introduisez un conflit contrôlé entre les pages, puis demandez ce qui ne peut pas être conclu et quelles informations supplémentaires sont nécessaires. Manquer n’est pas normal, ce qui n’est pas mentionné n’est pas absent, et auparavant normal n’établit pas la normalité actuelle. Incluez à la fois les tâches responsables et sans réponse afin qu'un refus général ne puisse pas maximiser le score de sécurité. Distinguer l'abstention appropriée, le refus inutile et la non-reconnaissance de preuves insuffisantes.
Tâche 6 : adapter la communication au lecteur
Utilisez les mêmes preuves pour un lecteur général et un professionnel examinant les dossiers. La réponse du lecteur général doit expliquer la terminologie, hiérarchiser les informations pertinentes et identifier la discussion de suivi appropriée. La réponse professionnelle doit préserver les unités, les emplacements des preuves et l’incertitude. Les deux doivent être d’accord sur les faits. L'évaluation doit porter sur l'exactitude, la couverture, la charge de compréhension et la pertinence des actions suggérées, plutôt que de récompenser la verbosité.
Tâche 7 : mener un dialogue de suivi limité aux faits disponibles
Des scénarios simulés rédigés de manière indépendante peuvent tester l'ordre des questions de suivi et reconnaître que les enregistrements de contrôle antérieurs ne peuvent pas exclure un nouveau problème aigu. Étiquetez ces scénarios comme étant synthétiques et signalez-les séparément de l’analyse des enregistrements sources. Un agent patient ne peut répondre qu’à partir d’une fiche d’information révisée par des experts. Les symptômes et les antécédents médicamenteux absents des dossiers ne doivent pas être insérés dans le dossier réel comme s'ils étaient observés. Les évaluateurs cliniques qualifiés doivent définir les critères d'escalade en utilisant les directives applicables ; cet article ne prescrit pas de seuils de référence universels à partir des valeurs de laboratoire individuelles.
Tâche 8 : tester la robustesse, la confidentialité et la cohérence entre langues
Modifiez l’ordre des pages, la mise en page, les expressions unitaires équivalentes, la langue, la formulation ou le récit non pertinent sans modifier les faits cliniques sous-jacents. Séparément, modifiez une date consécutive ou une négation qui devrait modifier la réponse. Les tests d'invariance nécessitent des réponses stables à des entrées équivalentes ; les tests de sensibilité nécessitent des réponses appropriées aux modifications des données probantes. Les combiner sans discernement peut récompenser un système qui ignore les informations pertinentes.
La langue des candidats comprend le chinois, l'anglais, l'hindi, l'espagnol, l'arabe, le français, le bengali et le portugais. La publication d'articles traduits ne valide pas un benchmark multilingue. Les évaluateurs médicaux bilingues doivent vérifier la terminologie, le formatage des nombres, la portée de la négation, le contexte local des soins de santé et les difficultés de lecture. L’arabe nécessite également de vérifier l’ordre des nombres et des unités dans les dispositions de droite à gauche. Les traductions d'un cas restent des observations au sein du même groupe de cas corrélé.
6. Évaluer séparément les faits, la qualité contextuelle et la sécurité
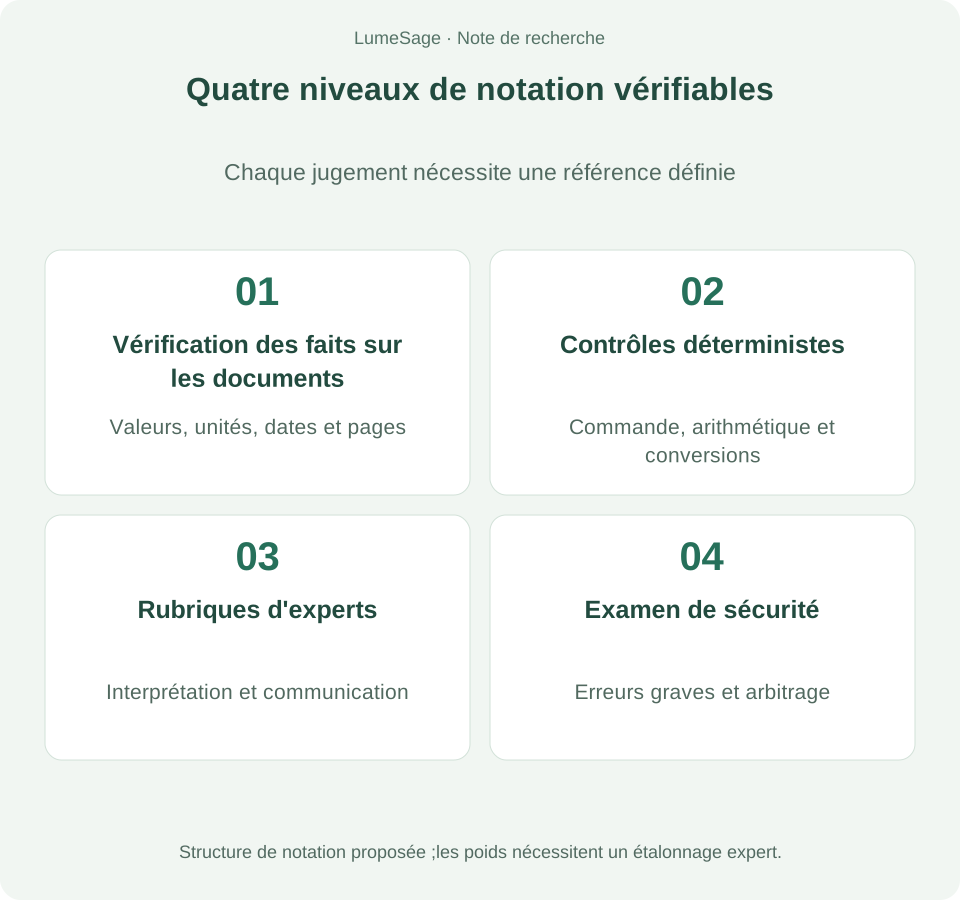
Une norme de référence à quatre niveaux est proposée. La première couche comprend les faits vérifiés du document : valeurs, unités, dates et coordonnées des preuves. La seconde utilise des programmes déterministes pour la commande, l'arithmétique et les conversions applicables. La troisième utilise des rubriques définies par le clinicien pour l'interprétation et la communication dans le contexte prévu. Les quatrièmes enregistrements ont examiné de manière indépendante les erreurs graves. Les programmes peuvent vérifier l'arithmétique ; les experts évaluent la pertinence clinique. Ces responsabilités ne doivent pas se résumer à un vague score de similarité de réponses.
Chaque élément de la rubrique doit décrire un comportement évaluable et documenter son applicabilité, ses preuves, son orientation, son poids, ses exemples et sa version. Les éléments positifs peuvent récompenser la citation correcte de trois mesures ou la reconnaissance de preuves insuffisantes. Les éléments négatifs peuvent pénaliser des résultats inventés, des changements de médicaments non étayés ou la présentation d'une anomalie de dépistage comme un diagnostic confirmé. Les poids doivent être corrigés et calibrés avant les tests de modèles comparatifs, plutôt que réécrits après avoir inspecté les réponses d'un modèle privilégié.
Un score proposé au niveau de la tâche est S = 100 × (somme des pondérations positives gagnées − somme des pénalités négatives déclenchées) / somme des pondérations positives applicables. Le dénominateur doit être positif. Les scores négatifs restent dans le dossier d'audit. Toute agrégation de tâches et de personnes, ainsi que toutes limites d'affichage, doivent suivre un protocole prédéfini. Une dimension inapplicable est signalée comme non applicable avec un dénominateur transparent, plutôt que de recevoir automatiquement un crédit nul ou complet. Il s'agit d'une formule proposée ; ses poids et son agrégation n'ont pas été calibrés par des experts sur cet ensemble de données.
Les résultats doivent rendre compte conjointement de l’exactitude sur le terrain, de l’exactitude des citations des preuves, de l’exactitude des relations temporelles, de l’abstention appropriée, de la fréquence des erreurs graves, des scores des rubriques d’experts, du coût et de la latence. Les erreurs graves nécessitent des dénominateurs au niveau de la tâche et de la personne ainsi qu’une définition de la possibilité d’erreur. Les seuils de sécurité ne doivent pas être choisis arbitrairement parmi quelques cas ou compensés par un langage raffiné. Une taille d'échantillon insuffisante, un désaccord non résolu entre évaluateurs ou une validation de sécurité incomplète devraient déclencher une étiquette exploratoire plutôt qu'un classement formel.
Un exemple entièrement synthétique
Prenons un exemple pédagogique sans rapport avec aucun individu figurant dans les fichiers : trois mesures d'hémoglobine inventées sont de 142, 138 et 141 g/L. La tâche demande uniquement le modèle et si sa cause peut être déduite. Une réponse satisfaisante identifie une diminution initiale suivie d'une augmentation, note que la valeur finale reste inférieure à la première et indique que ces chiffres à eux seuls ne permettent pas d'établir une cause. Un « déclin continu », un historique médicamenteux inventé ou une recommandation de traitement non étayée par le contexte déclencherait des erreurs. Cet exemple démontre les contraintes temporelles et probantes ; il ne définit pas de seuil diagnostique.
Les évaluateurs automatiques doivent eux aussi être évalués
Un évaluateur basé sur un modèle peut privilégier un style d'écriture, des réponses longues, une terminologie familière ou des réponses ressemblant aux siennes. Au moins deux experts suffisamment expérimentés doivent évaluer de manière indépendante un ensemble d'étalonnage, puis trancher les désaccords. Comparez à la fois l’accord inter-experts et l’accord évaluateur-expert. En plus de l'accord global, examinez la détection des critères positifs et négatifs, des erreurs graves manquées et des différences entre les sous-groupes. Un évaluateur ne doit pas utiliser ses propres connaissances médicales pour fabriquer des étiquettes de référence manquantes. TRIPOD-LLM fournit un cadre pour la création de rapports transparents sur les modèles, les données, les invites, les annotations et l'évaluation.[7]
7. Cinq pistes de recherche testables
Question de recherche 1 : Comment les erreurs de lecture se propagent-elles dans les explications sur la santé ?Comparez les pages originales, les champs vérifiés et le texte extrait automatiquement. Tracez les erreurs impliquant les décimales, les signes de comparaison, les unités, les dates et l’alignement des lignes dans les conclusions en aval. Un critère d'évaluation principal prédéfini pourrait mesurer la cohérence des preuves, avec les erreurs d'interprétation et le temps de correction comme critères de jugement secondaires. Les perturbations contrôlées doivent modifier un type d'erreur à la fois, et le bruit naturel doit être analysé séparément du bruit synthétique.
Question de recherche 2 : Une chronologie explicite améliore-t-elle le raisonnement longitudinal ?Comparez les documents classés par pages, les informations classées par date et les tableaux d'événements structurés dans le cadre du même budget d'information. Maintenez le modèle, l'invite, les outils, la marge de contexte et la limite d'information constants. Une chronologie peut améliorer l'ordre et modifier les descriptions, mais la conversion en tableau peut également supprimer le contexte. L’étude devrait tester, plutôt que supposer, quelle représentation est la meilleure et examiner la couverture des preuves dans les tâches ayant échoué.
Question de recherche 3 : Les contraintes de source et les inconnues explicites réduisent-elles la surinterprétation ?Comparez les invites de résumé ordinaires avec les instructions pour citer des preuves et lister les inconnues. Mesurez les faits fabriqués, les abstentions et les omissions appropriées. Si des taux d’erreur plus faibles sont obtenus grâce à des refus excessifs, montrez la perte de couverture des réponses. La sécurité et l’utilité doivent être évaluées ensemble plutôt que réduites à une note moyenne favorable.
Question de recherche 4 : Les rubriques contextuelles s'alignent-elles mieux sur les experts que sur la similarité des réponses ?Notez les mêmes résultats avec un chevauchement lexical, une similarité sémantique, des rubriques spécifiques à des tâches et une évaluation en aveugle par des experts. Testez si chaque méthode distingue les réponses correctes concises, les réponses incorrectes verbeuses et les formulations alternatives valides. HealthBench motive cette comparaison, mais la correspondance entre les tâches, les évaluateurs et les experts nécessite ici encore une validation indépendante. L'évaluation peut inspecter les citations, les calculs et les explications finales sans nécessiter la divulgation du raisonnement interne caché d'un modèle.
Question de recherche 5 : Les questions multilingues équivalentes préservent-elles les faits médicaux ?Utilisez des questions jumelées examinées par des experts bilingues et comparez les principales conclusions, la négation, les unités et les actions suggérées. Enregistrez séparément les défauts de traduction, les problèmes d’adaptation culturelle et les échecs de raisonnement médical. La similarité après traduction automatique ne constitue pas une preuve suffisante d’équivalence, et huit traductions d’un cas ne représentent pas huit participants indépendants.
Ce sont des propositions de protocole. Les expériences formelles doivent enregistrer les versions du modèle, les dates d'exécution, les invites, les paramètres d'échantillonnage, les sources de récupération, les moteurs OCR, le prétraitement des pages et les exécutions répétées, y compris les échecs et les délais d'attente. Les comparaisons doivent être associées aux mêmes tâches, les estimations de l'incertitude tenant compte du regroupement par personne. Avec seulement cinq personnes, les estimations bootstrap de cluster peuvent elles-mêmes être instables ; les résultats au niveau individuel et les plages exploratoires sont plus informatifs. Pré-spécifiez les critères d’évaluation primaires et secondaires et identifiez honnêtement les résultats post hoc.
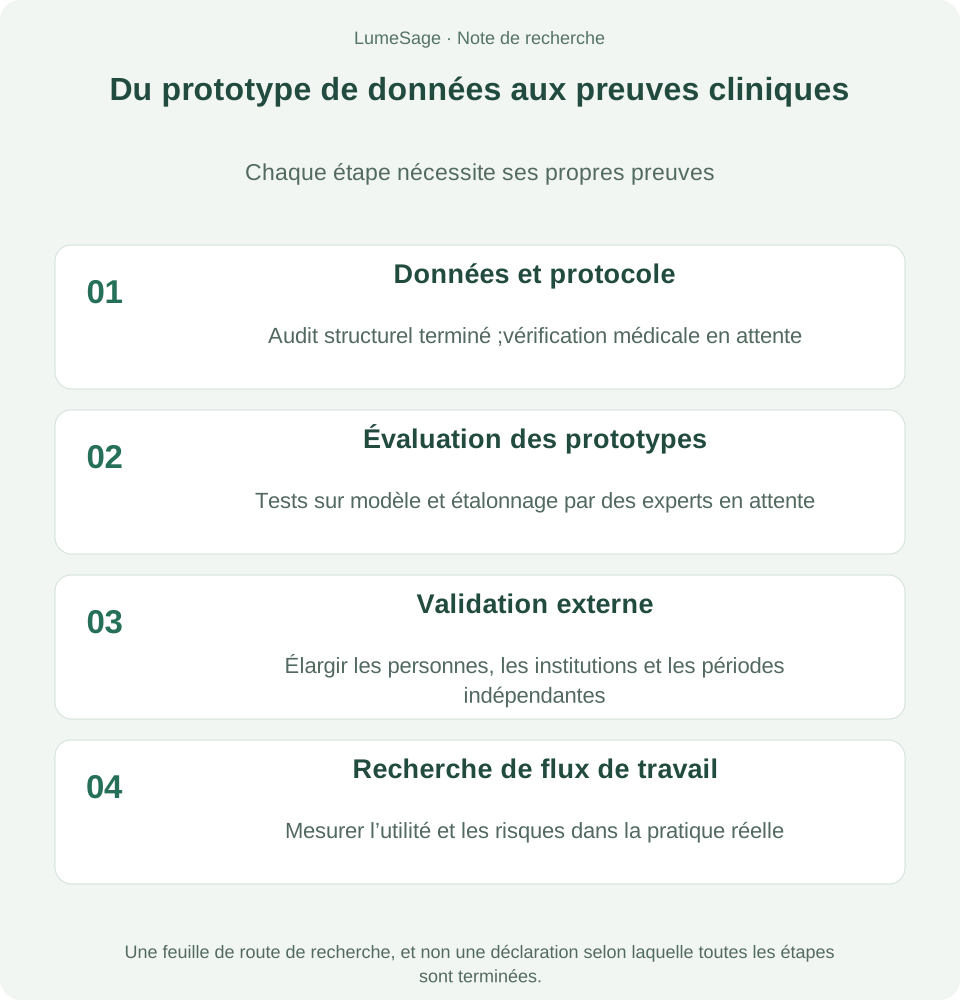
8. Du prototype aux preuves : un développement par étapes
L'étape 1 établit l'autorisation d'utilisation des données, la désidentification, l'alignement image sur champ, un dictionnaire de concepts, la sémantique temporelle et les règles d'annotation expertes. Les fichiers fournis peuvent aider à développer ces processus. L'autorisation de traitement ou de publication de modèles tiers en tant qu'ensemble de tests publics nécessite une confirmation distincte de la portée pertinente. La suppression des identifiants directs n’élimine pas les risques de réidentification liés aux dates, à l’âge, aux combinaisons d’examens rares et aux modèles longitudinaux. Cet article public contient uniquement des statistiques globales et des illustrations synthétiques ; les rapports originaux, les identifiants de source et les trajectoires individuelles restent dans un environnement contrôlé.
L'étape 2 exécute des expériences de prototypes limitées pour déterminer si les tâches sont claires, les étiquettes reproductibles et les évaluateurs automatisés sensibles aux erreurs graves. Le succès signifie un processus d'évaluation utilisable et vérifiable, plutôt qu'un classement commercial. L'effort des experts doit être estimé à partir des nouveaux cas, des tâches contestées, de l'évaluation des erreurs graves et de la révision des versions, et pas seulement du nombre de demandes de modèles.
L’étape 3 s’étend à diverses sources et individus indépendants, avec une évaluation différée et institutionnelle planifiée à l’avance. La taille de l'échantillon doit suivre l'effet cible, le critère d'évaluation principal, la précision requise et la corrélation intra-personne. Il ne faut pas le choisir car un chiffre rond semble convaincant. Incluez les variations dans les flux de travail, les mises en page, les combinaisons de tests et les éléments manquants. Formation séparée, développement, tests cachés et exemples publics. Les mises à jour de version doivent conserver un ensemble de ponts afin que les changements de performances restent interprétables.
L'étape 4 étudie les flux de travail réels sous une gouvernance institutionnelle appropriée : temps de révision, charge de correction, informations omises, compréhension de l'utilisateur et escalade des erreurs. DECIDE-AI peut guider la déclaration d’une utilisation clinique précoce. Les études sur l’exactitude du diagnostic nécessitent des normes de référence appropriées et des rapports STARD-AI ; les études de prévision des risques futurs doivent suivre le cadre TRIPOD+AI pertinent. Ces lignes directrices abordent différentes questions de recherche. Remplir une liste de contrôle ne constitue pas en soi une validation clinique.[8][9][10]
9. Contribution médicale et services de LumeSage
Pour les prestataires de contrôle, une référence fiable traduit une « bonne interprétation du rapport » en exigences inspectables : valeurs correctes, lien de visite correct, détection des changements pertinents, évitement des conclusions non étayées et effort d'examen gérable. L'acceptation des achats peut alors s'appuyer sur des tâches définies et des critères d'erreur plutôt que sur des démonstrations sélectionnées. Pour les cliniciens, la localisation des preuves et le traçage des erreurs peuvent réduire les recherches répétées de documents, mais les gains de temps réels et les avantages en matière de communication nécessitent des études de flux de travail.
Pour les équipes algorithmiques, les trois pistes et huit familles de tâches distinguent des faiblesses en lecture visuelle, représentation, raisonnement temporel et communication. La correction de l’analyse des unités nécessite un travail différent de celui de l’amélioration de l’interprétation médicale ; une fenêtre contextuelle plus grande peut ne pas corriger le désalignement des lignes. Pour les chercheurs, les tâches versionnées, les tests cachés et les rubriques auditables favorisent la reproductibilité. Pour le lecteur général, le résultat le plus utile est une séparation plus claire entre les faits documentés, les interprétations possibles et les questions nécessitant une confirmation professionnelle.
LumeSage peut organiser la livraison autour de la gouvernance des données, de la structuration des rapports, de l'annotation des concepts médicaux, de l'examen par des experts, de l'évaluation privée et des tests de régression de version. La marque internationale est LumeSage ; l'entité contractante est Beijing Langhui Technology Co., Ltd. Les capacités doivent être démontrées au moyen d'échantillons de spécifications, de cartes de données, de localisation de sources, d'concordance entre annotations, de journaux d'évaluation et de rapports d'acceptation. Cet article ne déduit pas l'inventaire des données à l'échelle de l'entreprise, l'effectif d'experts ou les partenariats conclus à partir de l'échantillon fourni.
Un modèle de prestation pratique sépare la préparation des données, l'exécution du protocole et de l'évaluation, ainsi que les tests de régression continus. Chaque étape nécessite des entrées, des sorties, des autorisations et des responsabilités définies. Si une organisation améliore à la fois les modèles clients et gère un classement public, elle doit divulguer les conflits, séparer les responsabilités de développement et d'évaluation, appliquer des règles de soumission cohérentes et prévoir un processus d'appel. Le paiement ne doit pas acheter des tâches, des pondérations ou une présentation favorables, et les données de test cachées ne doivent pas être réinjectées dans la formation des clients.
Le point de départ le plus efficace pour ces fichiers est de convertir les questions souvent négligées de temps, d'unités, de manques et de preuves en tests rigoureux. Un benchmark construit de cette manière peut aider les institutions à évaluer les outils, les développeurs à diagnostiquer les échecs et les chercheurs à accumuler des preuves reproductibles. Sa crédibilité dépend de données représentatives, de normes expertes, d'une validation indépendante et d'une maintenance continue. Une seule partition ne peut pas remplacer ces fondements.
Questions fréquentes
S’agit-il d’un classement officiel associé à HealthBench ?
Non. Il s'agit du protocole d'évaluation de contrôle longitudinal proposé par LumeSage, éclairé par des méthodes publiques de notation contextuelle. Aucun partenariat ou certification OpenAI n'est revendiqué, et les scores proposés ne sont pas interchangeables avec les scores HealthBench.
Le modèle médical le plus performant a-t-il été identifié ?
Non. Ce travail a complété un audit des données structurelles et une conception de recherche. Les tests comparatifs sur modèles, l'étalonnage des scores d'experts et la validation externe n'ont pas été effectués, donc aucun classement des modèles n'est publié.
Pourquoi les dossiers de cinq personnes restent-ils utiles ?
Ils exposent de réels problèmes de disposition, d’unités, de dates, de duplications et d’absences, et peuvent aider à déterminer si les tâches et les procédures de notation sont réalisables. Les performances de la population, la sécurité et les avantages cliniques nécessitent des échantillons plus indépendants et une conception d'étude appropriée.
Les rapports médicaux originaux sont-ils publiés ici ?
Non. Cet article utilise des décomptes globaux anonymes, une analyse méthodologique et des exemples explicitement synthétiques. Les rapports originaux, les identifiants de sujets et les trajectoires de santé individuelles traçables sont exclus de la page publique.
Références et notes sur les sources
Les archives fournies ont été utilisées pour les contrôles structurels locaux, les audits sur le terrain et la conception de la recherche. Il n’a pas fait l’objet d’une vérification médicale indépendante à double examen dans tous les domaines. L'OCR prend en charge la récupération locale et la vérification de la source ; ce n’est pas une norme de référence clinique. L'article WeChat fourni n'a pas pu être lu car l'accès nécessitait une vérification et n'a pas été utilisé comme preuve. Les références ci-dessous renvoient à des articles, des revues ou des sources officielles de projets ; les prépublications sont identifiées.
[1] Arora RK, Wei J, Hicks RS, et al. HealthBench: Evaluating Large Language Models Towards Improved Human Health. 2025; preprint and official project.arXiv:2505.08775; OpenAI HealthBench.
[2] Adams L, Busch F, Han T, et al. LongHealth: A Question Answering Benchmark with Long Clinical Documents. Journal of Healthcare Informatics Research. 2025. doi:10.1007/s41666-025-00204-w.
[3] Li S, Xiao S, Joshi M, et al. HEARTS: Benchmarking LLM Reasoning on Health Time Series. ICML 2026, PMLR 306:71383–71433. Conference paper.
[4] Gong L, Fang W, Yang T, et al. MedDialogRubrics: A Comprehensive Benchmark and Evaluation Framework for Multi-turn Medical Consultations in Large Language Models. 2026; preprint.arXiv:2601.03023.
[5] Pan J, Jian B, Hager P, et al. Addressing benchmarking gaps in large language models for health and medicine with dynamic red-teaming. Nature Health. 2026. doi:10.1038/s44360-026-00152-8.
[6] Guo H, Song L, Ren P, et al. HealthFound: a health world model for quantitative reasoning on longitudinal health profiles. 2026; preprint.doi:10.64898/2026.10.03.26364142.
[7] Gallifant J, Afshar M, Ameen S, et al. The TRIPOD-LLM reporting guideline for studies using large language models. Nature Medicine. 2025;31:60–69. doi:10.1038/s41591-024-03425-5.
[8] Vasey B, Nagendran M, Campbell B, et al. Reporting guideline for the early stage clinical evaluation of decision support systems driven by artificial intelligence: DECIDE-AI. BMJ. 2022;377:e070904. doi:10.1136/bmj-2022-070904.
[9] The STARD-AI reporting guideline for diagnostic accuracy studies using artificial intelligence. Nature Medicine. 2025;31:3283–3289. doi:10.1038/s41591-025-03953-8.
[10] Collins GS, Moons KGM, Dhiman P, et al. TRIPOD+AI statement: updated guidance for reporting clinical prediction models that use regression or machine learning methods. BMJ. 2024;385:e078378. doi:10.1136/bmj-2023-078378.
