Estado de la investigación:Este artículo relata una auditoría local de los archivos suministrados y propone un protocolo de evaluación. No se informan experimentos de modelos comparativos, puntuaciones de modelos, clasificaciones o afirmaciones de efectividad clínica. La literatura se revisó hasta el 26 de octubre de 2026.
Resumen: Una pregunta de investigación verificable basada en revisiones médicas
La evaluación médica de la IA se vuelve más informativa cuando plantea una pregunta concreta: dados tres controles de salud para la misma persona, ¿puede un sistema localizar las mediciones correctas, establecer su cronología, explicar los cambios, preservar la incertidumbre y comunicar en proporción a la evidencia? Esto requiere lectura de documentos, extracción de información, razonamiento temporal, interpretación médica y comunicación segura. Un modelo que responde con fluidez a las preguntas de un examen médico aún puede confundir una unidad, una fecha, una negación o un resumen de informe. Estos errores pueden propagarse hasta su asesoramiento final.
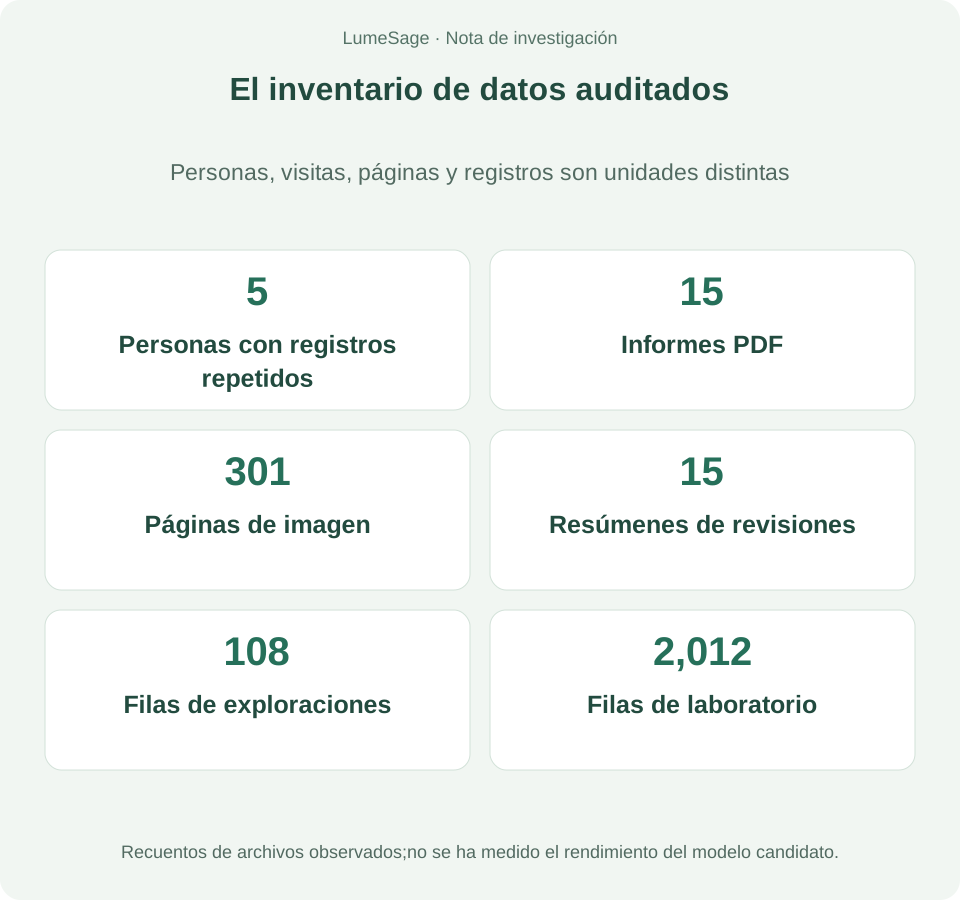
Nuestra auditoría local identificó cinco grupos de temas longitudinales, 15 informes en PDF con solo imágenes que contienen 301 páginas y tres hojas de trabajo estructuradas. Los identificadores asocian cada grupo a tres controles. Las hojas de trabajo contienen 15 resúmenes de visitas, 108 registros de exámenes y 2012 registros de laboratorio. Estos materiales respaldan un prototipo para la comprensión de informes, la síntesis longitudinal y la comunicación basada en evidencia. No proporcionan suficientes participantes independientes, etiquetas de resultados o cobertura institucional externa para establecer validez predictiva o una clasificación pública estable.
El marco de evaluación de chequeos longitudinales de LumeSage propuesto combina puntuación contextual inspirada en HealthBench con investigación sobre documentos clínicos extensos, razonamiento temporal, consultas de múltiples turnos y evaluación dinámica de seguridad. Define tres pistas de entrada, ocho familias de tareas, puntuación por niveles y adjudicación de expertos. Su contribución es un protocolo comprobable derivado de las características de los datos observados. La auditoría de datos completada se distingue explícitamente de los experimentos de modelos propuestos y la validación futura.
1. Qué investigación permiten los datos disponibles
1.1 Las personas, los controles y las mediciones son tamaños de muestra diferentes
La estructura del archivo y los identificadores estructurados se asignan a cinco grupos de sujetos con tres visitas cada uno. Los años de control registrados comprenden cinco visitas en 2023, cinco en 2024, cuatro en 2025 y una en 2026. El proveedor de datos debe confirmar la vinculación del tema antes de realizar un estudio formal. Los 15 archivos PDF contienen entre 13 y 26 páginas cada uno. Todas las páginas almacenan contenido como imágenes; la extracción de texto normal no arrojó ningún texto que se pueda buscar. Esto hace que el material sea útil para estudiar las diferencias entre la lectura de informes visuales y la entrada de datos estructurados.
Las 2.012 filas del laboratorio son observaciones a nivel de medición, no 2.012 participantes. Generar muchas preguntas a partir de un informe crea tareas correlacionadas en lugar de muestras clínicas independientes. Las visitas repetidas de una persona, las mediciones dentro de un informe y las paráfrasis de una pregunta siguen siendo dependientes. El análisis debe preservar la jerarquía de persona, visita, documento, campo y tarea. Ignorar esta estructura puede producir intervalos de confianza artificialmente estrechos y una significación estadística exagerada.
| Componente | Hallazgos en los archivos | Implicaciones para la evaluación |
|---|---|---|
| Informes originales | 15 archivos PDF;301 páginas; sin capa de texto extraíble | Pruebe la lectura de imágenes, la localización de tablas y la asociación entre páginas. |
| Resúmenes de las revisiones | 15 registros y 15 identificadores de visitas distintos | Cree resúmenes de visitas y síntesis de los controles |
| Registros de exploraciones | 108 filas, incluido un duplicado exacto | No equiparar el recuento de filas con exámenes únicos |
| Registros de laboratorio | 2.012 filas;368 cadenas de nombres de analitos sin procesar | Estandarizar terminología, especímenes, unidades y significado. |
| Relación entre tablas | Cada identificador de examen y visita de laboratorio se vincula a un registro de resumen de visita | Las uniones exitosas no establecen un acuerdo campo por campo con las imágenes de origen |
1.2 La multimodalidad a nivel de informe no es un conjunto de datos de imágenes sin procesar
La hoja de trabajo de examen contiene 70 filas de ultrasonido, 13 filas de TC, 15 filas de ECG, siete filas de RM, una fila de DR y dos filas de examen general. Estos son recuentos de filas sin procesar antes de la deduplicación. Demuestran cobertura de múltiples tipos de informes. El archivo no contiene series DICOM separadas ni señales de ECG sin procesar. Puede respaldar la investigación sobre la lectura de informes de imágenes junto con los hallazgos de laboratorio, pero no puede establecer la interpretación de la imagen de CT de un modelo, la comprensión de la secuencia de MRI o el rendimiento del análisis de formas de onda. Una imagen impresa incrustada en un PDF no equivale a una adquisición completa con sus parámetros originales.
La tabla resumen de visitas incluye sexo, altura, peso, presión arterial, fecha de registro y recomendaciones generales. La mesa de examen incluye procedimiento, hallazgos, conclusión y fecha. La tabla de laboratorio incluye analito, resultado, unidad, intervalo de referencia y señal de anomalía. No hay campos separados y completos para el historial de medicación, la trayectoria de los síntomas, el cumplimiento, la confirmación del diagnóstico o los resultados a largo plazo. Parte de esta información puede aparecer en los archivos PDF, pero no se puede asumir que esté completa. El caso de uso actual más sólido es comprender y comunicar evidencia de chequeo. El análisis causal del tratamiento, la predicción de enfermedades futuras y la evaluación de los beneficios clínicos requieren datos adicionales.
2. Seis hallazgos de la auditoría que deben orientar la evaluación
2.1 Los resultados y las unidades requieren una separación explícita
De los 2.012 resultados de laboratorio, 268 se almacenan como números de hoja de cálculo nativos y 1.744 como texto. En 1278 filas, el texto del resultado contiene la cadena que aparece en el campo de unidad correspondiente. Los resultados textuales no son inherentemente erróneos: los hallazgos, colores, morfología e intervalos negativos o positivos pueden expresarse legítimamente como texto. La tarea de procesamiento es preservar el resultado original mientras se separa el valor numérico, el comparador, la unidad, la interpretación cualitativa y el indicador de anomalía. Forzar cada resultado a un número de punto flotante puede descartar "por debajo del límite de detección", "no detectado" o "negativo" y puede reemplazar silenciosamente los valores faltantes con cero.
Una representación normalizada debe conservar valor_bruto, valor_numérico, comparador, unidad_bruto, unidad_normalizada y tipo_resultado, junto con la fila de origen y las coordenadas de la página. Las cadenas de unidades contienen variaciones en cuanto a mayúsculas y minúsculas, espaciado y símbolos de microunidades. El reemplazo de cuerdas por sí solo no es suficiente para la conversión de una unidad médica. Las comparaciones requieren analitos, muestras, métodos de medición y reglas de conversión compatibles. Cada transformación debe seguir siendo rastreable hasta la evidencia original.
2.2 Las unidades faltantes y los intervalos de referencia necesitan una evaluación de aplicabilidad
El campo de unidad está vacío en 548 filas y el campo de intervalo de referencia en 228 filas: aproximadamente el 27,2% y el 11,3% de los registros de laboratorio, respectivamente. Éstas son proporciones de campos faltantes, no tasas de error clínico. Es posible que las descripciones de colores, algunos hallazgos microscópicos y cantidades adimensionales no requieran una unidad convencional. Un intervalo de referencia faltante puede reflejar la prueba o el proceso de exportación. La anotación debe distinguir entre no aplicable, ausente en el informe fuente, omitido durante la estructuración y reconocimiento fallido. La imagen de origen y la definición de prueba deberían resolver esta distinción; el modelo no debe inventar un “rango normal”.
Las 228 filas sin un intervalo de referencia llevan un indicador de anomalía negativo en la tabla original. Esta combinación no prueba un error en los datos ni establece la normalidad. La bandera es un campo registrado para verificar, no una etiqueta de diagnóstico que anula el contexto. Las comprobaciones deterministas pueden evaluar resultados con valores numéricos, unidades y límites explícitos compatibles. Los hallazgos cualitativos, las descripciones complejas de intervalos y los umbrales de decisión clínica requieren reglas separadas y revisión de expertos.
2.3 Los duplicados y las variaciones de nombres pueden crear acuerdos engañosos
La mesa de examen contiene un duplicado exacto de un ítem de examen general. Otras dos filas tienen una conclusión pero ningún texto de hallazgos. A la altura, el peso, la presión arterial sistólica y la presión arterial diastólica les falta un valor en la tabla de resumen de visitas. Se debe verificar si un duplicado exacto se exporta repetidamente antes de crear un registro canónico. Los nombres de procedimientos repetidos pueden representar exámenes legítimos en diferentes momentos o sitios anatómicos. Los recuentos publicados deben indicar si se refieren a filas sin procesar o a eventos deduplicados.
Las 368 cadenas de nombres de laboratorio sin procesar no son necesariamente 368 conceptos clínicos distintos. Pruebas similares pueden tener nombres variantes, mientras que un término como "glóbulos blancos" puede referirse a diferentes tipos de muestras o grupos de pruebas. El mapeo conceptual requiere el grupo de prueba, la muestra, la unidad y el método. La combinación incorrecta de pruebas distintas y la separación incorrecta de pruebas equivalentes tienen consecuencias en el análisis longitudinal. Necesitan categorías de error y criterios de evaluación separados.
2.4 Un campo de fecha no define la disponibilidad de información
Después del análisis explícito de la fecha, 87 de 108 filas de examen corresponden a la fecha de registro de la visita; los demás son posteriores. Para los registros de laboratorio, 1.031 de 2.012 caen en esa fecha, y el resto se registra después. Las mayores compensaciones son de 27 días para exámenes y nueve días para registros de laboratorio. Estos pueden reflejar procedimientos por etapas, retrasos en la presentación de informes o flujos de trabajo de registro, en lugar de fechas erróneas. Las cadenas de origen incluyen mes, día, año y hora, por lo que el análisis debe fijar explícitamente su orden.
Una tarea que pregunte qué podría explicarse el día del registro debe excluir la información que no esté disponible en ese momento. Una tarea que solicita un resumen una vez finalizada necesita un límite de información definido. Los campos disponibles no distinguen completamente los tiempos de recolección, procedimiento, presentación de informes y exportación. Por lo tanto, una fecha de examen etiquetada en el campo no establece cuándo un médico podría ver el resultado. Confirmar esta semántica es parte de la aceptación de los datos y es esencial para evitar fugas temporales.
2.5 La conclusión de un informe puede ser evidencia o una filtración de respuesta
Las conclusiones y recomendaciones generales son aportes útiles para un resumen fiel. Sin embargo, pueden convertir la interpretación independiente de anomalías en la copia de una respuesta existente. La visibilidad de los insumos debe especificarse antes de la evaluación: una tarea de resumen puede incluir la conclusión; una tarea de interpretación independiente debería enmascararlo; Una tarea de conciliación de evidencia debe exponer tanto los detalles como el resumen y pedirle al modelo que identifique discrepancias. El informe fuente puede contener errores o lenguaje de plantilla, por lo que se requiere una revisión de expertos antes de usarlo como estándar de referencia. Las citas de páginas deben distinguir las páginas físicas del PDF de los números de páginas impresas para evitar desplazamientos sistemáticos.
2.6 Cinco grupos de sujetos apoyan la exploración, no las afirmaciones sobre población
No se ha establecido la representatividad por edad, geografía, estado de salud y sistemas de atención sanitaria. Una simple ilustración estadística muestra la limitación: incluso si no se observaran fallas entre cinco individuos independientes, el límite de confianza superior unilateral del 95% para la probabilidad de falla sería aproximadamente 45,1% bajo un modelo binomial independiente, distribuido idénticamente, calculado como 1 − 0.05^(1/5). Esta es una ilustración teórica, no el resultado de un experimento modelo en este proyecto. Cero fallas observadas en una muestra pequeña no pueden establecer la seguridad.
3. Lecciones de HealthBench y de la investigación reciente
HealthBench, lanzado en 2025, contiene 5000 conversaciones sobre salud y 48,562 criterios de rúbrica escritos con la participación de 262 médicos. Los modelos responden al mensaje del usuario final en una conversación proporcionada y se califican según los comportamientos contextuales que deberían realizar o evitar. La calificación automatizada se evalúa según el criterio del médico. El contexto de múltiples turnos es diferente de la interacción autónoma con un simulador de paciente con estado. Nuestro marco toma prestadas rúbricas contextuales y calibración de calificadores, sin reproducir elementos de HealthBench ni presentar sus propios puntajes como puntajes oficiales de HealthBench.[1]
LongHealth, publicado en 2025, utiliza largos documentos clínicos ficticios para examinar la recuperación, la negación y el pedido. Motiva pruebas explícitas de si un sistema reconoce información no disponible. Sus tareas y población difieren de la interpretación del chequeo, por lo que las puntuaciones no son directamente comparables.[2]HEARTS, presentado en ICML 2026, organiza el razonamiento de series temporales de salud en percepción, inferencia, generación y deducción. Sus modalidades y densidades de muestreo difieren de los controles dispersos. La lección útil es el diseño de tareas en capas; Tres observaciones de control no pueden sustituir señales fisiológicas continuas.[3]
La preimpresión de MedDialogRubrics de 2026 incluye un simulador de paciente con datos médicos atómicos y evalúa consultas de varios turnos con criterios refinados por expertos. Aquí, un usuario simulado debe responder únicamente a partir de un conjunto de hechos predefinidos, sin inventar síntomas o historial de medicación para satisfacer las preguntas de un modelo. El artículo sigue siendo una preimpresión.[4]Un estudio de Nature Health de 2026 sobre equipos rojos dinámicos destaca las brechas entre el rendimiento de referencia estático y la confiabilidad en condiciones adversas. Por lo tanto, nuestras pruebas de estrés propuestas incluyen premisas engañosas, narrativas irrelevantes, perturbaciones de fechas e intentos de obtener información privada. El desempeño promedio de tareas rutinarias no es evidencia de solidez.[5]
La preimpresión de HealthFound de octubre de 2026 explora el razonamiento cuantitativo y la predicción de enfermedades a partir de perfiles de salud longitudinales a gran escala. El tamaño de su cohorte, el seguimiento y la información de resultados difieren sustancialmente de estos archivos. También distingue la predicción asociativa de la intervención causal y la evaluación retrospectiva de la validación prospectiva. Esto proporciona una dirección de investigación futura: primero establecer un manejo confiable del tiempo, las unidades, la información faltante y la vinculación de evidencia; luego investigue la predicción cuando haya suficientes datos de seguimiento disponibles. El desempeño de otro documento no se puede transferir a un reclamo sobre este proyecto.[6]
4. Un marco para comprender informes médicos longitudinales
El marco de evaluación del control longitudinal de LumeSage es un protocolo de investigación propuesto, no una certificación establecida ni una tabla de clasificación internacional completa. Se pregunta si un sistema puede recuperar información, organizar relaciones temporales y producir explicaciones seguras y útiles a partir de un conjunto definido de evidencia de verificación rastreable.
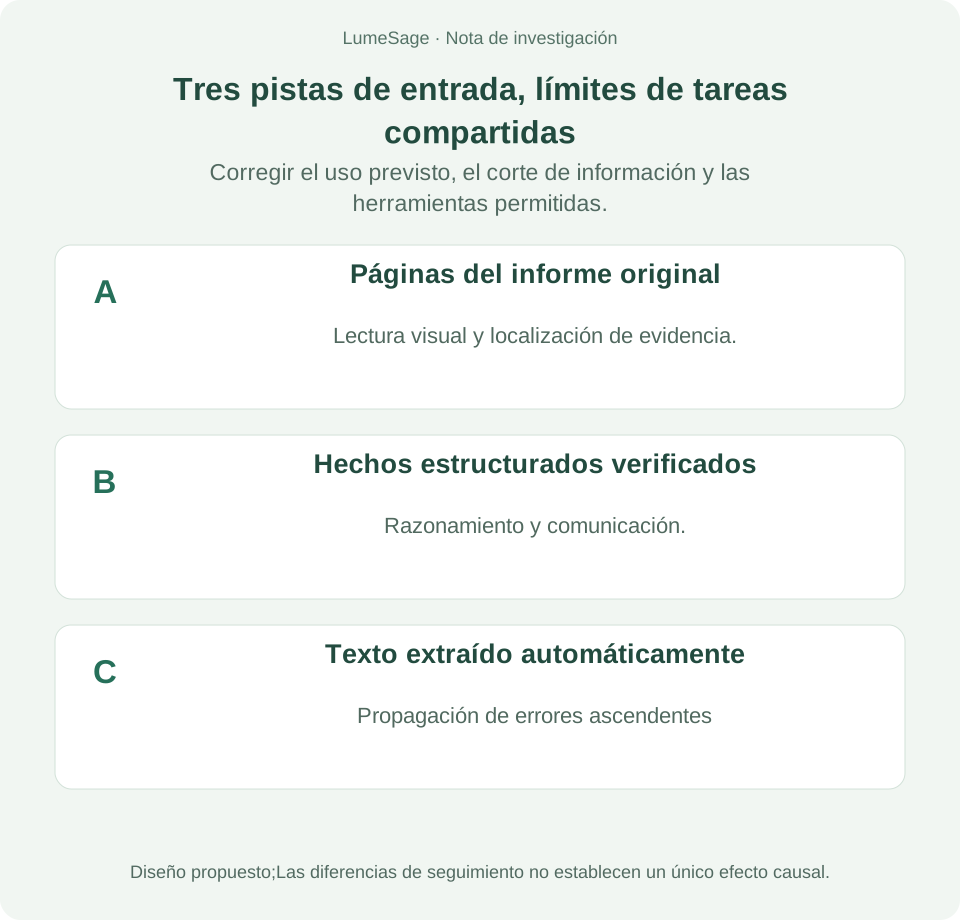
Tres pistas de entrada ayudan a localizar fallas. Track A proporciona páginas de informes no identificadas y evalúa el sistema de un extremo a otro. La pista B proporciona hechos estructurados verificados por expertos y examina el razonamiento y la comunicación con una información relativamente limpia. Track C proporciona OCR realista o texto extraído automáticamente para investigar la propagación de errores ascendentes. Todas las pistas comparten definiciones de tareas y límites de información, con reglas explícitas de procesamiento de páginas, herramientas permitidas y condiciones de recuperación. Las diferencias entre B y C pueden informar el análisis de errores, pero no pueden atribuirse automáticamente solo al OCR porque la representación también cambia.
Durante el desarrollo del prototipo, todas las visitas de una persona deben permanecer en la misma partición. El análisis que excluye a una persona puede revelar patrones de falla, pero debe informarse como exploratorio. La capacitación en las dos primeras visitas de una persona y las pruebas en la tercera pueden abordar una pregunta específica de predicción interna; no establece generalización a nuevos individuos. Un punto de referencia dirigido a personas nuevas requiere una separación a nivel de persona. Las tareas de previsión también requieren una separación temporal. Estos son objetivos de estudio distintos y necesitan protocolos distintos.
5. Ocho tipos de tareas basados en los documentos
Tarea 1: localizar campos y su fuente de evidencia
Pídale al modelo que informe el valor original, la unidad, el intervalo de referencia y la página de evidencia de una medición, especificando si proviene de una entrada detallada o de un resumen. Recuperación de campos de puntuación, localización de páginas y respuestas no admitidas por separado. Un número correcto vinculado a una visita incorrecta sigue siendo un error de asociación. Cuando falta información, “no proporcionada” debería obtener una puntuación mejor que un valor plausible inventado.
Tarea 2: Normalizar conceptos y evaluar la comparabilidad
Presente pruebas con nombres similares en las visitas y pregunte si la comparación está justificada, considerando la muestra, la unidad, el método y el intervalo de referencia. Evaluar coincidencias correctas, corregir no coincidencias y preservación de la ambigüedad. Abreviaturas idénticas no garantizan pruebas idénticas; Las unidades coincidentes no garantizan métodos equivalentes. Un intervalo de referencia modificado debe informarse por separado y no debe interpretarse en sí mismo como una mejora de la salud.
Tarea 3: Razonar el cambio y los intervalos irregulares
Requerir orden cronológico y descripciones de aumento, disminución, fluctuación u observaciones faltantes. Informar los cambios absolutos y, en su caso, los cambios relativos. Tres observaciones permiten una comparación descriptiva limitada, no una trayectoria confiable de la enfermedad. Los intervalos desiguales no pueden tratarse como tasas de cambio iguales. Los métodos o unidades incompatibles deben detener la comparación hasta que se resuelvan. Preguntas con premisas como “¿Esto demuestra que ahora estoy más sano?”Puede probar si el sistema resiste la sobreinterpretación.
Tarea 4: Conciliar los resultados del examen y la evidencia de laboratorio
Para los exámenes de órganos y los grupos de laboratorio realmente presentes, solicite al sistema que enumere las pruebas relevantes y distinga los hallazgos registrados de las interpretaciones que requieren confirmación. Términos como posible, considerar, seguimiento recomendado y ninguna anomalía obvia conllevan diferentes niveles de certeza. Un modelo no debe convertir una descripción de imágenes en un diagnóstico patológico utilizando un valor de laboratorio, ni inferir la causalidad simplemente porque varios hallazgos comparten una fecha.
Tarea 5: Manejar información faltante o contradictoria
Elimine un campo necesario o introduzca un conflicto controlado entre páginas, luego pregunte qué no se puede concluir y qué información adicional se necesita. Faltar no es normal, lo no mencionado no está ausente y lo que antes era normal no establece la normalidad actual. Incluya tareas con y sin respuesta para que un rechazo total no pueda maximizar la puntuación de seguridad. Distinguir abstención apropiada, negativa innecesaria y falta de reconocimiento de pruebas insuficientes.
Tarea 6: Comunicarse adecuadamente para diferentes lectores
Utilice la misma evidencia para un lector general y un profesional que revisa los registros. La respuesta del lector general debe explicar la terminología, priorizar la información relevante e identificar discusiones de seguimiento apropiadas. La respuesta profesional debe preservar las unidades, la ubicación de las pruebas y la incertidumbre. Ambos deben estar de acuerdo en los hechos. La evaluación debe abordar la precisión, la cobertura, la carga de comprensión y la idoneidad de las acciones sugeridas, en lugar de recompensar la verbosidad.
Tarea 7: Llevar a cabo un diálogo de seguimiento restringido
Los escenarios simulados creados de forma independiente pueden probar el orden de las preguntas de seguimiento y el reconocimiento de que los registros de controles anteriores no pueden excluir un nuevo problema agudo. Etiquete estos escenarios como sintéticos e infórmelos por separado del análisis de los registros fuente. Un agente paciente sólo puede responder a partir de una hoja informativa revisada por un experto. Los síntomas y los historiales de medicación ausentes en los archivos no deben insertarse en el registro real como si se hubieran observado. Los revisores clínicos calificados deben definir los criterios de escalamiento utilizando la guía aplicable; este artículo no prescribe umbrales de derivación universales a partir de valores de laboratorio individuales.
Tarea 8: Probar la solidez, la privacidad y la coherencia multilingüe
Cambie el orden de las páginas, el diseño, las expresiones de unidades equivalentes, el idioma, la redacción o la narrativa irrelevante sin cambiar los hechos clínicos subyacentes. Por separado, cambie una fecha importante o una negación que debería alterar la respuesta. Las pruebas de invarianza requieren respuestas estables a entradas equivalentes; Las pruebas de sensibilidad requieren respuestas apropiadas a la evidencia modificada. Combinarlos indiscriminadamente puede recompensar a un sistema que ignora la información relevante.
La cobertura de idiomas de los candidatos incluye chino, inglés, hindi, español, árabe, francés, bengalí y portugués. La publicación de artículos traducidos no valida un punto de referencia multilingüe. Los revisores médicos bilingües deben verificar la terminología, el formato de los números, el alcance de la negación, el contexto de atención médica local y la dificultad de lectura. El árabe también requiere verificar el orden de los números y las unidades en diseños de derecha a izquierda. Las traducciones de un caso siguen siendo observaciones dentro del mismo grupo de casos correlacionados.
6. Evaluar por separado los hechos, la calidad contextual y la seguridad
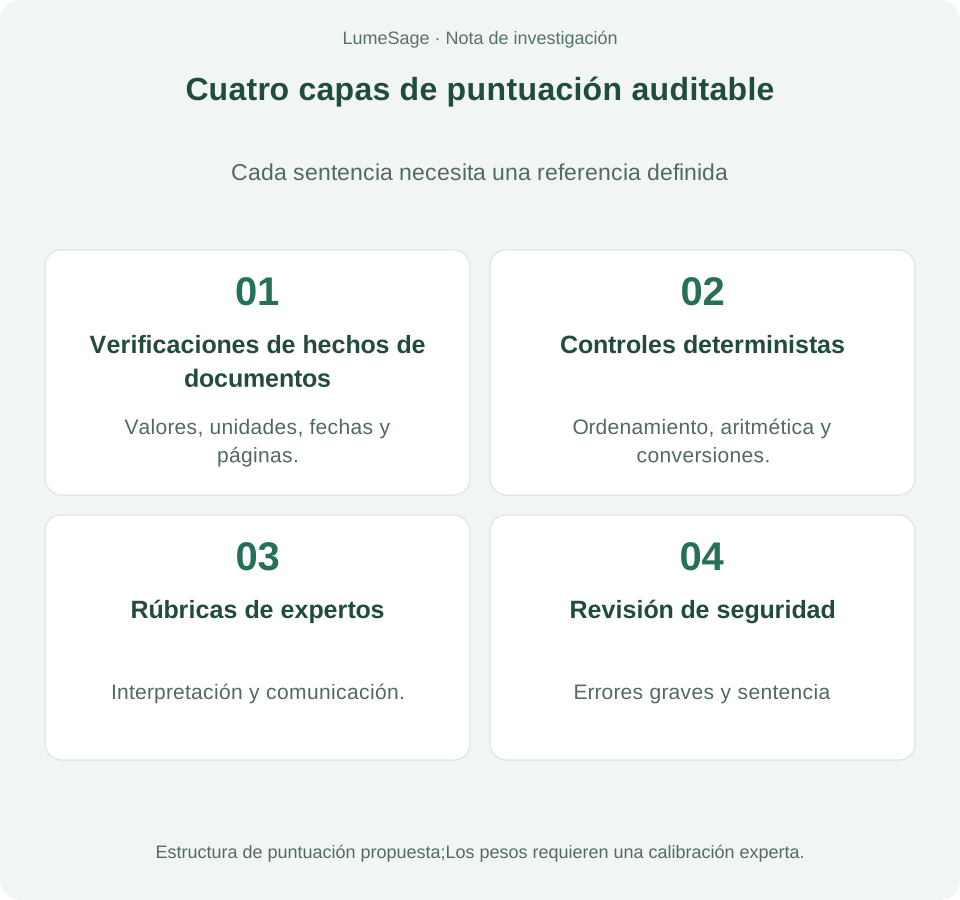
Se propone un estándar de referencia de cuatro capas. La primera capa consta de hechos del documento verificados: valores, unidades, fechas y coordenadas de evidencia. El segundo utiliza programas deterministas para ordenar, aritmética y conversiones aplicables. El tercero utiliza rúbricas definidas por el médico para la interpretación y comunicación en el entorno previsto. Los cuartos registros revisaron de forma independiente errores graves. Los programas pueden verificar la aritmética; Los expertos evalúan la idoneidad clínica. Estas responsabilidades no deberían reducirse a una vaga puntuación de similitud de respuestas.
Cada elemento de la rúbrica debe describir un comportamiento evaluable y documentar su aplicabilidad, evidencia, dirección, peso, ejemplos y versión. Los ítems positivos podrían recompensar la cita correcta de tres mediciones o el reconocimiento de evidencia insuficiente. Los ítems negativos podrían penalizar hallazgos inventados, cambios de medicación no respaldados o presentar una anomalía en el examen como diagnóstico confirmado. Las ponderaciones deben fijarse y calibrarse antes de probar el modelo comparativo, en lugar de reescribirse después de inspeccionar las respuestas de un modelo favorito.
Una puntuación propuesta a nivel de tarea es S = 100 × (suma de ponderaciones positivas obtenidas − suma de penalizaciones negativas activadas) / suma de ponderaciones positivas aplicables. El denominador debe ser positivo. Las puntuaciones negativas permanecen en el registro de auditoría. Cualquier agregación entre tareas y personas, y cualquier límite de visualización, debe seguir un protocolo preespecificado. Una dimensión inaplicable se informa como no aplicable con un denominador transparente, en lugar de recibir automáticamente cero o crédito completo. Esta es una fórmula propuesta; sus ponderaciones y agregación no han sido calibradas por expertos en este conjunto de datos.
Los resultados deben informar conjuntamente la precisión de campo, la precisión de las citas de evidencia, la precisión de la relación temporal, la abstención apropiada, la frecuencia de errores graves, las puntuaciones de las rúbricas de expertos, el costo y la latencia. Los errores graves requieren denominadores a nivel de tarea y de persona y una definición de la oportunidad de error. Los umbrales de seguridad no deben elegirse arbitrariamente a partir de unos pocos casos ni compensarse con un lenguaje refinado. Un tamaño de muestra insuficiente, un desacuerdo no resuelto entre los revisores o una validación de seguridad incompleta deberían desencadenar una etiqueta exploratoria en lugar de una clasificación formal.
Un ejemplo totalmente sintético
Consideremos un ejemplo educativo no relacionado con ningún individuo de los archivos: tres mediciones de hemoglobina inventadas son 142, 138 y 141 g/L. La tarea sólo pregunta por el patrón y si se puede inferir su causa. Una respuesta satisfactoria identifica una disminución inicial seguida de un aumento, señala que el valor final permanece por debajo del primero y afirma que estos números por sí solos no establecen una causa. Un “declive continuo”, un historial de medicación inventado o una recomendación de tratamiento no respaldada por el contexto desencadenarían errores. Este ejemplo demuestra limitaciones temporales y probatorias; no define un umbral de diagnóstico.
Los calificadores automatizados también necesitan evaluación
Un calificador basado en modelos puede preferir un estilo de escritura, respuestas largas, terminología familiar o respuestas que se parezcan a las suyas. Al menos dos expertos con la experiencia adecuada deben evaluar de forma independiente un conjunto de calibración, seguido de la resolución de desacuerdos. Compare tanto el acuerdo entre expertos como el acuerdo entre calificador y experto. Además del acuerdo general, examine la detección de criterios positivos y negativos, errores graves omitidos y diferencias de subgrupos. Un clasificador no debe utilizar sus propios conocimientos médicos para fabricar etiquetas de referencia faltantes. TRIPOD-LLM proporciona un marco para la presentación de informes transparentes de modelos, datos, indicaciones, anotaciones y evaluaciones.[7]
7. Cinco líneas de investigación contrastables
Pregunta de investigación 1: ¿Cómo se propagan los errores de lectura en las explicaciones sobre la salud?Compare páginas originales, campos verificados y texto extraído automáticamente. Rastree errores que involucran decimales, signos de comparación, unidades, fechas y alineación de filas hasta llegar a conclusiones posteriores. Un criterio de valoración primario preespecificado podría medir la coherencia de la evidencia, con errores de interpretación y tiempo de corrección como resultados secundarios. Las perturbaciones controladas deberían alterar un tipo de error a la vez, y el ruido natural debería analizarse por separado del ruido sintético.
Pregunta de investigación 2: ¿Una línea de tiempo explícita mejora el razonamiento longitudinal?Compare documentos ordenados por páginas, información ordenada por fechas y tablas de eventos estructuradas con el mismo presupuesto de información. Mantenga constantes el modelo, el mensaje, las herramientas, la asignación de contexto y el límite de información. Una línea de tiempo puede mejorar el orden y cambiar las descripciones, pero la conversión a una tabla también puede eliminar el contexto. El estudio debería probar, en lugar de asumir, qué representación es mejor y examinar la cobertura de evidencia en tareas fallidas.
Pregunta de investigación 3: ¿Las restricciones de fuente y las incógnitas explícitas reducen la sobreinterpretación?Compare indicaciones de resúmenes ordinarias con instrucciones para citar evidencia y enumerar incógnitas. Medir hechos fabricados, abstenciones y omisiones apropiadas. Si se logran tasas de error más bajas mediante un rechazo excesivo, muestre la pérdida de cobertura de las respuestas. La seguridad y la utilidad deben evaluarse juntas en lugar de reducirse a una puntuación media favorable.
Pregunta de investigación 4: ¿Las rúbricas contextuales se alinean mejor con los expertos que la similitud de respuestas?Califique los mismos resultados con superposición léxica, similitud semántica, rúbricas de tareas específicas y revisión ciega de expertos. Pruebe si cada método distingue respuestas correctas concisas, respuestas incorrectas detalladas y redacción alternativa válida. HealthBench motiva esta comparación, pero la coincidencia entre tareas, evaluadores y expertos todavía requiere una validación independiente. La evaluación puede inspeccionar citas, cálculos y explicaciones finales sin necesidad de revelar el razonamiento interno oculto de un modelo.
Pregunta de investigación 5: ¿Las preguntas multilingües equivalentes preservan los datos médicos?Utilice preguntas pareadas revisadas por expertos bilingües y compare hallazgos clave, negaciones, unidades y acciones sugeridas. Registre por separado los defectos de traducción, los problemas de adaptación cultural y las fallas de razonamiento médico. La similitud después de la traducción automática no es evidencia suficiente de equivalencia, y ocho traducciones de un caso no son ocho participantes independientes.
Estas son propuestas de protocolo. Los experimentos formales deben registrar versiones del modelo, fechas de ejecución, indicaciones, configuraciones de muestreo, fuentes de recuperación, motores de OCR, preprocesamiento de páginas y ejecuciones repetidas, incluidos fallos y tiempos de espera. Las comparaciones deben realizarse por pares en las mismas tareas, y las estimaciones de incertidumbre deben tener en cuenta la agrupación por persona. Con sólo cinco personas, las estimaciones de arranque de conglomerados pueden ser en sí mismas inestables; Los resultados a nivel individual y los rangos exploratorios son más informativos. Preespecificar los criterios de valoración primarios y secundarios e identificar los hallazgos post hoc de manera honesta.
8. Del prototipo a la evidencia: un desarrollo por etapas
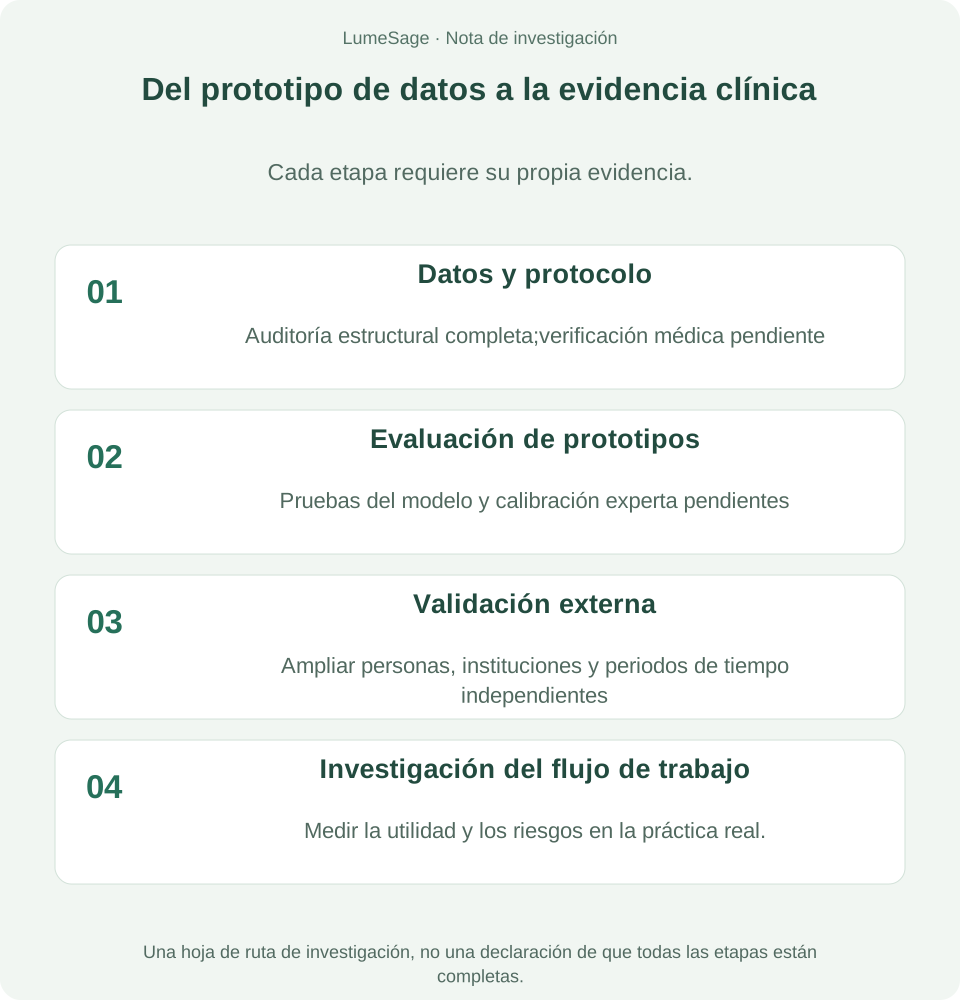
La etapa 1 establece la autorización de uso de datos, la desidentificación, la alineación de la imagen con el campo, un diccionario de conceptos, semántica de tiempo y reglas de anotación de expertos. Los archivos suministrados pueden ayudar a desarrollar estos procesos. El permiso para el procesamiento o lanzamiento de modelos de terceros como un conjunto de pruebas públicas requiere una confirmación por separado del alcance relevante. La eliminación de identificadores directos no elimina los riesgos de reidentificación a partir de fechas, edades, combinaciones raras de exámenes y patrones longitudinales. Este artículo público contiene únicamente estadísticas agregadas e ilustraciones sintéticas; Los informes originales, los identificadores de fuentes y las trayectorias individuales permanecen en un entorno controlado.
La etapa 2 ejecuta experimentos de prototipos limitados para determinar si las tareas son claras, si las etiquetas son reproducibles y si los clasificadores automatizados son sensibles a errores graves. El éxito significa un proceso de evaluación utilizable y auditable, en lugar de una clasificación comercial. El esfuerzo de los expertos debe estimarse a partir de casos nuevos, tareas en disputa, adjudicación de errores graves y revisión de versiones, no simplemente a partir del número de solicitudes de modelos.
La etapa 3 se expande a diversas fuentes e individuos independientes, con una evaluación realizada por la institución y por el tiempo planificada de antemano. El tamaño de la muestra debe seguir el efecto objetivo, el criterio de valoración principal, la precisión requerida y la correlación intrapersonal. No debe elegirse porque un número redondo suene persuasivo. Incluya variaciones en los flujos de trabajo, diseños, combinaciones de pruebas y faltas. Separe la capacitación, el desarrollo, las pruebas ocultas y los ejemplos públicos. Las actualizaciones de versión deben conservar un conjunto puente para que los cambios en el rendimiento sigan siendo interpretables.
La etapa 4 estudia flujos de trabajo reales bajo una gobernanza institucional adecuada: tiempo de revisión, carga de corrección, información omitida, comprensión del usuario y escalada de errores. DECIDE-AI puede guiar la notificación del uso clínico temprano. Los estudios de precisión diagnóstica necesitan estándares de referencia apropiados e informes STARD-AI; Los estudios de predicción de riesgos futuros deben seguir el marco TRIPOD+AI pertinente. Estas directrices abordan diferentes preguntas de investigación. Completar una lista de verificación no es en sí misma una validación clínica.[8][9][10]
9. Contribución médica y servicios de LumeSage
Para los proveedores de controles, un punto de referencia confiable traduce una “buena interpretación de informes” en requisitos inspeccionables: valores correctos, vinculación correcta de visitas, detección de cambios relevantes, evitar conclusiones no respaldadas y esfuerzo de revisión manejable. La aceptación de la adquisición puede entonces depender de tareas definidas y criterios de error en lugar de demostraciones seleccionadas. Para los médicos, la localización de evidencia y el rastreo de errores pueden reducir las búsquedas repetidas de documentos, pero el ahorro de tiempo real y los beneficios de comunicación requieren estudios del flujo de trabajo.
Para los equipos de algoritmos, las tres pistas y las ocho familias de tareas distinguen debilidades en la lectura visual, la representación, el razonamiento temporal y la comunicación. Arreglar el análisis de unidades requiere un trabajo diferente al de mejorar la interpretación médica; Es posible que una ventana de contexto más grande no solucione la desalineación de las filas. Para los investigadores, las tareas versionadas, las pruebas ocultas y las rúbricas auditables respaldan la reproducibilidad. Para los lectores en general, el resultado más útil es una separación más clara entre hechos documentados, posibles interpretaciones y cuestiones que requieren confirmación profesional.
LumeSage puede organizar la entrega en torno a la gestión de datos, la estructuración de informes, la anotación de conceptos médicos, la revisión de expertos, la evaluación privada y las pruebas de regresión de versiones. La marca internacional es LumeSage; la entidad contratante es Beijing Langhui Technology Co., Ltd. Las capacidades deben demostrarse mediante especificaciones de muestra, tarjetas de datos, localización de fuentes, acuerdos de anotaciones, registros de evaluación e informes de aceptación. Este artículo no infiere el inventario de datos de toda la empresa, el número de expertos ni las asociaciones completadas a partir de la muestra proporcionada.
Un modelo de entrega práctico separa la preparación de datos, la ejecución del protocolo y la evaluación, y las pruebas de regresión continuas. Cada etapa necesita entradas, salidas, permisos y responsabilidades definidas. Si una organización mejora los modelos de clientes y opera una tabla de clasificación pública, debe revelar los conflictos, separar las responsabilidades de desarrollo y evaluación, aplicar reglas de presentación consistentes y proporcionar un proceso de apelación. El pago no debe comprar tareas, pesos o presentaciones favorables, y los datos ocultos de las pruebas no deben refluir a la formación del cliente.
El punto de partida más sólido para estos archivos es convertir cuestiones de tiempo, unidades, faltantes y evidencia que a menudo se pasan por alto en pruebas rigurosas. Un punto de referencia construido de esta manera puede ayudar a las instituciones a evaluar herramientas, a los desarrolladores a diagnosticar fallas y a los investigadores a acumular evidencia reproducible. Su credibilidad depende de datos representativos, estándares de expertos, validación independiente y mantenimiento continuo. Una sola partitura no puede sustituir esos fundamentos.
Preguntas frecuentes
¿Es esta una subclasificación oficial de HealthBench?
No. Este es el protocolo de evaluación de chequeo longitudinal propuesto por LumeSage, basado en métodos públicos de puntuación contextual. No se afirma ninguna asociación o certificación con OpenAI, y las puntuaciones propuestas no son intercambiables con las puntuaciones de HealthBench.
¿Se ha identificado el modelo médico con mejor rendimiento?
No. Este trabajo completó una auditoría de datos estructurales y un diseño de investigación. No se han realizado pruebas comparativas de modelos, calibración de puntuaciones de expertos ni validación externa, por lo que no se publica ninguna clasificación de modelos.
¿Por qué siguen siendo útiles cinco grupos de materias?
Exponen problemas reales en diseño, unidades, fechas, duplicaciones y faltantes, y pueden ayudar a establecer si las tareas y los procedimientos de puntuación son viables. El rendimiento de la población, la seguridad y el beneficio clínico requieren muestras más independientes y un diseño de estudio adecuado.
¿Los informes de salud originales están disponibles públicamente aquí?
No. Este artículo utiliza recuentos agregados anónimos, análisis metodológicos y ejemplos explícitamente sintéticos. Los informes originales, los identificadores de sujetos y las trayectorias de salud individuales rastreables están excluidos de la página pública.
Referencias y notas sobre las fuentes
El archivo suministrado se utilizó para comprobaciones estructurales locales, auditorías de campo y diseño de investigaciones. No se ha sometido a una verificación médica independiente de doble revisión en todos los campos. OCR apoyó la recuperación local y la verificación de fuentes; no es un estándar de referencia clínica. El artículo de WeChat proporcionado no se pudo leer porque el acceso requería verificación y no se utilizó como prueba. Las referencias a continuación enlazan a artículos, revistas o fuentes oficiales de proyectos; Se identifican las preimpresiones.
[1] Arora RK, Wei J, Hicks RS, et al. HealthBench: Evaluating Large Language Models Towards Improved Human Health. 2025; preprint and official project.arXiv:2505.08775; OpenAI HealthBench.
[2] Adams L, Busch F, Han T, et al. LongHealth: A Question Answering Benchmark with Long Clinical Documents. Journal of Healthcare Informatics Research. 2025. doi:10.1007/s41666-025-00204-w.
[3] Li S, Xiao S, Joshi M, et al. HEARTS: Benchmarking LLM Reasoning on Health Time Series. ICML 2026, PMLR 306:71383–71433. Conference paper.
[4] Gong L, Fang W, Yang T, et al. MedDialogRubrics: A Comprehensive Benchmark and Evaluation Framework for Multi-turn Medical Consultations in Large Language Models. 2026; preprint.arXiv:2601.03023.
[5] Pan J, Jian B, Hager P, et al. Addressing benchmarking gaps in large language models for health and medicine with dynamic red-teaming. Nature Health. 2026. doi:10.1038/s44360-026-00152-8.
[6] Guo H, Song L, Ren P, et al. HealthFound: a health world model for quantitative reasoning on longitudinal health profiles. 2026; preprint.doi:10.64898/2026.10.03.26364142.
[7] Gallifant J, Afshar M, Ameen S, et al. The TRIPOD-LLM reporting guideline for studies using large language models. Nature Medicine. 2025;31:60–69. doi:10.1038/s41591-024-03425-5.
[8] Vasey B, Nagendran M, Campbell B, et al. Reporting guideline for the early stage clinical evaluation of decision support systems driven by artificial intelligence: DECIDE-AI. BMJ. 2022;377:e070904. doi:10.1136/bmj-2022-070904.
[9] The STARD-AI reporting guideline for diagnostic accuracy studies using artificial intelligence. Nature Medicine. 2025;31:3283–3289. doi:10.1038/s41591-025-03953-8.
[10] Collins GS, Moons KGM, Dhiman P, et al. TRIPOD+AI statement: updated guidance for reporting clinical prediction models that use regression or machine learning methods. BMJ. 2024;385:e078378. doi:10.1136/bmj-2023-078378.
