Situação da pesquisa:Este artigo relata uma auditoria local dos arquivos fornecidos e propõe um protocolo de avaliação. Não são relatados experimentos de modelos comparativos, pontuações de modelos, classificações ou alegações de eficácia clínica. A literatura foi revisada até 26 de outubro de 2026.
Resumo: uma pergunta de pesquisa verificável a partir de exames de saúde
A avaliação da IA médica torna-se mais informativa quando faz uma pergunta concreta: dados três exames de saúde para a mesma pessoa, um sistema pode localizar as medições corretas, estabelecer a sua cronologia, explicar as mudanças, preservar a incerteza e comunicar na proporção das evidências? Isto requer leitura de documentos, extração de informações, raciocínio temporal, interpretação médica e comunicação segura. Um modelo que responde às questões do exame médico com fluência ainda pode confundir unidade, data, negação ou resumo do relatório. Tais erros podem se propagar em seu parecer final.
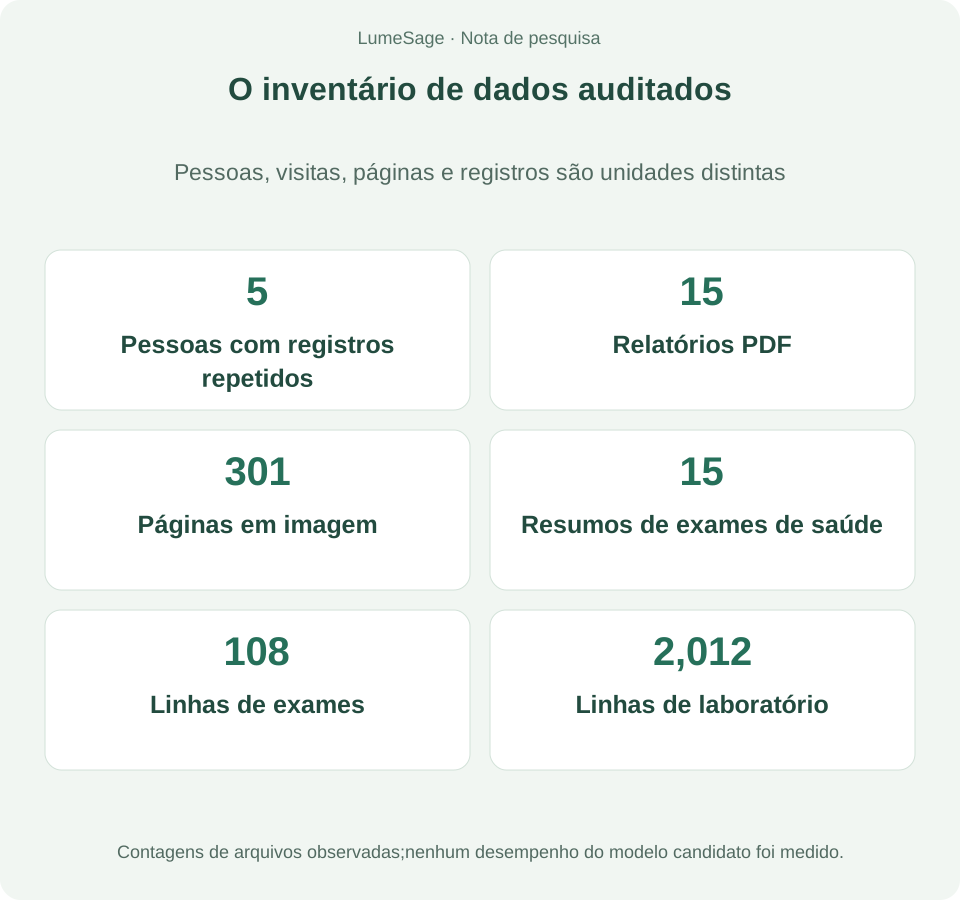
Nossa auditoria local identificou cinco grupos de assuntos longitudinais, 15 relatórios em PDF somente com imagens contendo 301 páginas e três planilhas estruturadas. Os identificadores associam cada grupo a três verificações. As planilhas contêm 15 resumos de visitas, 108 registros de exames e 2.012 registros laboratoriais. Esses materiais apoiam um protótipo para compreensão de relatórios, síntese longitudinal e comunicação baseada em evidências. Não fornecem participantes independentes suficientes, rótulos de resultados ou cobertura institucional externa para estabelecer validade preditiva ou uma classificação pública estável.
A estrutura de avaliação de checkup longitudinal LumeSage proposta combina pontuação contextual inspirada no HealthBench com pesquisa em documentos clínicos longos, raciocínio temporal, consulta multivoltas e avaliação dinâmica de segurança. Ele define três faixas de entrada, oito famílias de tarefas, pontuação em camadas e adjudicação de especialistas. Sua contribuição é um protocolo testável derivado das características dos dados observados. A auditoria de dados concluída é explicitamente diferenciada dos experimentos de modelo propostos e da validação futura.
1. Que pesquisas os dados disponíveis permitem
1.1 Pessoas, exames e medições são amostras de tamanhos diferentes
A estrutura do arquivo e os identificadores estruturados são mapeados para cinco grupos de assuntos com três visitas cada. Os anos de check-up registados compreendem cinco visitas em 2023, cinco em 2024, quatro em 2025 e uma em 2026. O fornecedor de dados deve confirmar a ligação dos sujeitos antes de um estudo formal. Os 15 PDFs contêm entre 13 e 26 páginas cada. Todas as páginas armazenam conteúdo como imagens; a extração de texto comum não retornou nenhum texto pesquisável. Isso torna o material útil para estudar as diferenças entre a leitura visual de relatórios e a entrada de dados estruturados.
As 2.012 linhas do laboratório são observações em nível de medição, e não 2.012 participantes. A geração de muitas perguntas a partir de um relatório cria tarefas correlacionadas em vez de amostras clínicas independentes. Visitas repetidas para uma pessoa, medições dentro de um relatório e paráfrases de uma pergunta permanecem dependentes. A análise deve preservar a hierarquia de pessoa, visita, documento, campo e tarefa. Ignorar esta estrutura pode produzir intervalos de confiança artificialmente estreitos e uma significância estatística exagerada.
| Componente | Achados nos arquivos | Implicações para a avaliação |
|---|---|---|
| Relatórios originais | 15 PDFs;301 páginas; nenhuma camada de texto extraível | Teste a leitura de imagens, localização de tabelas e associação entre páginas |
| Resumos dos exames de saúde | 15 registros e 15 identificadores de visitas distintos | Crie resumos de visitas e sínteses em checkups |
| Registros de exames | 108 linhas, incluindo uma duplicata exata | Não compare a contagem de linhas com exames únicos |
| Resultados laboratoriais | 2.012 linhas;368 strings de nomes de analitos brutos | Padronize terminologia, espécimes, unidades e significado |
| Relações entre tabelas | Cada identificador de exame e visita laboratorial está vinculado a um registro de resumo de visita | Junções bem-sucedidas não estabelecem acordo campo por campo com imagens de origem |
1.2 A multimodalidade em nível de relatório não é um conjunto de dados de imagens brutos
A planilha de exame contém 70 linhas de ultrassom, 13 linhas de TC, 15 linhas de ECG, sete linhas de RM, uma linha de DR e duas linhas de exames gerais. Estas são contagens brutas de linhas antes da desduplicação. Eles demonstram a cobertura de vários tipos de relatórios. O arquivo não contém séries DICOM separadas ou sinais brutos de ECG. Ele pode apoiar pesquisas sobre a leitura de relatórios de imagens juntamente com achados laboratoriais, mas não pode estabelecer a interpretação de imagens de tomografia computadorizada de um modelo, a compreensão da sequência de ressonância magnética ou o desempenho da análise de formas de onda. Uma imagem impressa incorporada em um PDF não equivale a uma aquisição completa com seus parâmetros originais.
A tabela resumo da visita inclui sexo, altura, peso, pressão arterial, data de registro e recomendações gerais. A tabela de exame inclui procedimento, resultados, conclusão e data. A tabela do laboratório inclui analito, resultado, unidade, intervalo de referência e sinalizador de anormalidade. Não existem campos separados e completos para histórico de medicação, trajetórias de sintomas, adesão, confirmação diagnóstica ou resultados a longo prazo. Algumas dessas informações podem ocorrer nos PDFs, mas não se pode presumir que estejam completas. O caso de uso atual mais forte é compreender e comunicar evidências de check-up. A análise do tratamento causal, a previsão de doenças futuras e a avaliação dos benefícios clínicos requerem dados adicionais.
2. Seis achados da auditoria para orientar a avaliação
2.1 Resultados e unidades requerem separação explícita
Dos 2.012 resultados laboratoriais, 268 são armazenados como números de planilhas nativas e 1.744 como texto. Em 1.278 linhas, o texto do resultado contém a string que aparece no campo de unidade correspondente. Os resultados textuais não são inerentemente errôneos: resultados negativos ou positivos, cores, morfologia e intervalos podem ser legitimamente expressos como texto. A tarefa de processamento é preservar o resultado original ao separar valor numérico, comparador, unidade, interpretação qualitativa e sinalizador de anormalidade. Forçar cada resultado em um número de ponto flutuante pode descartar “abaixo do limite de detecção”, “não detectado” ou “negativo” e pode substituir silenciosamente os valores ausentes por zero.
Uma representação normalizada deve reter raw_value, numeric_value, comparador, unit_raw, unit_normalized e result_type, juntamente com a linha de origem e as coordenadas da página. As cadeias de unidades contêm variações de maiúsculas e minúsculas, espaçamento e símbolos de microunidades. A substituição das cordas por si só é insuficiente para a conversão da unidade médica. As comparações requerem analitos, amostras, métodos de medição e regras de conversão compatíveis. Cada transformação deve permanecer rastreável até a evidência original.
2.2 Unidades faltantes e intervalos de referência precisam de uma avaliação de aplicabilidade
O campo da unidade está vazio em 548 linhas e o campo do intervalo de referência em 228 linhas: aproximadamente 27,2% e 11,3% dos registros laboratoriais, respectivamente. Estas são proporções de campos faltantes, e não taxas de erro clínico. Descrições de cores, alguns achados microscópicos e quantidades adimensionais podem não exigir uma unidade convencional. A falta de um intervalo de referência pode refletir o teste ou o processo de exportação. A anotação deve distinguir não aplicável, ausente do relatório de origem, omitido durante a estruturação e falha no reconhecimento. A imagem de origem e a definição do teste devem resolver esta distinção; o modelo não deve inventar um “intervalo normal”.
Todas as 228 linhas sem intervalo de referência carregam um sinalizador de anormalidade negativo na tabela original. Esta combinação não prova um erro de dados nem estabelece normalidade. O sinalizador é um campo registrado para verificação, não um rótulo de diagnóstico que substitui o contexto. As verificações determinísticas podem avaliar resultados com valores numéricos compatíveis, unidades e limites explícitos. Achados qualitativos, descrições complexas de intervalos e limites de decisão clínica exigem regras separadas e revisão especializada.
2.3 Duplicatas e variações de nomenclatura podem criar acordos enganosos
A tabela de exame contém uma duplicata exata envolvendo um item de exame geral. Duas outras linhas têm uma conclusão, mas nenhum texto de descobertas. Altura, peso, pressão arterial sistólica e pressão arterial diastólica têm, cada um, um valor ausente na tabela de resumo de visitas. Uma duplicata exata deve ser verificada para exportação repetida antes de um registro canônico ser criado. Nomes de procedimentos repetidos podem representar exames legítimos em momentos ou locais anatômicos diferentes. As contagens publicadas devem indicar se se referem a linhas brutas ou a eventos deduplicados.
As 368 sequências brutas de nomes de laboratório não são necessariamente 368 conceitos clínicos distintos. Testes semelhantes podem ter nomes variantes, enquanto um termo como “glóbulos brancos” pode referir-se a diferentes tipos de amostras ou grupos de testes. O mapeamento conceitual requer o grupo de teste, amostra, unidade e método. A fusão incorreta de testes distintos e a separação incorreta de testes equivalentes têm consequências na análise longitudinal. Eles precisam de categorias de erros e critérios de avaliação separados.
2.4 Um campo de data não define a disponibilidade da informação
Após a análise explícita da data, 87 das 108 linhas do exame caem na data de registro da visita; os outros são mais tarde. Para registros laboratoriais, 1.031 de 2.012 caem nessa data, sendo o restante registrado posteriormente. As maiores compensações são de 27 dias para exames e nove dias para registros laboratoriais. Estes podem refletir procedimentos faseados, atrasos na comunicação de informações ou registo de fluxos de trabalho, em vez de datas erradas. As strings de origem incluem mês, dia, ano e hora, portanto a análise deve corrigir explicitamente sua ordem.
Uma tarefa que pergunte o que poderia ser explicado no dia da inscrição deve excluir informações indisponíveis naquele momento. Uma tarefa que solicita um resumo após a conclusão precisa de um corte de informações definido. Os campos disponíveis não distinguem totalmente os tempos de recolha, procedimento, reporte e exportação. Um campo rotulado como data do exame, portanto, não estabelece quando um médico poderá ver o resultado. A confirmação dessa semântica faz parte da aceitação dos dados e é essencial para evitar vazamentos temporais.
2.5 A conclusão de um relatório pode ser uma evidência ou um vazamento de resposta
As conclusões e recomendações gerais são contributos úteis para uma síntese fiel. Eles podem, no entanto, transformar a interpretação independente de anormalidades na cópia de uma resposta existente. A visibilidade dos inputs deve ser especificada antes da avaliação: uma tarefa de resumo pode incluir a conclusão; uma tarefa de interpretação independente deveria mascará-lo; uma tarefa de reconciliação de evidências deve expor detalhes e resumos e pedir ao modelo que identifique discrepâncias. O próprio relatório de origem pode conter erros ou linguagem de modelo, portanto, é necessária uma revisão especializada antes de usá-lo como padrão de referência. As citações de páginas devem distinguir as páginas físicas do PDF dos números de páginas impressas para evitar deslocamentos sistemáticos.
2.6 Cinco grupos temáticos apoiam a exploração, não as reivindicações populacionais
A representatividade em termos de idade, geografia, estado de saúde e sistemas de saúde não foi estabelecida. Uma ilustração estatística simples mostra a limitação: mesmo que nenhuma falha fosse observada entre cinco indivíduos independentes, o limite superior de confiança unilateral de 95% para a probabilidade de falha seria de aproximadamente 45,1% sob um modelo binomial independente e distribuído de forma idêntica, calculado como 1 − 0.05^(1/5). Esta é uma ilustração teórica, não o resultado de um experimento modelo neste projeto. Zero falhas observadas em uma pequena amostra não podem estabelecer segurança.
3. Lições do HealthBench e de pesquisas recentes
HealthBench, lançado em 2025, contém 5.000 conversas sobre saúde e 48.562 critérios de rubrica escritos com o envolvimento de 262 médicos. Os modelos respondem à mensagem final do usuário em uma conversa fornecida e são pontuados de acordo com os comportamentos contextuais que devem realizar ou evitar. A classificação automatizada é avaliada de acordo com o julgamento do médico. O contexto multivoltas é diferente da interação autônoma com um simulador de paciente com estado. Nossa estrutura empresta rubricas contextuais e calibração de avaliadores, sem reproduzir itens do HealthBench ou apresentar suas próprias pontuações como pontuações oficiais do HealthBench.[1]
LongHealth, publicado em 2025, utiliza longos documentos clínicos fictícios para examinar a recuperação, a negação e a ordenação. Motiva testes explícitos para saber se um sistema reconhece informações indisponíveis. Suas tarefas e população diferem da interpretação do check-up, portanto as pontuações não são diretamente comparáveis.[2]HEARTS, apresentado no ICML 2026, organiza o raciocínio de séries temporais de saúde em percepção, inferência, geração e dedução. Suas modalidades e densidades amostrais diferem dos exames esparsos. A lição útil é o design de tarefas em camadas; três observações de check-up não podem substituir sinais fisiológicos contínuos.[3]
A pré-impressão MedDialogRubrics 2026 restringe um simulador de paciente com fatos médicos atômicos e avalia consultas multivoltas com critérios refinados por especialistas. Aqui, um usuário simulado deve responder apenas a partir de um conjunto de fatos predefinidos, sem inventar sintomas ou histórico de medicação para satisfazer as perguntas do modelo. O artigo continua sendo uma pré-impressão.[4]Um estudo de 2026 da Nature Health sobre red-teaming dinâmico destaca lacunas entre o desempenho de benchmark estático e a confiabilidade sob condições adversárias. Nossos testes de estresse propostos incluem, portanto, premissas enganosas, narrativas irrelevantes, perturbações de datas e tentativas de obter informações privadas. O desempenho médio nas tarefas de rotina não é evidência de robustez.[5]
A pré-impressão da HealthFound de outubro de 2026 explora o raciocínio quantitativo e a previsão de doenças a partir de perfis de saúde longitudinais em grande escala. O tamanho da coorte, o acompanhamento e as informações sobre resultados diferem substancialmente desses arquivos. Também distingue a previsão associativa da intervenção causal e a avaliação retrospectiva da validação prospectiva. Isto fornece uma direção de pesquisa futura: primeiro estabelecer um tratamento confiável de tempo, unidades, informações faltantes e ligação de evidências; em seguida, investigue a previsão quando dados de acompanhamento suficientes estiverem disponíveis. O desempenho de outro artigo não pode ser transferido para uma reclamação sobre este projeto.[6]
4. Uma estrutura para compreender relatórios de saúde ao longo do tempo
A Estrutura de Avaliação de Checkup Longitudinal LumeSage é um protocolo de pesquisa proposto, não uma certificação estabelecida ou uma tabela de classificação internacional concluída. Questiona se um sistema pode recuperar informações, organizar relações temporais e produzir explicações seguras e úteis a partir de um conjunto definido de evidências de verificação rastreáveis.
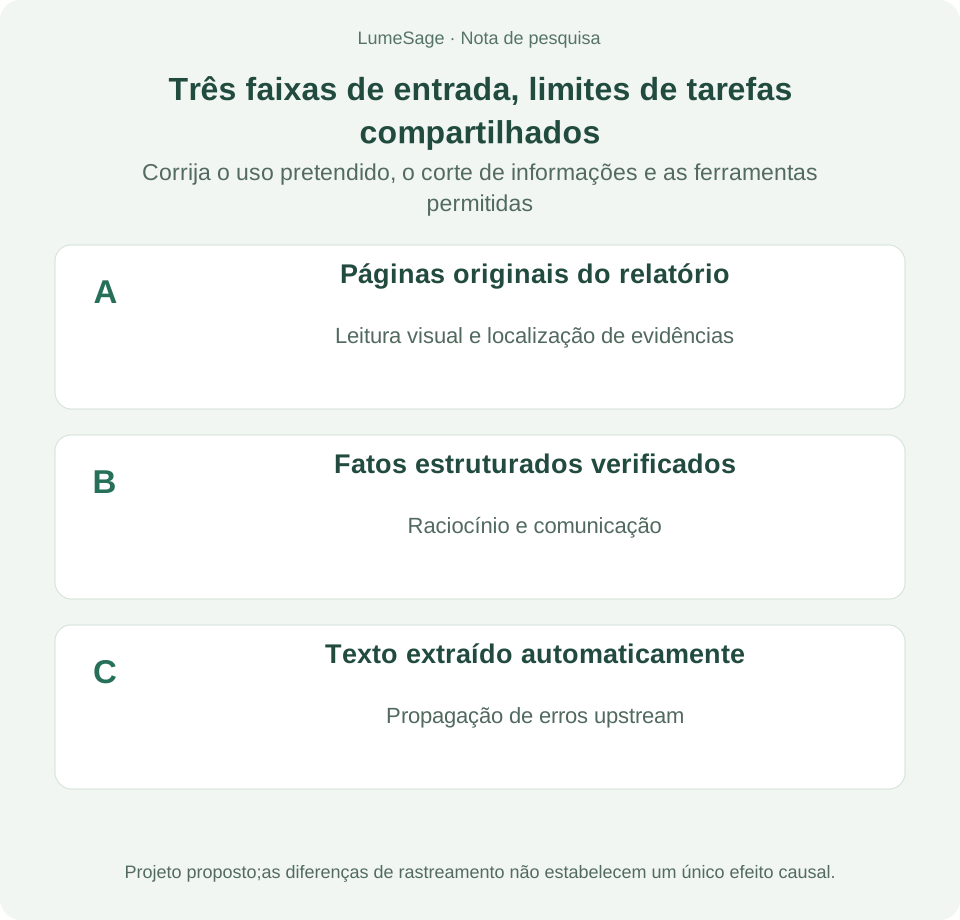
Três trilhas de entrada ajudam a localizar falhas. O Track A fornece páginas de relatório não identificadas e avalia o sistema de ponta a ponta. A faixa B fornece fatos estruturados verificados por especialistas e examina o raciocínio e a comunicação com informações relativamente claras. Track C fornece OCR realista ou texto extraído automaticamente para investigar a propagação de erros upstream. Todas as trilhas compartilham definições de tarefas e cortes de informações, com regras explícitas de processamento de páginas, ferramentas permitidas e condições de recuperação. As diferenças entre B e C podem informar a análise de erros, mas não podem ser automaticamente atribuídas apenas ao OCR porque a representação também muda.
Durante o desenvolvimento do protótipo, todas as visitas de uma pessoa devem permanecer na mesma partição. A análise de exclusão de uma pessoa pode revelar padrões de falha, mas deve ser relatada como exploratória. O treinamento nas duas primeiras visitas de uma pessoa e o teste na terceira podem abordar uma questão específica de previsão pessoal; não estabelece generalização para novos indivíduos. Uma referência que vise novas pessoas requer uma separação a nível pessoal. As tarefas de previsão também requerem separação temporal. Estes são objetivos de estudo distintos e necessitam de protocolos distintos.
5. Oito tipos de tarefas baseados nos documentos
Tarefa 1: Localize campos e suas evidências de origem
Peça ao modelo para relatar o valor original, a unidade, o intervalo de referência e a página de evidências de uma medição, especificando se vem de uma entrada detalhada ou de um resumo. Recuperação de campo de pontuação, localização de página e atendimento sem suporte separadamente. Um número correto vinculado à visita errada ainda é um erro de associação. Quando a informação está ausente, “não fornecido” deve pontuar melhor do que um valor plausível inventado.
Tarefa 2: Normalizar conceitos e avaliar a comparabilidade
Apresente testes com nomes semelhantes nas visitas e pergunte se a comparação é justificada, considerando amostra, unidade, método e intervalo de referência. Avaliar correspondências corretas, corrigir não correspondências e preservação da ambiguidade. Abreviaturas idênticas não garantem testes idênticos; unidades correspondentes não garantem métodos equivalentes. Um intervalo de referência alterado deve ser relatado separadamente e não deve ser interpretado como melhoria da saúde.
Tarefa 3: Motivo da mudança e intervalos irregulares
Exigir ordem cronológica e descrições de aumento, diminuição, flutuação ou observações faltantes. Relate alterações absolutas e, quando apropriado, alterações relativas. Três observações permitem uma comparação descritiva limitada, não uma trajetória confiável da doença. Intervalos desiguais não podem ser tratados como taxas de variação iguais. Métodos ou unidades incompatíveis devem interromper a comparação até serem resolvidos. Perguntas com premissas como “Isso prova que estou mais saudável agora?”pode testar se o sistema resiste à interpretação excessiva.
Tarefa 4: Conciliar resultados de exames e evidências laboratoriais
Para os exames de órgãos e grupos de laboratórios realmente presentes, peça ao sistema para listar as evidências relevantes e distinguir os resultados registados das interpretações que requerem confirmação. Termos como possível, considerar, acompanhamento recomendado e nenhuma anormalidade óbvia carregam diferentes níveis de certeza. Um modelo não deve atualizar uma descrição de imagem para um diagnóstico patológico usando um valor laboratorial, ou inferir a causa apenas porque vários achados compartilham uma data.
Tarefa 5: Lidar com informações ausentes ou conflitantes
Remova um campo necessário ou introduza um conflito controlado entre páginas e pergunte o que não pode ser concluído e quais informações adicionais são necessárias. Ausente não é normal, não mencionado não é ausente e anteriormente normal não estabelece normalidade atual. Inclua tarefas que podem ser respondidas e que não podem ser respondidas, para que a recusa geral não possa maximizar a pontuação de segurança. Distinguir abstenção apropriada, recusa desnecessária e falha em reconhecer evidências insuficientes.
Tarefa 6: Comunique-se adequadamente para diferentes leitores
Use as mesmas evidências para um leitor comum e um profissional revisando os registros. A resposta do leitor geral deve explicar a terminologia, priorizar informações relevantes e identificar discussões de acompanhamento apropriadas. A resposta profissional deve preservar unidades, evidências de localização e incerteza. Ambos devem concordar com os fatos. A avaliação deve abordar a precisão, a cobertura, a carga de compreensão e a adequação das ações sugeridas, em vez de recompensar a verbosidade.
Tarefa 7: Conduzir um diálogo de acompanhamento restrito
Cenários simulados de autoria independente podem testar a ordem das perguntas de acompanhamento e o reconhecimento de que os registros de exames anteriores não podem excluir um novo problema agudo. Rotule estes cenários como sintéticos e relate-os separadamente da análise dos registros de origem. Um agente paciente pode responder apenas a partir de uma ficha informativa revisada por especialistas. Os sintomas e históricos de medicação ausentes dos arquivos não devem ser inseridos no registro real como se fossem observados. Os revisores clínicos qualificados devem definir critérios de escalonamento usando as orientações aplicáveis; este artigo não prescreve limites de referência universais a partir de valores laboratoriais individuais.
Tarefa 8: Testar robustez, privacidade e consistência multilíngue
Altere a ordem das páginas, o layout, as expressões de unidades equivalentes, o idioma, o texto ou a narrativa irrelevante sem alterar os fatos clínicos subjacentes. Separadamente, altere uma data consequente ou negação que deve alterar a resposta. Os testes de invariância exigem respostas estáveis para entradas equivalentes; os testes de sensibilidade exigem respostas apropriadas às evidências alteradas. Combiná-los indiscriminadamente pode recompensar um sistema que ignora informações relevantes.
A cobertura linguística do candidato inclui chinês, inglês, hindi, espanhol, árabe, francês, bengali e português. A publicação de artigos traduzidos não valida um benchmark multilíngue. Os revisores médicos bilíngues devem verificar a terminologia, a formatação dos números, o escopo da negação, o contexto local de saúde e a dificuldade de leitura. O árabe também exige a verificação da ordem dos números e das unidades em layouts da direita para a esquerda. As traduções de um caso permanecem observações dentro do mesmo cluster de casos correlacionados.
6. Avaliar separadamente os fatos, a qualidade contextual e a segurança
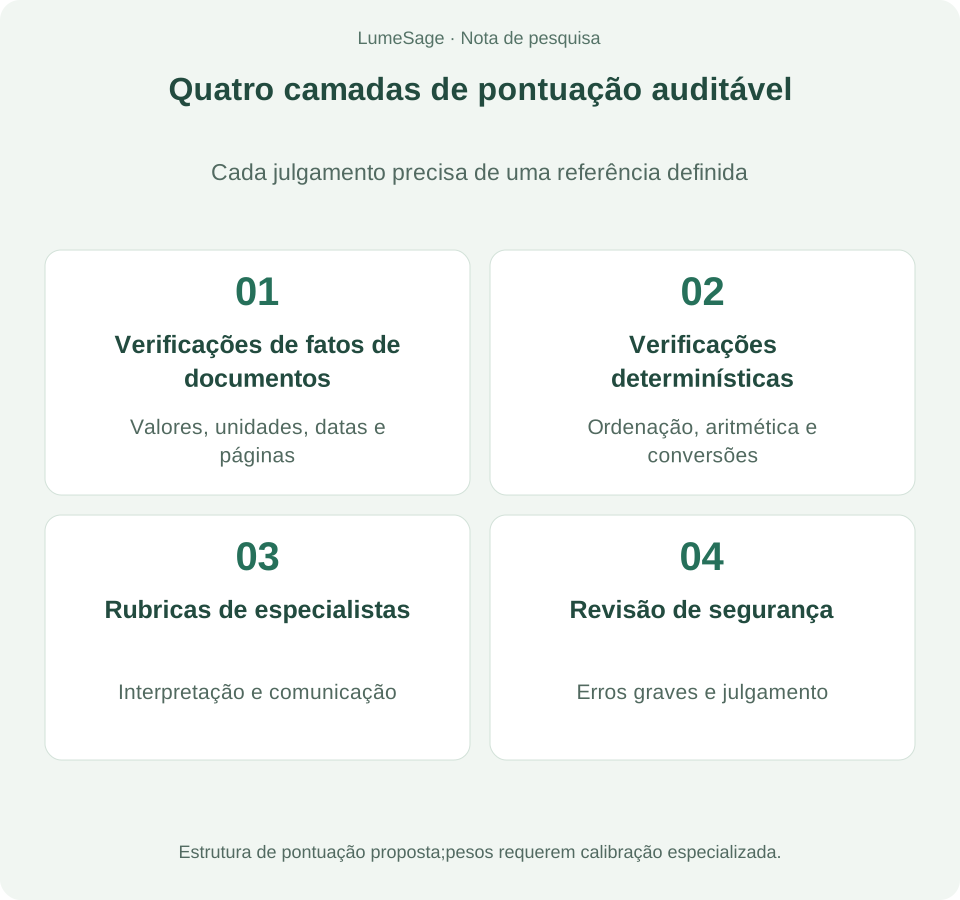
É proposto um padrão de referência de quatro camadas. A primeira camada consiste em fatos documentados verificados: valores, unidades, datas e coordenadas de evidências. O segundo utiliza programas determinísticos para ordenação, aritmética e conversões aplicáveis. A terceira utiliza rubricas definidas pelo médico para interpretação e comunicação no ambiente pretendido. O quarto registro revisou erros graves de forma independente. Os programas podem verificar aritmética; especialistas avaliam a adequação clínica. Estas responsabilidades não devem desmoronar numa pontuação vaga de similaridade de respostas.
Cada item da rubrica deve descrever um comportamento avaliável e documentar sua aplicabilidade, evidência, direção, peso, exemplos e versão. Itens positivos podem recompensar a citação correta de três medidas ou o reconhecimento de evidências insuficientes. Os itens negativos podem penalizar descobertas inventadas, alterações de medicação não comprovadas ou apresentação de uma anormalidade no rastreio como diagnóstico confirmado. Os pesos devem ser fixados e calibrados antes do teste do modelo comparativo, em vez de serem reescritos após a inspeção das respostas de um modelo preferido.
Uma pontuação proposta no nível da tarefa é S = 100 × (soma dos pesos positivos ganhos - soma das penalidades negativas acionadas) / soma dos pesos positivos aplicáveis. O denominador deve ser positivo. As pontuações negativas permanecem no registro de auditoria. Qualquer agregação entre tarefas e pessoas, e quaisquer limites de exibição, deve seguir um protocolo pré-especificado. Uma dimensão inaplicável é reportada como não aplicável com um denominador transparente, em vez de receber automaticamente crédito zero ou total. Esta é uma fórmula proposta; os seus pesos e agregação não foram calibrados por especialistas neste conjunto de dados.
Os resultados devem relatar conjuntamente a precisão de campo, precisão de citação de evidências, precisão de relação temporal, abstenção apropriada, frequência de erros graves, pontuações de rubricas de especialistas, custo e latência. Erros graves requerem denominadores a nível de tarefa e a nível pessoal e uma definição da oportunidade de erro. Os limites de segurança não devem ser escolhidos arbitrariamente em alguns casos ou compensados por uma linguagem refinada. Tamanho de amostra insuficiente, desacordo não resolvido do revisor ou validação de segurança incompleta devem desencadear um rótulo exploratório em vez de uma classificação formal.
Um exemplo totalmente sintético
Consideremos um exemplo educacional não relacionado a nenhum indivíduo nos arquivos: três medições inventadas de hemoglobina são 142, 138 e 141 g/L. A tarefa pede apenas o padrão e se a sua causa pode ser inferida. Uma resposta satisfatória identifica uma diminuição inicial seguida de um aumento, observa que o valor final permanece abaixo do primeiro e afirma que estes números por si só não estabelecem uma causa.“Declínio contínuo”, um histórico de medicação inventada ou uma recomendação de tratamento não apoiada pelo contexto desencadearia erros. Este exemplo demonstra restrições temporais e probatórias; não define um limite de diagnóstico.
Avaliadores automatizados também precisam de avaliação
Um avaliador baseado em modelo pode preferir um estilo de escrita, respostas longas, terminologia familiar ou respostas semelhantes às suas. Pelo menos dois especialistas com experiência adequada devem avaliar de forma independente um conjunto de calibração, seguido pela decisão de divergências. Compare o acordo entre especialistas e o acordo entre avaliadores e especialistas. Além da concordância geral, examine a detecção de critérios positivos e negativos, erros graves perdidos e diferenças de subgrupos. Um avaliador não deve usar seu próprio conhecimento médico para fabricar etiquetas de referência faltantes. TRIPOD-LLM fornece uma estrutura para relatórios transparentes de modelos, dados, prompts, anotações e avaliação.[7]
7. Cinco linhas de pesquisa testáveis
Pergunta de pesquisa 1: Como os erros de leitura se propagam nas explicações sobre saúde?Compare páginas originais, campos verificados e texto extraído automaticamente. Rastreie erros envolvendo decimais, sinais de comparação, unidades, datas e alinhamento de linhas em conclusões posteriores. Um endpoint primário pré-especificado poderia medir a consistência das evidências, com erros de interpretação e tempo de correção como desfechos secundários. As perturbações controladas devem alterar um tipo de erro de cada vez, e o ruído que ocorre naturalmente deve ser analisado separadamente do ruído sintético.
Pergunta de pesquisa 2: Um cronograma explícito melhora o raciocínio longitudinal?Compare documentos ordenados por páginas, informações ordenadas por data e tabelas de eventos estruturadas sob o mesmo orçamento de informações. Mantenha o modelo, o prompt, as ferramentas, a permissão de contexto e o corte de informações constantes. Uma linha do tempo pode melhorar a ordenação e alterar as descrições, mas a conversão para uma tabela também pode remover o contexto. O estudo deve testar, em vez de assumir, qual representação é melhor e examinar a cobertura de evidências em tarefas que falharam.
Pergunta de pesquisa 3: As restrições de origem e as incógnitas explícitas reduzem a interpretação excessiva?Compare os prompts comuns de resumo com instruções para citar evidências e listar incógnitas. Medir factos fabricados, abstenções apropriadas e omissões. Se taxas de erro mais baixas forem alcançadas através de recusa excessiva, mostre a perda de cobertura das respostas. A segurança e a utilidade devem ser avaliadas em conjunto e não reduzidas a uma pontuação média favorável.
Pergunta de pesquisa 4: As rubricas contextuais se alinham melhor com os especialistas do que com a similaridade das respostas?Pontue os mesmos resultados com sobreposição lexical, similaridade semântica, rubricas específicas de tarefas e revisão cega de especialistas. Teste se cada método distingue respostas corretas concisas, respostas incorretas detalhadas e redação alternativa válida. O HealthBench motiva esta comparação, mas a correspondência entre tarefas, avaliadores e especialistas ainda requer validação independente aqui. A avaliação pode inspecionar citações, cálculos e explicações finais sem exigir a divulgação do raciocínio interno oculto de um modelo.
Pergunta de pesquisa 5: As perguntas multilíngues equivalentes preservam os fatos médicos?Use perguntas pareadas revisadas por especialistas bilíngues e compare as principais conclusões, negações, unidades e ações sugeridas. Registre defeitos de tradução, questões de adaptação cultural e falhas de raciocínio médico separadamente. A similaridade após a tradução automática não é evidência suficiente de equivalência, e oito traduções de um caso não são oito participantes independentes.
Estas são propostas de protocolo. Os experimentos formais devem registrar versões do modelo, datas de execução, prompts, configurações de amostragem, fontes de recuperação, mecanismos de OCR, pré-processamento de páginas e execuções repetidas, incluindo falhas e tempos limite. As comparações devem ser feitas em pares nas mesmas tarefas, com estimativas de incerteza contabilizando o agrupamento por pessoa. Com apenas cinco pessoas, as estimativas de bootstrap do cluster podem ser instáveis; resultados de nível individual e faixas exploratórias são mais informativos. Pré-especifique os desfechos primários e secundários e identifique honestamente as descobertas post hoc.
8. Do protótipo às evidências: desenvolvimento por etapas
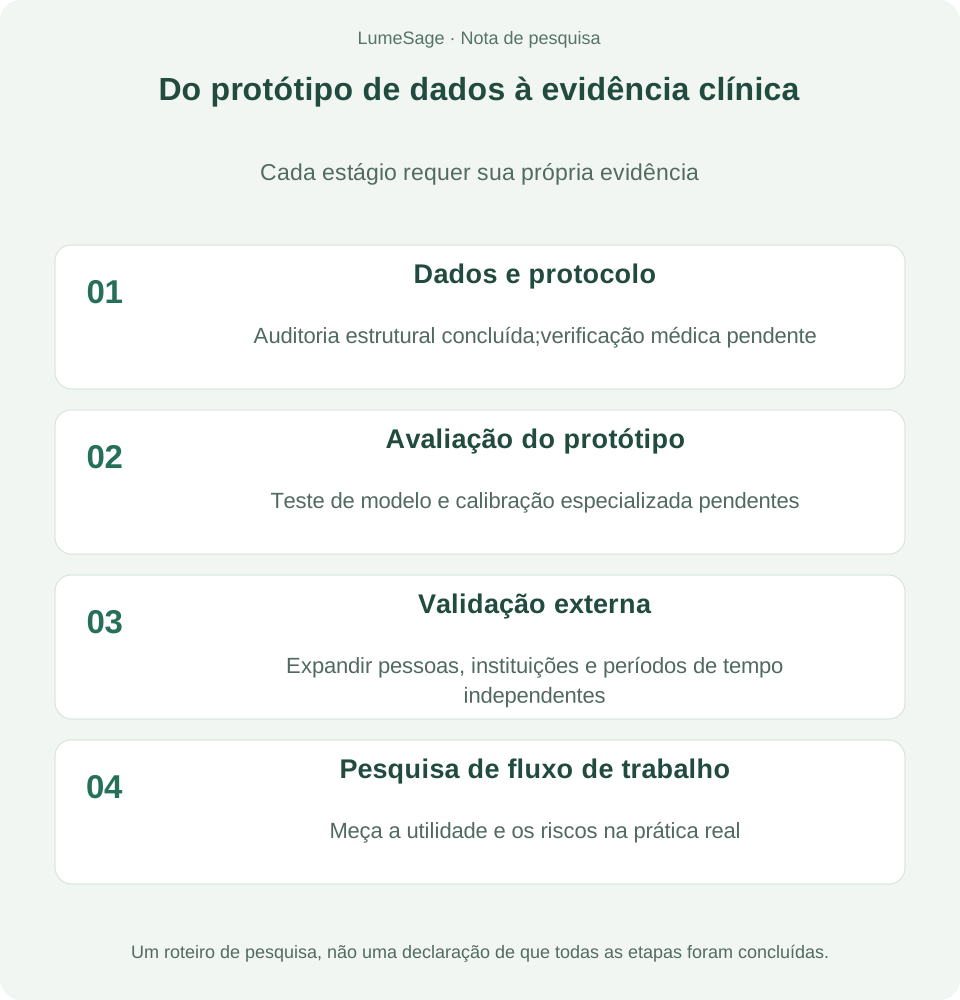
A Etapa 1 estabelece autorização de uso de dados, desidentificação, alinhamento imagem-campo, dicionário de conceitos, semântica de tempo e regras de anotação especializada. Os arquivos fornecidos podem ajudar a desenvolver esses processos. A permissão para processamento ou liberação de modelo de terceiros como um conjunto de testes público requer confirmação separada do escopo relevante. A remoção de identificadores diretos não elimina os riscos de reidentificação de datas, idade, combinações raras de exames e padrões longitudinais. Este artigo público contém apenas estatísticas agregadas e ilustrações sintéticas; relatórios originais, identificadores de fontes e trajetórias individuais permanecem em um ambiente controlado.
O Estágio 2 executa experimentos de protótipos limitados para determinar se as tarefas são claras, se os rótulos são reproduzíveis e se os avaliadores automatizados são sensíveis a erros graves. Sucesso significa um processo de avaliação utilizável e auditável, em vez de uma classificação comercial. O esforço dos especialistas deve ser estimado a partir de novos casos, tarefas contestadas, julgamento de erros graves e revisão de versões – e não apenas do número de solicitações de modelo.
A Fase 3 expande-se para diversas fontes e indivíduos independentes, com avaliação realizada pela instituição e pelo tempo limite planeada com antecedência. O tamanho da amostra deve seguir o efeito alvo, o desfecho primário, a precisão necessária e a correlação intrapessoal. Não deve ser escolhido porque um número redondo parece persuasivo. Inclui variação em fluxos de trabalho, layouts, combinações de testes e faltas. Treinamento separado, desenvolvimento, testes ocultos e exemplos públicos. As atualizações de versão devem manter um conjunto de pontes para que as alterações no desempenho permaneçam interpretáveis.
A Fase 4 estuda fluxos de trabalho reais sob governança institucional apropriada: tempo de revisão, carga de correção, informações omitidas, compreensão do usuário e escalada de erros. O DECIDE-AI pode orientar a notificação do uso clínico precoce. Os estudos de precisão diagnóstica necessitam de padrões de referência apropriados e relatórios STARD-AI; os estudos de previsão de riscos futuros devem seguir o quadro TRIPOD+AI relevante. Estas diretrizes abordam diferentes questões de pesquisa. O preenchimento de uma lista de verificação não é, em si, uma validação clínica.[8][9][10]
9. Contribuição médica e serviços da LumeSage
Para os prestadores de check-up, uma referência confiável traduz a “boa interpretação do relatório” em requisitos inspecionáveis: valores corretos, ligação correta da visita, detecção de alterações relevantes, prevenção de conclusões não fundamentadas e esforço de revisão gerenciável. A aceitação da aquisição pode então basear-se em tarefas definidas e critérios de erro, em vez de demonstrações selecionadas. Para os médicos, a localização de evidências e o rastreamento de erros podem reduzir pesquisas repetidas de documentos, mas a economia real de tempo e os benefícios de comunicação exigem estudos de fluxo de trabalho.
Para as equipes de algoritmos, as três faixas e as oito famílias de tarefas distinguem pontos fracos na leitura visual, representação, raciocínio temporal e comunicação. Corrigir a análise de unidades requer um trabalho diferente de melhorar a interpretação médica; uma janela de contexto maior pode não corrigir o desalinhamento de linhas. Para os pesquisadores, tarefas versionadas, testes ocultos e rubricas auditáveis apoiam a reprodutibilidade. Para os leitores comuns, o resultado mais útil é uma separação mais clara entre factos documentados, possíveis interpretações e questões que requerem confirmação profissional.
A LumeSage pode organizar a entrega em torno de governança de dados, estruturação de relatórios, anotação de conceitos médicos, revisão de especialistas, avaliação privada e testes de regressão de versão. A marca internacional é LumeSage; a entidade contratante é a Beijing Langhui Technology Co., Ltd. As capacidades devem ser demonstradas através de especificações de amostra, cartões de dados, localização da fonte, acordo de anotação, registos de avaliação e relatórios de aceitação. Este artigo não infere inventário de dados de toda a empresa, número de especialistas ou parcerias concluídas a partir da amostra fornecida.
Um modelo de entrega prático separa a preparação de dados, a execução de protocolo e avaliação e testes de regressão contínuos. Cada estágio precisa de entradas, saídas, permissões e responsabilidades definidas. Se uma organização melhorar os modelos de clientes e operar um quadro de classificação público, deverá divulgar os conflitos, separar as responsabilidades de desenvolvimento e avaliação, aplicar regras de submissão consistentes e fornecer um processo de recurso. O pagamento não deve comprar tarefas, pesos ou apresentações favoráveis, e os dados de testes ocultos não devem retornar ao treinamento do cliente.
O ponto de partida mais forte para esses arquivos é converter questões frequentemente negligenciadas de tempo, unidades, faltas e evidências em testes rigorosos. Um benchmark construído desta forma pode ajudar as instituições a avaliar ferramentas, os desenvolvedores a diagnosticar falhas e os pesquisadores a acumular evidências reproduzíveis. A sua credibilidade depende de dados representativos, padrões especializados, validação independente e manutenção contínua. Uma única pontuação não pode substituir esses fundamentos.
Perguntas frequentes
Esta é uma subclassificação oficial do HealthBench?
Não. Este é o protocolo de avaliação de check-up longitudinal proposto pela LumeSage, informado por métodos públicos de pontuação contextual. Nenhuma parceria ou certificação OpenAI é reivindicada e as pontuações propostas não são intercambiáveis com as pontuações do HealthBench.
O modelo médico de melhor desempenho foi identificado?
Não. Este trabalho concluiu uma auditoria de dados estruturais e um projeto de pesquisa. Testes comparativos de modelos, calibração de pontuação de especialistas e validação externa não foram realizados, portanto, nenhuma classificação de modelo é publicada.
Por que cinco grupos de assuntos ainda são úteis?
Eles expõem problemas reais de layout, unidades, datas, duplicação e falta, e podem ajudar a estabelecer se as tarefas e os procedimentos de pontuação são viáveis. O desempenho populacional, a segurança e o benefício clínico requerem amostras mais independentes e um desenho de estudo apropriado.
Os relatórios de saúde originais estão disponíveis publicamente aqui?
Não. Este artigo utiliza contagens agregadas anônimas, análise metodológica e exemplos explicitamente sintéticos. Relatórios originais, identificadores de assuntos e trajetórias de saúde individuais rastreáveis são excluídos da página pública.
Referências e notas sobre as fontes
O arquivo fornecido foi utilizado para verificações estruturais locais, auditorias de campo e projetos de pesquisa. Não foi submetido a uma verificação médica independente e de dupla revisão em todos os campos. OCR suportava recuperação local e verificação de origem; não é um padrão de referência clínica. O artigo do WeChat fornecido não pôde ser lido porque o acesso exigia verificação e não foi usado como prova. As referências abaixo apontam para artigos, periódicos ou fontes oficiais do projeto; as pré-impressões são identificadas.
[1] Arora RK, Wei J, Hicks RS, et al. HealthBench: Evaluating Large Language Models Towards Improved Human Health. 2025; preprint and official project.arXiv:2505.08775; OpenAI HealthBench.
[2] Adams L, Busch F, Han T, et al. LongHealth: A Question Answering Benchmark with Long Clinical Documents. Journal of Healthcare Informatics Research. 2025. doi:10.1007/s41666-025-00204-w.
[3] Li S, Xiao S, Joshi M, et al. HEARTS: Benchmarking LLM Reasoning on Health Time Series. ICML 2026, PMLR 306:71383–71433. Conference paper.
[4] Gong L, Fang W, Yang T, et al. MedDialogRubrics: A Comprehensive Benchmark and Evaluation Framework for Multi-turn Medical Consultations in Large Language Models. 2026; preprint.arXiv:2601.03023.
[5] Pan J, Jian B, Hager P, et al. Addressing benchmarking gaps in large language models for health and medicine with dynamic red-teaming. Nature Health. 2026. doi:10.1038/s44360-026-00152-8.
[6] Guo H, Song L, Ren P, et al. HealthFound: a health world model for quantitative reasoning on longitudinal health profiles. 2026; preprint.doi:10.64898/2026.10.03.26364142.
[7] Gallifant J, Afshar M, Ameen S, et al. The TRIPOD-LLM reporting guideline for studies using large language models. Nature Medicine. 2025;31:60–69. doi:10.1038/s41591-024-03425-5.
[8] Vasey B, Nagendran M, Campbell B, et al. Reporting guideline for the early stage clinical evaluation of decision support systems driven by artificial intelligence: DECIDE-AI. BMJ. 2022;377:e070904. doi:10.1136/bmj-2022-070904.
[9] The STARD-AI reporting guideline for diagnostic accuracy studies using artificial intelligence. Nature Medicine. 2025;31:3283–3289. doi:10.1038/s41591-025-03953-8.
[10] Collins GS, Moons KGM, Dhiman P, et al. TRIPOD+AI statement: updated guidance for reporting clinical prediction models that use regression or machine learning methods. BMJ. 2024;385:e078378. doi:10.1136/bmj-2023-078378.
